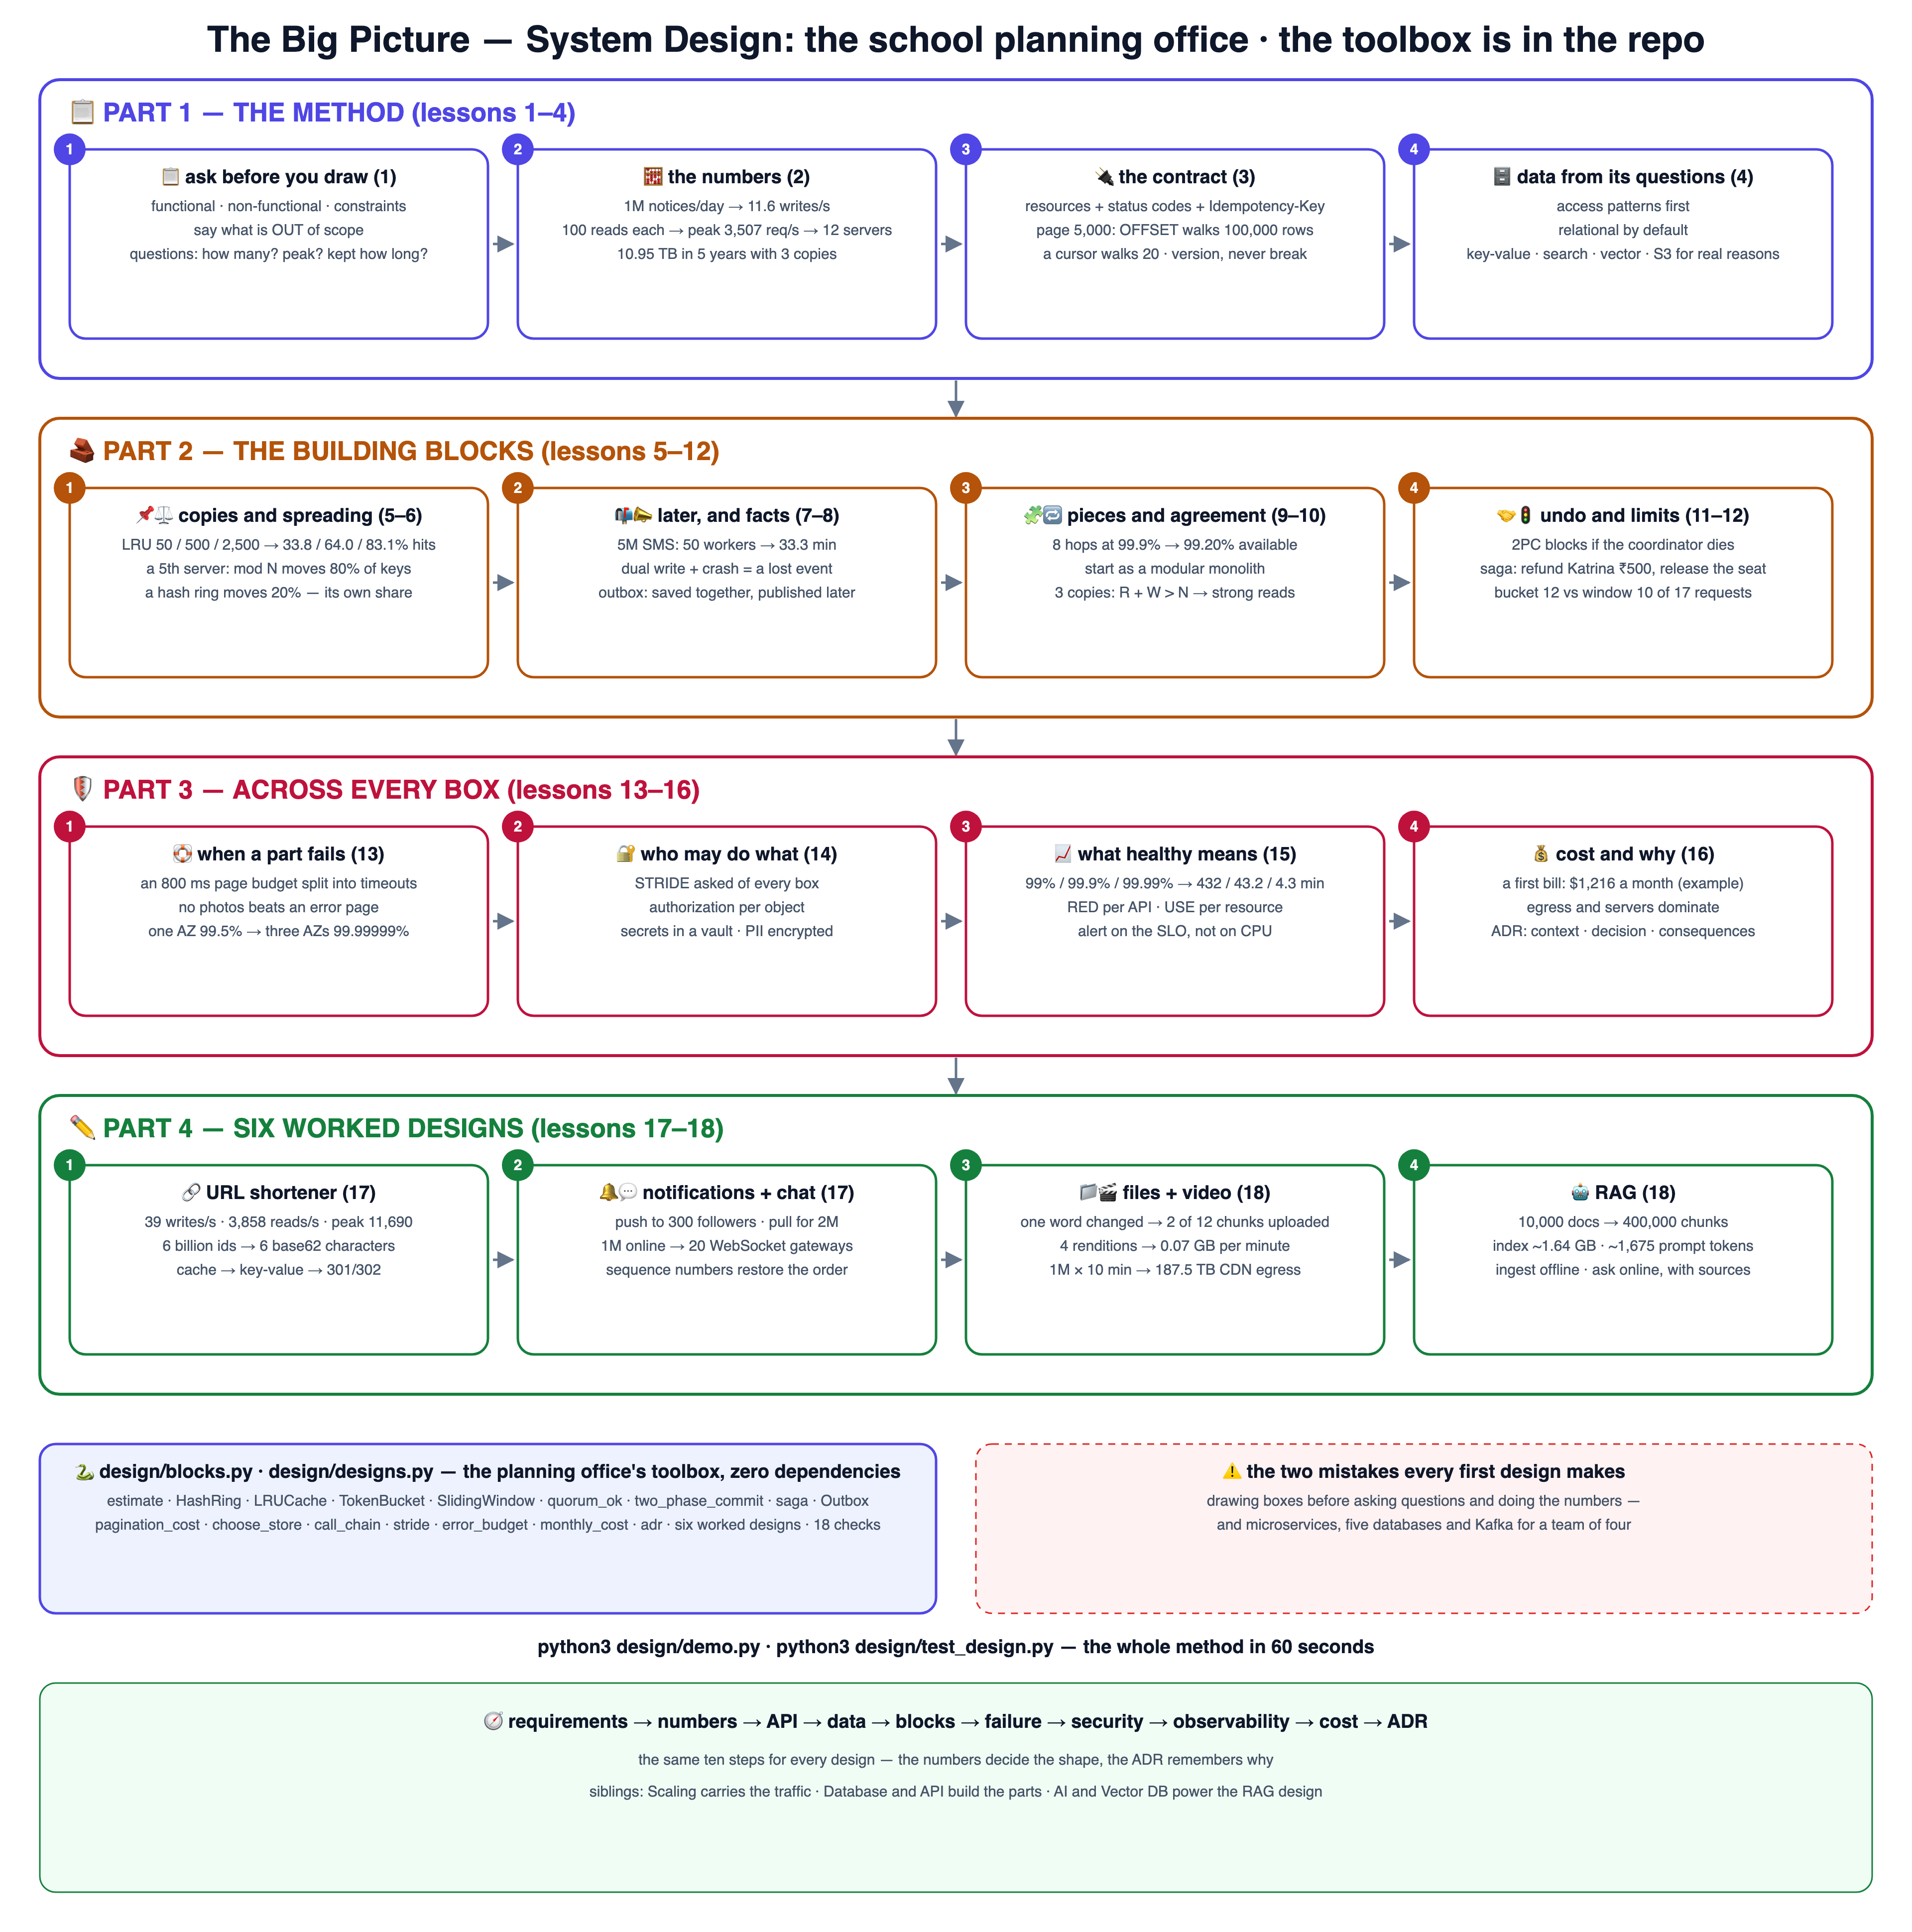
system बांधण्याआधी त्याची रचना कशी करायची, हे शाळेचे नियोजन कार्यालय म्हणून शिकवले आहे: काय हवे ते विचारा, आकडेमोड करा, करार (contract) काढा, stores निवडा, बांधणीचे ठोकळे जोडा, बिघाड, सुरक्षा, आरोग्य आणि खर्च यांचे नियोजन करा — आणि का, ते लिहून ठेवा. प्रत्येक धडा ही शाळेची एक गोष्ट आहे, सोबत काढलेली आकृती आणि एक lab — आणि कार्यालयाची साधनपेटी repo मध्येच आहे: शुद्ध Python मधली छोटी, प्रामाणिक models (design/blocks.py, design/designs.py, शून्य dependencies) जी अंदाज करतात, hash करतात, cache करतात, मर्यादा घालतात, मत देतात आणि भरपाई करतात.
📋 गरजा🧮 capacity🔌 API contract🗄️ data model📌 caching⚖️ consistent hashing📬 रांगा (queues)📣 events + outbox🧩 modular monolith🔁 quorums🤝 sagas🚦 rate limits🛟 resilience🔐 STRIDE📈 SLOs💰 खर्च + ADRs✏️ 6 सोडवलेल्या रचना
📋 भाग 1 — पद्धत (1–4)
काढण्याआधी विचारा 📋
आकार ठरवणारे आकडे 🧮
आधी करार (contract) 🔌
प्रश्नांवरून data 🗄️
🧱 भाग 2 — बांधणीचे ठोकळे (5–12)
प्रती, वाटणी आणि वाट पाहणे 📌⚖️📬
अनेक ऐकणारे असलेली तथ्ये 📣
एक deploy की अनेक 🧩
सहमती, उलटवणे आणि मर्यादा 🔁🤝🚦
🛡️ भाग 3 — प्रत्येक box मध्ये (13–16)
एखादा भाग बिघडतो तेव्हा 🛟
कोण काय करू शकतो 🔐
निरोगी म्हणजे काय 📈
खर्च किती आणि का 💰
✏️ भाग 4 — सोडवलेल्या रचना (17–18)
short links, सूचना, chat ✏️
files, video, AI search 🎬
# the 60-second wow — the planning office, live:
git clone https://github.com/BaluRaut/learn-system-design-school.git && cd learn-system-design-school
python3 design/demo.py             # 18 lessons: every estimate and every trade-off
python3 design/test_design.py      # 18 checks across the lessons
तुम्हाला काय दिसायला हवे (छाटलेले — यश असे दिसते):
═══ requirements ═══
── the brief: 'build a notice board app for 5 million parents'. Before drawing a box, write the sheet:
   functional     a teacher posts a notice to a class
                  a parent reads the notices of their children's classes
                  a parent gets a notification for urgent notices
   non-functional read p99 < 200 ms · post p99 < 500 ms
                  99.9% available
                  reads outnumber posts ~100 : 1
                  a notice must never be lost once 'posted' is shown
   constraints    team of 4 · AWS · Marathi + English
                  budget: a few thousand dollars a month
                  launch in 3 months
   out of scope (say it!): chat, payments, video · questions to ask: how many schools? peak time? data kept how long?

═══ capacity ═══
── 5M parents · 1M notices a day across all schools · 100 reads per notice · 2 KB each · peak ×3 · 5 years · 3 copies
   writes_per_s   11.6
   reads_per_s    1157.4
   avg_rps        1169
   peak_rps       3507
   servers        12
   storage_tb     10.95
   egress_mb_s    7.0
   rules of thumb: a day ≈ 86,400 s ≈ 10^5 · 1M/day ≈ 12/s · 2 KB × 1M = 2.0 GB
   the answer is a SHAPE, not a digit: tiny writes, heavy reads, ~11 TB in 5 years → cache the reads; one database cluster is enough

═══ api ═══
── the contract first — resources, not actions:
   POST /classes/3A/notices          body {title, text, urgent} · header Idempotency-Key → 201 + Location
   GET  /classes/3A/notices?limit=20&cursor=eyJpZCI6OTB9 → 200 {items, next_cursor}
   GET  /parents/me/feed?limit=20   → the notices of all my children's classes
   errors: 400 bad input · 401 who are you · 403 not your class · 404 · 409 key reused with a different body · 429 slow down
── pagination: rows the database walks to show page N (20 per page)
   page     1: OFFSET walks      20 rows · a cursor walks  20
   page    50: OFFSET walks   1,000 rows · a cursor walks  20
   page  5000: OFFSET walks 100,000 rows · a cursor walks  20
   version in the path (/v1) or a header; never break a published field — add new ones

═══ data ═══
── model the data from the questions you will ask it (access patterns), then pick the store
   joins, transactions          → relational (PostgreSQL / Aurora)
   huge-scale, key-lookup       → key-value / wide-column (DynamoDB / Cassandra)
   search                       → search engine (OpenSearch)
   similarity                   → vector index (pgvector / OpenSearch k-NN)
   files                        → object storage (S3)
   (nothing special)            → relational (PostgreSQL) — the safe default until an access pattern says otherwise
   notice board: notices(id, class_id, author, title, text, urgent, created_at) · index (class_id, created_at DESC)
   one table, one index, one question answered fast — add stores only when a new access pattern needs one

═══ cache ═══
── 20,000 feed reads over 5,000 classes (a few classes are very popular) through an LRU cache
   cache holds    50 classes (1% of them) → hit ratio  33.8%
   cache holds   500 classes (10% of them) → hit ratio  64.0%
   cache holds  2500 classes (50% of them) → hit ratio  83.1%
   a cache holding 1% of the classes already catches a third of the reads — sizing is a curve, measure it
   where: browser · CDN · API (Redis) · database buffer · invalidate on write or use a short TTL

═══ balance ═══
── 10,000 classes on 4 cache servers; a 5th server joins
   hash % N         → 8,001 keys move (80%)
   consistent hash  → 1,975 keys move (20%) — about 1/5, only the new server's share
   keys per server with 100 virtual nodes each: {'s0': 1883, 's1': 2016, 's2': 1989, 's3': 2137, 's4': 1975}
   load balancers: L4 (TCP, fast) vs L7 (HTTP paths, headers) · health checks · round robin / least connections

═══ queues ═══
── 'send 5M urgent SMS' must not run inside the request
   request: save the notice, put ONE job on a queue, answer 201 in ~50 ms
   workers: take jobs, send in batches of 500, retry with backoff, park failures in a DLQ
    10 workers × 50 SMS/s → all 5M sent in  166.7 min
    50 workers × 50 SMS/s → all 5M sent in   33.3 min
   200 workers × 50 SMS/s → all 5M sent in    8.3 min
   queues decouple speed: the request is fast, the work is as fast as you pay for · delivery is at-least-once

═══ events ═══
── 'NoticePosted' is one event; many services react (email, SMS, search index, analytics) — pub/sub
   dual write, crash between DB and broker = False → ('notice saved', 'NoticePosted')
   dual write, crash between DB and broker = True  → ('notice saved', None)
   outbox, crash before publishing → saved (event waits in the outbox) · relay runs later → saved + published [('NoticePosted', 'N-1')]
   fan-out push: a class with 40 parents, parents follow 3 classes, 5 posts/day, 400 reads/day → {'writes': 200, 'read_lookups': 400}
   fan-out pull: a class with 40 parents, parents follow 3 classes, 5 posts/day, 400 reads/day → {'writes': 5, 'read_lookups': 1200}
   events are facts in the past tense; consumers must be idempotent (the same event may arrive twice)

═══ services ═══
── one request that calls services in a line (each 20 ms, each 99.9% available)
   1 hops →  20 ms, availability 99.90%
   3 hops →  60 ms, availability 99.70%
   8 hops → 160 ms, availability 99.20%
   start as a MODULAR MONOLITH: one deploy, clear modules; split a service out when a team or a scaling need asks
   a 'distributed monolith' = many services that must deploy together — all the cost, none of the benefit

═══ consistency ═══
── 3 copies (N=3): which read/write sizes are sure to see the latest write? (R + W > N)
   R=1 W=1 → eventual: may read a stale copy
   R=1 W=3 → strong: overlaps
   R=2 W=2 → strong: overlaps
   R=3 W=1 → strong: overlaps
   copies [(7, 'exam on Monday'), (8, 'exam moved to Tuesday'), (7, 'exam on Monday')] · read R=1 → 'exam on Monday' · read R=2 → 'exam moved to Tuesday'
   CAP: during a network split you choose — answer (maybe stale) or refuse (stay correct)
   most apps: strong for money and grades, eventual for likes and view counts

═══ transactions ═══
── a school-trip booking touches 3 services: seats, payment, bus
   2PC, all vote yes → COMMIT · one votes no → ABORT
   2PC, the coordinator dies after 'prepare' → BLOCKED — participants hold locks until the coordinator returns
   saga, the bus is full → COMPENSATED: ✓ reserve seat · ✓ charge Katrina ₹500 · ✗ book the bus · ↩ refund Katrina ₹500 · ↩ release seat
   sagas trade 'all at once' for 'eventually consistent, with an undo for every step'

═══ ratelimit ═══
── one parent's app sends 12 requests at t=0 s and 5 more at t=0.5 s
   token bucket (5/s, burst 10) → 12 of 17 allowed · sliding window (10 per 1 s) → 10 of 17
   the bucket refilled 2.5 tokens in 0.5 s, so 2 more got in; the window still counts the first 10 until t=1.0 s
   token bucket: smooth rate + a burst allowance · window: a hard count per period
   limit per user, per API key and globally; answer 429 with Retry-After; keep the counters in Redis

═══ resilience ═══
── the budget for one page is 800 ms; each dependency gets a timeout inside it
   auth           timeout  50 ms
   notices DB     timeout 150 ms
   photo service  timeout 300 ms
   photo service down → show notices without photos (degrade), breaker open, retries with jitter
   one AZ 99.5% → three AZs 99.99999% · deeper dive: the Scaling school, lesson 13

═══ security ═══
── STRIDE, asked of every box on the diagram (here: the notice API)
   Spoofing                 notice API: who is really calling? → authentication (OIDC, mTLS, signed requests)
   Tampering                notice API: was it changed on the way or at rest? → TLS, signatures, checksums, least-privilege writes
   Repudiation              notice API: can someone deny doing it? → audit logs they cannot edit (CloudTrail, append-only)
   Information disclosure   notice API: who can read it? → encryption, authorization per object, no secrets in logs
   Denial of service        notice API: can it be flooded? → rate limits, WAF, quotas, autoscaling with a ceiling
   Elevation of privilege   notice API: can a user become an admin? → least privilege, input validation, isolation
   plus: parents see only their children's classes (authorization per object), PII encrypted, secrets in a vault

═══ observability ═══
── decide what 'healthy' means BEFORE launch
   SLO 99.00% → error budget  432.0 minutes per 30 days
   SLO 99.90% → error budget   43.2 minutes per 30 days
   SLO 99.99% → error budget    4.3 minutes per 30 days
   RED per API (Rate, Errors, Duration) · USE per resource (Utilisation, Saturation, Errors)
   logs with a request id · metrics for alerts · traces across services · alert on the SLO, not on CPU

═══ cost ═══
── a first bill for the notice board (example prices)
   servers   $   360.00
   storage   $    46.00
   egress    $   450.00
   requests  $   360.00
   total     $ 1,216.00
── the decision, written down:
   # ADR 001: Cache the class feed in Redis

   Status: Accepted

   ## Context
   Reads are 100x writes; p99 must stay under 200 ms at 3x peak.

   ## Decision
   Cache-aside per class, TTL 60 s, delete on post.

   ## Consequences
   - ~80% of reads skip the database (lesson 05's curve)
   - a notice can be up to 60 s late for some readers
   - one more thing to run

═══ designs1 ═══
── URL shortener: 100M new links/month, 100 reads each → 39 writes/s, 3,858 reads/s, peak 11,690 req/s
   6,000,000,000 ids in 5 years → base62 needs 6 characters (62^6 ≈ 56.8 billion) · the last one, id 5,999,999,999 → '6y3o5x'
   read path: cache → key-value store → 301/302 redirect · write path: id generator → store
── notifications: an author with       300 followers posts 3 times → {'mode': 'push on write', 'inbox_writes_per_day': 900}
── notifications: an author with 2,000,000 followers posts 3 times → {'mode': 'pull on read (celebrity)', 'inbox_writes_per_day': 0}
── chat: 1M online, 50k WebSocket connections per server → 20 gateway servers · 463 msg/s · 8.0 GB/day
   arrival order ['see you', 'hi', 'hello'] → by sequence number ['hi', 'hello', 'see you']

═══ designs2 ═══
── file storage: a file split into chunks by content hash; one word changed → upload 2 of 12 chunks
   metadata (who, which chunks, which version) in a database · chunks in object storage · dedupe for free
── video: one uploaded minute becomes 4 renditions (1080p, 720p, 480p, 240p) → 0.07 GB per minute stored
   1M views × 10 minutes at 2.5 Mb/s → 187.5 TB from the CDN — egress, not storage, is the bill
── RAG over 10,000 school documents × 20 pages → 400,000 chunks · vector index ~1.64 GB · ~1675 prompt tokens per question
   ingest (chunk → embed → index) runs offline; ask (embed question → top-5 → prompt → answer with sources) runs online
── the method, every time: requirements → numbers → API → data → blocks → failure → security → observability → cost → ADR

✅ done — the planning office signed off
🎒 धडा 01 च्या आधी: तुम्हाला Python 3 हवे — बाकी काहीही नाही. हा lab म्हणजे गोल उदाहरण-आकड्यांसह शिकवण्यासाठीची models आहेत; आकड्यांपेक्षा पद्धत जास्त महत्त्वाची. ही शाळा बाकीच्या शाळांना जोडते: अधिक खोलात जा — Scaling, Database, API, API Gateway आणि AI.
एक git branch = एक कल्पना; branch 04 मध्ये धडे 01–04 आहेत. प्रत्येक आकडा design/ मधून येतो — cloud account लागत नाही.
1
📋 गरजा आणि मर्यादा
नियोजन कार्यालय काढण्याआधी विचारते — functional, non-functional, मर्यादा (constraints), आणि काय कक्षेबाहेर आहे.lesson-01-requirementsधडा वाचा →आकृती पहा ↗
2
🧮 Capacity चा अंदाज
रचनेचा आकार ठरवणारे कच्चे (back-of-the-envelope) आकडे — users → requests/s → peak → storage → servers.lesson-02-capacityधडा वाचा →आकृती पहा ↗
3
🔌 API design
आधी करार (contract) — resources, status codes, idempotency keys, cursor pagination आणि versioning.lesson-03-api-designधडा वाचा →आकृती पहा ↗
4
🗄️ Data model आणि database ची निवड
तुम्ही जे प्रश्न विचाराल त्यांचे model करा, मग store निवडा — मूलतः relational, इतर खऱ्या कारणांसाठीच.lesson-04-data-modelधडा वाचा →आकृती पहा ↗
🧱 भाग 2 — बांधणीचे ठोकळे (धडे 5–12)
जवळजवळ प्रत्येक रचना ज्या तुकड्यांपासून बनते ते — प्रत्येकासोबत तो कधी लागतो हे सांगणारा एक आकडा.
5
📌 Caching
प्रती कुठे ठेवायच्या, किती मोठ्या, किती काळ — hit-ratio वक्र आणि काय invalidate करायचे.lesson-05-cachingधडा वाचा →आकृती पहा ↗
6
⚖️ Load balancing + consistent hashing
पाहुणे आणि keys पसरवा — L4 vs L7, health checks, आणि असा ring जिथे server जोडल्यावर फक्त त्याचा वाटा हलतो.lesson-06-load-balancingधडा वाचा →आकृती पहा ↗
7
📬 रांगा (queues) आणि async काम
पटकन उत्तर द्या, सावकाश काम नंतर करा — jobs, workers, retries, DLQs आणि at-least-once delivery.lesson-07-queuesधडा वाचा →आकृती पहा ↗
8
📣 Events, pub/sub आणि outbox
एक तथ्य, अनेक ऐकणारे — pub/sub, fan-out on write vs read, आणि DB व broker यांच्यामध्ये कधीही event (घटना) न गमावणे.lesson-08-eventsधडा वाचा →आकृती पहा ↗
9
🧩 Monolith vs microservices
modular monolith ने सुरुवात करा — प्रत्येक जास्तीच्या hop ची किंमत latency आणि availability मध्ये का मोजावी लागते, आणि कधी विभागायचे.lesson-09-servicesधडा वाचा →आकृती पहा ↗
10
🔁 Consistency (सुसंगती)
Strong की eventual — replicas, quorums (R + W > N), read-your-writes आणि फूट पडल्यावर CAP ची निवड.lesson-10-consistencyधडा वाचा →आकृती पहा ↗
11
🤝 Services ओलांडून transactions
services ओलांडून सगळे किंवा काहीच नाही — two-phase commit आणि ते का अडकते, compensations सह sagas.lesson-11-distributed-transactionsधडा वाचा →आकृती पहा ↗
12
🚦 Rate limiting
कार्यालयाला लोंढ्यांपासून वाचवा — token bucket vs sliding window, प्रति user, प्रति key, जागतिक पातळीवर.lesson-12-rate-limitingधडा वाचा →आकृती पहा ↗
🛡️ भाग 3 — प्रत्येक box मध्ये (धडे 13–16)
आकृतीतील प्रत्येक box ला विचारायचे प्रश्न, फक्त एकालाच नव्हे.
13
🛟 रचनेतूनच resilience
प्रत्येक dependency बिघडते — timeout budgets, jitter सह retries, breakers, degradation, multi-AZ.lesson-13-resilienceधडा वाचा →आकृती पहा ↗
14
🔐 रचनेतूनच सुरक्षा
प्रत्येक box ला STRIDE विचारा — identity, प्रत्येक object साठी authorization, encryption, secrets, गैरवापर.lesson-14-securityधडा वाचा →आकृती पहा ↗
15
📈 रचनेतूनच observability
launch आधीच निरोगी म्हणजे काय ते ठरवा — SLOs, error budgets, RED आणि USE, logs, metrics, traces.lesson-15-observabilityधडा वाचा →आकृती पहा ↗
16
💰 खर्च, देवाणघेवाण (trade-offs) आणि ADRs
प्रत्येक box ला एक बिल आणि एक कारण असते — पहिले cost model आणि एका पानाची निर्णयाची नोंद (ADR).lesson-16-cost-and-adrsधडा वाचा →आकृती पहा ↗
✏️ भाग 4 — सोडवलेल्या रचना (धडे 17–18)
पद्धत, सुरुवातीपासून शेवटपर्यंत सहा वेळा वापरलेली — आकडे आकार ठरवतात.
तीन क्लासिक रचना, त्यांना आकार देणारे आकडे — short ids, fan-out, connections आणि ordering.lesson-17-designs-short-notify-chatधडा वाचा →आकृती पहा ↗
18
🎬 सोडवलेल्या रचना: file storage · video · RAG
तीन जड रचना — chunks आणि dedupe, renditions आणि CDN egress, AI search साठी ingest vs ask.lesson-18-designs-files-video-ragधडा वाचा →आकृती पहा ↗
🗣️ मोठ्याने समजावून सांगा — धडा 18 नंतर: (1) काहीही काढण्याआधी तुम्ही कोणते तीन प्रश्न विचारता? (2) दिवसाला 1M writes — साधारण प्रति second किती? (3) page 5,000 वर cursor हा OFFSET पेक्षा का सरस ठरतो? (4) consistent hashing फक्त ~1/N keys च का हलवते? (5) database आणि broker यांच्यामध्ये event कसा हरवू शकतो, आणि ते काय थांबवते? (6) 3 प्रतींसह कोणते R आणि W strong reads देतात? (7) 2PC का अडकते, आणि त्याऐवजी saga काय करते? (8) 99.9% SLO महिन्याला किती मिनिटांचा बिघाड चालवून घेतो?
🎓 याच शाळेतून:Scaling · Database · API · DSA · AI — तेच उपमा-विश्व, तीच branch-दर-branch पद्धत.
📐 धड्यांच्या आकृत्या — क्रमांक अनुसरा
प्रत्येक धडा एका क्रमांकित बॉक्स-आणि-बाण आकृतीत — स्वतंत्र पानावरही.
1 📋 गरजा आणि मर्यादा
नियोजन कार्यालय काढण्याआधी विचारते — functional, non-functional, मर्यादा (constraints), आणि काय कक्षेबाहेर आहे.
🧒 सोप्या शब्दांत
शाळा सांगते: 5 million पालकांसाठी सूचना फलक app बनवा. Dipika अजून काहीच काढत नाही. आधी ती विचारते: काय करायचे, किती जलद हवे, आणि मर्यादा काय. आपण काय बनवणार नाही, जसे chat, तेही ती लिहिते. आता सगळे एकच गोष्ट आखतात.
📖 नवे शब्दfunctional — app ने काय करायचे: शिक्षिका post करते, पालक वाचतात, तातडीच्या सूचनांची notificationnon-functional — ते किती चांगले चालायला हवे: read p99 < 200 ms, 99.9% availableconstraints — ठरलेल्या मर्यादा: 4 जणांची team, AWS, मराठी + English, 3 महिन्यांत launchout of scope — आत्ता काय बनवणार नाही, मोठ्याने सांगितलेले: chat, payments, video
⏪ आधी
Teams नी 'सूचना फलक app बनवा' ऐकले आणि लगेच boxes काढले, मग खऱ्या गरजा launch नंतर कळल्या.
💡 काय
गरजा म्हणजे नियोजन कार्यालय आधी विचारते: काय करायचे, किती चांगले, कोणत्या मर्यादेत, आणि काय बाहेर ठेवायचे.
शाळेच्या कार्यक्रमासाठी खुर्च्या आणण्याआधी पाहुणे मोजतात. Dipika app साठी तेच गणित करते. दिवसाला 1 million सूचना म्हणजे सेकंदाला सुमारे 12. Reads 100 पट जास्त, आणि गर्दीचा तास नेहमीच्या 3 पट. म्हणून ती सेकंदाला 3,507 requests आणि 12 servers साठी योजना करते.
📖 नवे शब्दestimate — कागदावरचा ढोबळ अंदाज, आकार निवडायला पुरेसाpeak — सर्वात गर्दीचा क्षण; इथे सरासरीच्या 3 पट, 3,507 req/sstorage — किती data साठतो: 2 KB × दिवसाला 1M × 5 वर्षे × 3 प्रती = 10.95 TB10^5 — एक दिवस 86,400 s, म्हणजे सुमारे 10^5 सेकंद: दिवसाला 1M ≈ सेकंदाला 12
⏪ आधी
योजनांत 'खूप पालक' एवढेच लिहिलेले असे आणि machines अंदाजाने ठरत, म्हणून काही लहान पडत आणि काही खूप महाग.
💡 काय
Capacity अंदाज म्हणजे कार्यालयाचे कागदावरचे ढोबळ गणित: पालक ते requests, peak, storage आणि servers.
⚙️ कसे
दिवसाला 1M सूचना म्हणजे 11.6 writes/s आणि 1,157 reads/s; peak ×3 ला 3,507 req/s, 12 servers; 5 वर्षांत 10.95 TB.
🎯 का
आकडे आकार दाखवतात: writes लहान, reads जड, म्हणून reads cache करा आणि एक database cluster पुरेसा आहे.
🚀 पुढे
पुढचा धडा आधी करार लिहितो: resources, status codes, idempotency keys आणि cursor pagination.
🧪 इथे करून पाहा — envelope calculator — blocks.py मधील estimate(); slider हलवा आणि आकार बदलताना पाहा
आधी करार (contract) — resources, status codes, idempotency keys, cursor pagination आणि versioning.
🧒 सोप्या शब्दांत
Canteen उघडण्याआधी कार्यालय सगळ्यांसाठी एकच मागणी-फॉर्म छापते. App आणि server आधी त्याच फॉर्मवर सहमत होतात. शिक्षिकेने post दोनदा दाबले तरी फॉर्मवरची key दुहेरी सूचना थांबवते. मोठ्या यादीसाठी पुन्हा page 1 पासून मोजण्याऐवजी bookmark ठेवायचा.
📖 नवे शब्दresource — पत्ता असलेली गोष्ट, जसे /classes/3A/noticesstatus code — छोटा उत्तर-क्रमांक: 201 created, 403 तुमचा वर्ग नाही, 429 हळूIdempotency-Key — request वरचे तिकीट, म्हणजे retry मुळे सूचना कधी दोनदा लागत नाहीcursor — bookmark: page 5,000 ला 20 rows, OFFSET सारख्या 100,000 नाहीत
⏪ आधी
Screens आणि servers वेगवेगळे बनले आणि उशिरा जुळवले, आणि page 5,000 ला database ला प्रत्येक row चालावी लागली.
💡 काय
API design म्हणजे कार्यालयाचा मागणी-फॉर्म, बांधण्याआधी ठरलेला: resources, स्पष्ट errors आणि सुरक्षित retries.
⚙️ कसे
Idempotency-Key सह POST /classes/3A/notices ला 201 मिळतो; page 5,000 वर OFFSET 100,000 rows चालतो, cursor फक्त 20.
🎯 का
Teams दोन्ही बाजू एकाच वेळी बांधतात, retry मुळे सूचना दोनदा लागत नाही, आणि खोल pages पण page 1 इतकेच जलद.
🚀 पुढे
पुढचा धडा आपण विचारणार त्या प्रश्नांवरून data मांडतो, आणि मग store निवडतो.
🧪 इथे करून पाहा — OFFSET ने किंवा cursor ने पान N पर्यंत जा — मग Idempotency-Key सह आणि त्याशिवाय POST चा retry करा
तुम्ही जे प्रश्न विचाराल त्यांचे model करा, मग store निवडा — मूलतः relational, इतर खऱ्या कारणांसाठीच.
🧒 सोप्या शब्दांत
ग्रंथालय वाचक विचारतात त्या प्रश्नांनुसार पुस्तके लावते, जसे विषयानुसार. Dipika आधी प्रश्नांची यादी करते: वर्ग 3A च्या नव्या सूचना दाखवा. मग ती नेमक्या त्यासाठी एक table आणि एक index बनवते. साधा relational database हा तिचा सुरक्षित default. नवा प्रश्न आला तरच ती दुसरे stores जोडते.
📖 नवे शब्दaccess pattern — app data ला पुन्हा पुन्हा विचारतो तो प्रश्नrelational — joins आणि transactions असलेली tables; सुरक्षित default (PostgreSQL)key-value — एक key, एक value: ठरलेल्या lookups साठी प्रचंड scale वर खूप जलदindex — rows पटकन शोधणारी क्रमवार यादी: (class_id, created_at DESC)
⏪ आधी
प्रत्येक नवे app आधी फॅशनचा database निवडे, मग स्वतःच्या प्रश्नांची उत्तरे मिळवण्यासाठी वर्षानुवर्षे झगडे.
💡 काय
Data model म्हणजे कार्यालयाचे कपाट, त्याला विचारल्या जाणाऱ्या प्रश्नांवरून आखलेले; relational हा default.
⚙️ कसे
notices(id, class_id, …) हे एक table आणि (class_id, created_at DESC) index '3A च्या नव्या सूचना' पटकन देतात.
🎯 का
एक table, एक index, एक जलद उत्तर; S3, search किंवा vectors फक्त खरा access pattern मागेल तेव्हाच जोडायचे.
🚀 पुढे
पुढचा धडा भाग 2 पहिल्या बांधणीच्या ठोकळ्याने उघडतो: caching, प्रती कुठे आणि किती ठेवायच्या.
🧪 इथे करून पाहा — data ला काय लागते ते tick करा — choose_store() आपले नियम तपासते आणि पहिला जुळणारा नियम जिंकतो
प्रती कुठे ठेवायच्या, किती मोठ्या, किती काळ — hit-ratio वक्र आणि काय invalidate करायचे.
🧒 सोप्या शब्दांत
कार्यालय सर्वात जास्त मागितल्या जाणाऱ्या सूचनांच्या झेरॉक्स प्रती समोरच्या टेबलावर ठेवते. बहुतेक पालकांना त्याच थोड्या सूचना हव्या असतात, म्हणून कपाट कमी वेळा उघडावे लागते. Dipika ट्रेचा आकार तपासते. 10% वर्ग ठेवले तरी 64% reads ची उत्तरे मिळतात. सूचना बदलली की जुनी प्रत फेकून दिली जाते.
📖 नवे शब्दcache — लोकप्रिय data ची जवळची प्रत, म्हणजे database ला कमी विचारावे लागतेhit ratio — प्रत किती वेळा मिळाली: आकार वाढतो तसे 33.8%, 64.0%, 83.1%LRU — least recently used: भरल्यावर, सर्वात जास्त काळ न मागितलेले काढून टाकाinvalidate — खरी सूचना बदलली की प्रत फेकून द्या, किंवा छोटा TTL वापरा
⏪ आधी
प्रत्येक feed read database कडे जाई, सेकंदाला 1,157 reads, आणि database च bottleneck बनला.
💡 काय
Cache म्हणजे कार्यालयाचा झेरॉक्स ट्रे: लोकप्रिय सूचनांच्या प्रती जवळ, म्हणजे कपाट कमी वेळा उघडावे लागते.
पाहुणे आणि keys पसरवा — L4 vs L7, health checks, आणि असा ring जिथे server जोडल्यावर फक्त त्याचा वाटा हलतो.
🧒 सोप्या शब्दांत
Gate वरचा द्वारपाल प्रत्येक पालकाला उघड्या खिडकीकडे पाठवतो. सूचना वर्गानुसार 4 कपाटांत वाटलेल्या आहेत. नियम 'वर्ग क्रमांक mod 4' असेल, तर 5 वे कपाट आले की जवळजवळ प्रत्येक file हलते. Ring वर, नवे कपाट फक्त स्वतःचा वाटा घेते, 5 पैकी 1.
📖 नवे शब्दload balancer — requests निरोगी servers वर पसरवणारा द्वारपालhealth check — नियमित 'बरे आहात का?', म्हणजे traffic आजारी server टाळतेconsistent hashing — servers ची ring; नवा server सुमारे 1/N keys हलवतो (20%, 80% नाही)L4 vs L7 — L4 फक्त TCP पाहतो आणि जलद; L7 HTTP paths आणि headers वाचतो
⏪ आधी
Keys hash % N ने ठेवल्या जात, म्हणून एक cache server जोडला की जवळजवळ सगळे हलत आणि caches रिकामे होत.
💡 काय
Load balancing म्हणजे कार्यालयाचा द्वारपाल पालकांना उघड्या खिडक्यांकडे पाठवतो; hash ring प्रत्येक key ला ठरलेले घर देते.
⚙️ कसे
4 servers वर 10,000 वर्ग, 5 वा जोडला: hash % N 8,001 keys (80%) हलवतो, ring फक्त 1,975 (20%).
🎯 का
नवा server फक्त स्वतःचा वाटा घेतो, म्हणून caches गरम राहतात आणि servers वाढवणे शांतपणे होते.
🚀 पुढे
पुढचा धडा पटकन उत्तर देतो आणि हळू काम नंतर करतो: queues, workers, retries आणि DLQ.
🧪 इथे करून पाहा — hash ring वर 10,000 class keys (खरा md5) — server जोडा किंवा काढा आणि कोण हलते ते मोजा
पटकन उत्तर द्या, सावकाश काम नंतर करा — jobs, workers, retries, DLQs आणि at-least-once delivery.
🧒 सोप्या शब्दांत
कार्यालयात तुम्ही फॉर्म ट्रेमध्ये टाकता आणि लगेच शिक्का मिळतो. कारकून सगळे काम करेपर्यंत तुम्ही थांबत नाही. App 5 million SMS चे तेच करते. ते शिक्षिकेला 50 ms मध्ये उत्तर देते आणि queue वर एक job ठेवते. 50 workers असले तर सगळे SMS 33 मिनिटांत जातात.
📖 नवे शब्दqueue — नंतर क्रमाने करायच्या jobs ची रांगworker — queue वरून jobs घेणारा मदतनीस; जास्त workers म्हणजे लवकर काम पूर्णDLQ — dead-letter queue: सगळ्या retries नंतरही अपयशी jobs साठी कप्पाat-least-once — एक job दोनदा चालू शकतो, म्हणून दोनदा करणे सुरक्षित हवे
⏪ आधी
Post request स्वतःच 5M तातडीचे SMS पाठवायचा प्रयत्न करी, म्हणून शिक्षिका थांबून राही आणि request timeout होई.
💡 काय
Queue म्हणजे कार्यालयाचा in-tray: कारकून लगेच मागणीवर शिक्का मारतो, आणि workers हळू काम नंतर करतात.
⚙️ कसे
Request ~50 ms मध्ये 201 देतो; 50 SMS/s वेगाने 10 workers ला 166.7 min, 50 workers ला 33.3 min, 200 ला 8.3 min.
🎯 का
Request जलद राहतो, काम तुम्ही पैसे द्याल तितक्या वेगाने होते, आणि अपयश retry होते किंवा DLQ मध्ये थांबते.
🚀 पुढे
पुढचा धडा एका घटनेला अनेक ऐकणारे देतो: pub/sub events, fan-out आणि outbox.
🧪 इथे करून पाहा — "5M तातडीचे SMS पाठवा" — request एक job रांगेत टाकते; तो किती workers रिकामा करतील ते तुम्ही ठरवा
एक तथ्य, अनेक ऐकणारे — pub/sub, fan-out on write vs read, आणि DB व broker यांच्यामध्ये कधीही event (घटना) न गमावणे.
🧒 सोप्या शब्दांत
सूचना post झाली की अनेक जण प्रतिसाद देतात: email, SMS, search. कार्यालय एकदाच घोषणा करते आणि ज्यांना हवे ते ऐकतात. पण कारकुनाने सूचना save केली आणि मग तो बेशुद्ध पडला, तर घोषणा हरवते. म्हणून चिठ्ठी सूचनेसोबत outbox मध्ये जाते. Crash नंतरही एक मदतनीस ती नंतर पाठवतो.
📖 नवे शब्दevent — भूतकाळातील घटना, जसे NoticePostedpub/sub — एकदा publish करा, प्रत्येक subscriber ला स्वतःची प्रत मिळतेoutbox — data सोबत एकाच transaction मध्ये save केलेला event, नंतर relay पाठवतोfan-out — push प्रत्येक inbox लिहितो (200 writes); pull वाचताना गोळा करतो (1,200 lookups)
⏪ आधी
App सूचना save करी, मग broker ला सांगे; मधेच crash झाला तर NoticePosted हरवे आणि कोणत्याच पालकाला कळत नसे.
💡 काय
Event म्हणजे कार्यालयाची घोषणा: एक घटना, अनेक ऐकणारे; outbox म्हणजे पाठवेपर्यंत ठेवलेली चिठ्ठी.
⚙️ कसे
Outbox असेल तर crash नंतर NoticePosted थांबून राहते आणि relay ते publish करतो; push ला 200 writes, pull ला 1,200 lookups.
🎯 का
Database आणि broker मध्ये कोणताही event हरवत नाही, आणि email, SMS, search प्रत्येक स्वतंत्रपणे प्रतिसाद देतात.
🚀 पुढे
पुढचा धडा विचारतो एक deploy की अनेक: modular monolith ने सुरुवात करा आणि प्रत्येक hop ची किंमत मोजा.
🧪 इथे करून पाहा — DB आणि broker च्या मधे crash सह सूचना post करा — dual write विरुद्ध outbox; मग fan-out push विरुद्ध pull
modular monolith ने सुरुवात करा — प्रत्येक जास्तीच्या hop ची किंमत latency आणि availability मध्ये का मोजावी लागते, आणि कधी विभागायचे.
🧒 सोप्या शब्दांत
स्पष्ट टेबलांचे एक कार्यालय चालवायला सोपे असते. प्रत्येक टेबल वेगळ्या इमारतीत गेले, तर प्रत्येक प्रश्नासाठी फेरी मारावी लागते. प्रत्येक फेरीला वेळ लागतो आणि ती अपयशी होऊ शकते. सलग आठ फेऱ्यांनी page हळू आणि कमी भरवशाचे होते. म्हणून Dipika एका कार्यालयाने सुरुवात करते आणि खऱ्या कारणानेच टेबल बाहेर हलवते.
📖 नवे शब्दmodular monolith — आत स्पष्ट modules असलेला एक deploy; सुरक्षित सुरुवातmicroservice — एक team एकटी deploy करते अशी छोटी service, network वरून बोलावली जातेhop — एक network call; 20 ms चे 8 hops = 160 ms आणि 99.20% availabledistributed monolith — एकत्रच deploy कराव्या लागणाऱ्या अनेक services: सगळा खर्च, फायदा नाही
⏪ आधी
Teams नी पहिल्याच दिवशी app चे डझनभर services केले, आणि तरीही ते सगळे एकत्रच deploy करावे लागले.
💡 काय
Modular monolith म्हणजे स्पष्ट टेबलांचे एक कार्यालय; team किंवा scale ची गरज असेल तेव्हाच service वेगळी करायची.
⚙️ कसे
प्रत्येक hop 20 ms आणि 99.9% up: 1 hop ला 99.90%, 3 hops ला 99.70%, आणि 8 hops ला 160 ms व फक्त 99.20%.
🎯 का
कमी hops म्हणजे जलद pages, जास्त availability आणि सोपे transactions, विभागण्याचे खरे कारण येईपर्यंत.
🚀 पुढे
पुढचा धडा प्रतींमध्ये एकमत ठेवतो: strong की eventual, R + W > N quorums आणि CAP ची निवड.
🧪 इथे करून पहा — services च्या रांगेतून जाणारी एक request — call_chain(hops, ms_each, availability_each)
Strong की eventual — replicas, quorums (R + W > N), read-your-writes आणि फूट पडल्यावर CAP ची निवड.
🧒 सोप्या शब्दांत
कार्यालय सूचना रजिस्टरच्या 3 प्रती ठेवते. शिक्षिका 'exam on Monday' बदलून 'Tuesday' करते, पण एक प्रत अजून बदललेली नाही. एकच प्रत पाहिली तर Monday वाचले जाऊ शकते. दोन पाहिल्या तर त्यातली एक नक्की Tuesday सांगते. गुणांसाठी पुरेशा प्रती तपासा; likes साठी एक पुरे.
📖 नवे शब्दstrong — प्रत्येक read नवीनतम write पाहतो; हळू पण नेहमी बरोबरeventual — प्रती थोड्या वेळाने जुळतात; एखादा read क्षणभर जुना असू शकतोquorum — R + W > N: 3 प्रती असताना 2 write आणि 2 read नेहमी एकमेकांना छेदतातCAP — network split च्या वेळी उत्तर द्या (कदाचित जुने) किंवा नकार द्या (बरोबर राहा)
⏪ आधी
Data ची एकच प्रत नेहमी बरोबर असे, आणि ती प्रत बंद पडली की पूर्ण app बंद पडे.
💡 काय
Consistency म्हणजे कार्यालय आपल्या 3 रजिस्टरमध्ये एकमत कसे ठेवते, म्हणजे पालक जुनी सूचना वाचत नाहीत.
⚙️ कसे
N=3 असताना R=1 W=1 'exam on Monday' वाचू शकते; R=2 W=2 एकमेकांना छेदतात आणि 'exam moved to Tuesday' वाचतात.
🎯 का
प्रत्येक data साठी निवडता: गुण आणि पैशांसाठी strong, थोडे मागे राहू शकणाऱ्या likes आणि counts साठी eventual.
🚀 पुढे
पुढचा धडा services मध्ये सगळे किंवा काहीच नाही करतो: two-phase commit, तो का अडतो, आणि undo करणारे sagas.
🧪 इथे करून पहा — सूचना नोंदवहीच्या N प्रती — R आणि W निवडा, नवीन version लिहा, मग वाचा आणि ते शिळे आहे का ते पहा
services ओलांडून सगळे किंवा काहीच नाही — two-phase commit आणि ते का अडकते, compensations सह sagas.
🧒 सोप्या शब्दांत
शाळेच्या सहलीसाठी seat, payment आणि bus लागते. Katrina ची seat राखली जाते आणि ₹500 घेतले जातात. मग bus भरलेली निघते. म्हणून कार्यालय प्रत्येक पायरी उलट क्रमाने रद्द करते: Katrina ला ₹500 परत करते आणि seat मोकळी करते. प्रत्येक पायरीचा स्वतःचा undo असतो.
📖 नवे शब्द2PC — two-phase commit: सगळे मत देतात, मग सगळे commit; coordinator गेला तर BLOCKEDsaga — local पायऱ्यांची साखळी, पुढची अपयशी झाली तर प्रत्येकीला undocompensation — undo पायरी, जसे Katrina ला ₹500 परत करणेlock — data वरची पकड, तुमचे होईपर्यंत दुसरे कोणी बदलू शकत नाही
⏪ आधी
एकाच database मध्ये सगळे असे, म्हणून एक transaction पुरे; services वेगळे झाले आणि bookings अर्धवट राहू लागली.
💡 काय
Saga म्हणजे कार्यालयाची सहलीची यादी: प्रत्येक पायरीला undo असतो, म्हणून अपयशी पायरीनंतर क्रमाने मागे जाता येते.
⚙️ कसे
Coordinator गेला तर 2PC BLOCKED होतो; saga seat राखते, Katrina ला ₹500 लावते, bus भरली, ₹500 परत करते.
🎯 का
Services मध्ये global locks नाहीत, आणि अर्धवट अपयश स्वच्छ संपते: Katrina ला पैसे परत मिळतात आणि seat मोकळी होते.
🚀 पुढे
पुढचा धडा कार्यालयाला पुरापासून वाचवतो: token bucket vs sliding window, प्रत्येक user साठी आणि एकूण.
🧪 इथे करून पहा — शाळेच्या सहलीचे booking — two-phase commit मध्ये मत द्या, coordinator बंद पाडा, मग saga ची कोणतीही पायरी अयशस्वी करा
कार्यालयाला लोंढ्यांपासून वाचवा — token bucket vs sliding window, प्रति user, प्रति key, जागतिक पातळीवर.
🧒 सोप्या शब्दांत
प्रत्येक पालकाच्या app ला canteen coupons सारखे tokens मिळतात. प्रत्येक request एक वापरते, आणि दर सेकंदाला थोडे परत मिळतात. Aishwarya चा phone अडकला आणि अर्ध्या सेकंदात 17 requests पाठवल्या. Bucket ने 12 आत सोडल्या आणि बाकीच्यांना 'हळू' सांगितले. बाकी सगळ्यांना सेवा मिळत राहिली.
📖 नवे शब्दtoken bucket — tokens ठराविक वेगाने भरतात आणि burst ची सूट: 5/s, burst 10sliding window — प्रत्येक कालावधीची पक्की मोजणी: 1 s ला 10, म्हणून 17 पैकी 10 जातात429 — 'खूप जास्त requests' हे उत्तर, Retry-After सोबत पाठवलेलेburst — नेहमीच्या वेगापेक्षा जास्त, थोड्या वेळासाठी परवानगी असलेली गर्दी
⏪ आधी
एक सदोष app सतत requests पाठवून बाकी सगळ्या पालकांसाठी कार्यालय मंद करू शकत असे.
💡 काय
Rate limiting म्हणजे कार्यालयाची token खिडकी: प्रत्येक पालकाला tokens मिळतात, token नसेल तर उत्तर 429.
⚙️ कसे
0.5 s मध्ये 17 requests: token bucket (5/s, burst 10) 12 आत सोडतो, sliding window (10 per 1 s) फक्त 10.
🎯 का
एक गोंगाट करणारे app बाकीच्यांना उपाशी ठेवू शकत नाही; त्याला Retry-After सह 429 मिळतो, counters Redis मध्ये.
🚀 पुढे
पुढचा धडा भाग 3 उघडतो: प्रत्येक dependency अपयशी होते, म्हणून page budget मध्ये प्रत्येकाला timeout द्या.
🧪 इथे करून पहा — burst बदला (count@second, किंवा count@start-end समान वाटून) आणि दोन्ही limiters ची तुलना करा
Page 800 ms मध्ये तयार हवे. Dipika त्यातच प्रत्येक मदतनीसाला वेळमर्यादा देते: 50 ms, 150 ms आणि 300 ms. Photo मदतनीस नसला तरी page सूचना दाखवते, फक्त photos शिवाय. सतत अपयशी होणाऱ्या मदतनीसाला कार्यालय बोलावणे थांबवते, आणि नंतर पुन्हा प्रयत्न करते.
📖 नवे शब्दtimeout — पुढे जाण्याआधी मदतनीसासाठी थांबायची जास्तीत जास्त वेळretry with jitter — थोडा random वेळ थांबून पुन्हा प्रयत्न, म्हणजे सगळे एकदम retry करत नाहीतcircuit breaker — अपयशी भागाला काही वेळ बोलावणे थांबवा, मग पुन्हा तपासाdegrade — तुटलेल्या भागाशिवाय page चालू ठेवा, जसे photos शिवाय सूचना
⏪ आधी
एक हळू photo service उत्तर देईपर्यंत प्रत्येक page अडवून ठेवे, म्हणून छोट्या दोषाने पूर्ण app बंद पडे.
💡 काय
Resilience म्हणजे कार्यालयाची प्रत्येक टेबलाची पर्यायी योजना: ठराविक वेळच थांबा, हळूवार retry करा, त्याशिवाय काम चालू ठेवा.
⚙️ कसे
800 ms चे page budget: auth 50 ms, notices DB 150 ms, photos 300 ms; photos बंद तर photos शिवाय सूचना.
🎯 का
अपयशी भाग एक feature घालवतो, page नाही; breaker थांबलेला असताना पालक सूचना वाचत राहतात.
🚀 पुढे
पुढचा धडा विचारतो कोण काय करू शकतो: प्रत्येक box ला STRIDE, आणि प्रत्येक object साठी authorization.
🧪 इथे करून पाहा — 800 ms चे पानाचे बजेट auth, सूचनांचा DB आणि फोटो service मध्ये वाटा — मग फोटो service मोडून पाहा
प्रत्येक box ला STRIDE विचारा — identity, प्रत्येक object साठी authorization, encryption, secrets, गैरवापर.
🧒 सोप्या शब्दांत
नवी इमारत उघडण्याआधी कोणीतरी फिरून प्रत्येक दार आणि खिडकी तपासते. Dipika योजनेचे तेच करते. प्रत्येक box ला ती 6 प्रश्न विचारते: कोण बोलावतो, बदलले का, नाकारता येईल का, कोण वाचू शकते, पूर येईल का, कोणी boss होऊ शकतो का. पालकांना फक्त आपल्या मुलांचे वर्ग दिसतात.
📖 नवे शब्दSTRIDE — धोक्यांचे 6 प्रश्न: Spoofing, Tampering, Repudiation, Info, DoS, Elevationauthentication — तुम्ही कोण आहात ते सिद्ध करणे, उदाहरणार्थ OIDC नेauthorization per object — प्रत्येक सूचनेसाठी हा पालक ती वाचू शकतो का ते तपासणेleast privilege — प्रत्येक भागाला खरोखर लागते तेवढाच access द्या
⏪ आधी
Security म्हणजे launch आधीचा एक checkbox, म्हणून पालक class id ओळखून दुसऱ्या वर्गाच्या सूचना वाचू शकत.
💡 काय
Security by design म्हणजे कार्यालयाची कुलपांची यादी: बांधण्याआधी योजनेतील प्रत्येक box ला STRIDE विचारा.
⚙️ कसे
Notice API ला STRIDE चे 6 प्रश्न, spoofing पासून elevation पर्यंत; पालकांना फक्त आपल्या मुलांचे वर्ग दिसतात.
launch आधीच निरोगी म्हणजे काय ते ठरवा — SLOs, error budgets, RED आणि USE, logs, metrics, traces.
🧒 सोप्या शब्दांत
Check-up आधी डॉक्टर ठरवतात की निरोगी म्हणजे काय. Dipika ते launch आधी ठरवते: 99.9% requests चालायला हव्यात. त्यामुळे महिन्याला 43 मिनिटांची अडचण चालते, हेच error budget. पालकांना त्रास जाणवतो तेव्हा alarm वाजतो, फक्त machine व्यस्त असताना नाही.
📖 नवे शब्दSLO — दिलेले उद्दिष्ट, जसे 99.9% requests चालणेerror budget — SLO किती अपयश चालू देते: 30 दिवसांत 43.2 मिनिटेRED — प्रत्येक API साठी: Rate, Errors, Durationtrace — एका request चा तिने स्पर्श केलेल्या प्रत्येक service मधून घेतलेला माग
⏪ आधी
रात्री जास्त CPU वर alerts वाजत पण पालकांना काही त्रास नसे, आणि खरे outages तासनतास लक्षात येत नसत.
💡 काय
Observability म्हणजे कार्यालयाचा आरोग्य तक्ता: निरोगी म्हणजे काय ते ठरवा, मग rate, errors आणि वेळ पाहा.
⚙️ कसे
99.9% SLO मुळे 30 दिवसांत 43.2 मिनिटांचे error budget मिळते; 99.99% ला फक्त 4.3 मिनिटे.
🎯 का
Alert पालकांना जाणवते त्यावर, CPU वर नाही, आणि budget सांगते कधी ship करायचे आणि कधी थांबायचे.
🚀 पुढे
पुढचा धडा प्रत्येक box ला बिल आणि कारण देतो: पहिला cost model आणि एका पानाची निर्णयाची नोंद.
🧪 इथे करून पाहा — SLO चे error budget मध्ये रूपांतर करा — मग ते incidents वर खर्च करा आणि किती उरते ते पाहा
प्रत्येक box ला एक बिल आणि एक कारण असते — पहिले cost model आणि एका पानाची निर्णयाची नोंद (ADR).
🧒 सोप्या शब्दांत
योजनेतल्या प्रत्येक box चे बिल असते: servers, storage, बाहेर पाठवलेला data, requests. Dipika बेरीज करते: महिन्याला $1,216. मग Redis का निवडले आणि त्याची किंमत काय, हे ती एका पानावर लिहिते. पुढच्या वर्षी नवी सहकारी वाद पुन्हा सुरू करण्याऐवजी ते पान वाचते.
📖 नवे शब्दcost model — प्रत्येक box चे बिल एकत्र: इथे महिन्याला $1,216egress — users कडे बाहेर पाठवलेला data; अनेकदा सर्वात मोठी ओळ, इथे $450trade-off — देवाणघेवाण (trade-off): एक मिळवता, दुसऱ्याने किंमत मोजता, जसे वेगासाठी 60 s उशीरADR — एका पानाची निर्णयाची नोंद (ADR): संदर्भ, निर्णय, परिणाम
⏪ आधी
Redis का आहे किंवा app ला किती खर्च येतो कोणालाच माहीत नसे, म्हणून प्रत्येक नवा माणूस तोच वाद पुन्हा घाले.
💡 काय
Cost model आणि ADR म्हणजे कार्यालयाचे बिल आणि इतिवृत्त: प्रत्येक box ला किती खर्च आणि तो का निवडला.
⚙️ कसे
पहिले बिल: servers $360, storage $46, egress $450, requests $360, एकूण $1,216; ADR 001 feeds Redis मध्ये cache करतो.
🎯 का
प्रत्येक देवाणघेवाण (trade-off) परिणामांसह एकदाच लिहिली जाते, म्हणून नंतरच्या teams जाणीवपूर्वक ठेवतात किंवा बदलतात.
🚀 पुढे
पुढचा धडा पूर्ण पद्धत तीन classic designs वर वापरतो: URL shortener, notifications आणि chat.
🧪 इथे करून पाहा — पहिले मासिक बिल — आकार आणि उदाहरणातल्या किंमती बदला; मग ती निवड समजावणारी ADR लिहा
तीन क्लासिक रचना, त्यांना आकार देणारे आकडे — short ids, fan-out, connections आणि ordering.
🧒 सोप्या शब्दांत
आता Dipika त्याच यादीने तीन प्रसिद्ध apps आखते. Short links: 6 billion links साठी 6 अक्षरे पुरतात. Notifications: साध्या शिक्षिका प्रत्येक inbox मध्ये push करतात, पण 2 million followers असलेल्या star चे वाचताना आणले जाते. Chat: 1 million online लोकांसाठी 20 gateway servers लागतात.
📖 नवे शब्दbase62 — 0-9, a-z, A-Z: 6 अक्षरांतून 62^6 ≈ 56.8 billion ids301/302 — browser ला लांब link कडे पाठवणारी redirect उत्तरेWebSocket — उघडे ठेवलेले connection, म्हणजे chat messages लगेच पोहोचतातsequence number — प्रत्येक message वरचा क्रमांक, म्हणजे ते योग्य क्रमाने दिसतात
⏪ आधी
Classic designs चित्रांसारखी पाठ केली जात, म्हणून आकड्यांत छोटा बदल झाला की design समजावता येत नसे.
💡 काय
Worked designs म्हणजे कार्यालय आपली यादी सुरुवातीपासून शेवटपर्यंत वापरते: दर वेळी आकडे आकार ठरवतात.
⚙️ कसे
6 billion links ला 6 base62 अक्षरे पुरतात; 2M followers च्या लेखकासाठी pull; 1M online chat ला 20 gateways.
🎯 का
प्रत्येक box एका आकड्यावरून समजावता येतो, म्हणून नवे काम अंदाज न राहता design बनते.
🚀 पुढे
पुढचा धडा तीन जड designs घेतो: chunks सह file storage, CDN सह video, आणि AI search साठी RAG.
🧪 इथे करून पाहा — तीन calculators — URL shortener, notification fan-out आणि chat service — आणि sequence number नुसार क्रम लावणे
तीन जड रचना — chunks आणि dedupe, renditions आणि CDN egress, AI search साठी ingest vs ask.
🧒 सोप्या शब्दांत
मोठ्या files चे तुकडे केले जातात, म्हणून एक शब्द बदलला तर 12 पैकी फक्त 2 तुकडे upload होतात. Video 4 आकारांत ठेवला जातो, आणि तो पाहणाऱ्यांकडे पाठवणे ठेवण्यापेक्षा खूप महाग असते. AI search साठी शाळेचे documents आधीच 400,000 छोटे तुकडे होतात. प्रश्न सर्वोत्तम 5 शोधतो आणि sources सह उत्तर देतो.
📖 नवे शब्दchunk — content hash ने नाव दिलेला file चा तुकडा; सारखा तुकडा एकदाच साठवला जातोrendition — video चा एक आकार: 1080p, 720p, 480p किंवा 240pCDN egress — CDN कडून पाहणाऱ्यांकडे गेलेला video: 1M views साठी 187.5 TBRAG — आधी योग्य chunks शोधा, मग AI ला त्यांतून sources सह उत्तर देऊ द्या
⏪ आधी
जड designs चा खर्च फक्त storage वरून काढला जाई, आणि खरे बिल, uploads आणि CDN egress, धक्का देऊन येई.
💡 काय
जड designs म्हणजे कार्यालयाच्या सर्वात मोठ्या योजना: files चे chunks, videos चे renditions, RAG साठी documents.
⚙️ कसे
एक शब्द बदलला तर 12 पैकी 2 chunks upload; 1M video views म्हणजे 187.5 TB CDN egress; RAG 400,000 chunks index करते.
🎯 का
तीच पद्धत कोणत्याही आकारात चालते: गरजा, आकडे, API, data, blocks, failure, security, cost, ADR.
🚀 पुढे
पुढे कुठे: traffic साठी Scaling school, data साठी Database school, आणि RAG साठी AI school.
🧪 इथे करून पाहा — तुम्ही बदललेली file chunk + dedupe करा, video ladder आणि त्याचे CDN बिल मोजा, आणि RAG index व prompt चा आकार काढा