🧮 शाळेच्या पद्धतीने DSA शिका
शाळेचे ग्रंथालय, लॉकर्स, जेवणाची रांग आणि कॉरिडॉरचा नकाशा म्हणून शिकवलेले data structures आणि algorithms: प्रत्येक container म्हणजे शाळेतली एक जागा, प्रत्येक algorithm म्हणजे ती चालण्याचा एक मार्ग, आणि प्रत्येक खर्च पावलांत मोजलेला. प्रत्येक धडा म्हणजे क्रमांकित आकृती असलेली शाळेची गोष्ट — आणि ग्रंथालय रेपोच्या आतच आहे: प्रत्येक structure साध्या Python मध्ये काचेच्या भिंतींसह हाताने बांधलेली, प्रत्येक algorithm ला पावले मोजणारा counter, आणि खर्च गृहीत न धरता मोजणारा demo.
🏫 भाग 1 — जागा (1–6)
- शाळा दुप्पट झाल्यावर काम कसे वाढते 📏
- लॉकर्सची रांग: arrays, two pointers, windows 🗄️
- खजिन्याचा शोध: linked lists 🧵
- ट्रेची चळत आणि जेवणाची रांग: stacks, queues 🥞
- नावानुसार कप्पे: hash maps 🗂️
- मुख्याध्यापक उपमुख्याध्यापकांना विचारतात: recursion 🪆
🚶 भाग 2 — चाली (7–12)
- उंचीनुसार रांग: sorting 📶
- क्रमाने लावलेली नोंदवही: binary search 🔍
- कॅटलॉग आणि व्यासपीठ: trees, heaps 🌳
- कॉरिडॉरचा नकाशा: graphs 🗺️
- फळ्यावरची उत्तरे: DP आणि greedy 🧠
- प्रश्न ठरवतो: निवड, मुलाखतीची पद्धत 🎯
# the 60-second wow — every cost, measured:
git clone https://github.com/BaluRaut/learn-dsa-school.git && cd learn-dsa-school
python3 dsa/demo.py                # Big-O timed, every container and every walk with its step count
python3 dsa/test_dsa.py            # the smoke test: 12 checks over every structure and recipe
तुम्हाला काय दिसायला हवे (छाटलेले — यश असे दिसते):
── Big-O — how the work grows when the school doubles (lesson 01)
   n=  1,000: linear   1,000 steps   N.NNN ms · binary 10 steps  N.NNN ms · hash 1 step N.NNN ms
   n= 10,000: linear  10,000 steps   N.NNN ms · binary 14 steps  N.NNN ms · hash 1 step N.NNN ms
   n=100,000: linear 100,000 steps   N.NNN ms · binary 17 steps  N.NNN ms · hash 1 step N.NNN ms
   ×10 pupils → linear ×10 (O(n)), binary +3 steps (O(log n)), hash the same (O(1)) — the shape is the whole subject

── Arrays — the row of lockers: jump straight to locker 17, but inserting at the front shifts everyone (lesson 02)
   lockers[17] = 17  (one step, whatever the row length)
   insert at the FRONT of 2,000,000: N.NNN ms (everyone shifts) · append at the BACK: N.NNN ms
   sliding window: best 3 consecutive days of [3, 8, 2, 9, 7, 1, 6, 4] → sum 19 starting at day 1
   two pointers: which two of [1, 2, 3, 4, 6, 7, 8, 9] sum to 13? → indices (3, 7)

── Linked lists — the treasure hunt: each note says where the next one is (lesson 03)
   notes in order: ['Aishwarya', 'Katrina', 'Dipika', 'Meera', 'Rohan']   (push_front is O(1): a new note pointing at the old first)
   find 'Katrina': followed 2 notes · find 'Zoya': -1 (walked all 5)
   reversed in place: ['Rohan', 'Meera', 'Dipika', 'Katrina', 'Aishwarya']

── Stacks and queues — the tray pile (LIFO) and the lunch line (FIFO) (lesson 04)
   pile: put 1,2,3 → take: tray 3, tray 2
   line: join Aishwarya, Katrina, Dipika → serve: Aishwarya, Katrina
   brackets with a stack: '(a[b]{c})' → True · '(a[b)]' → False

── Hash maps — pigeonholes by name: hash(name) says which box, so a lookup is O(1) (lesson 05)
   8 pupils filed · boxes grew to 16 · collisions on the way: 2 · Dipika → 3A · 'Zed' in map? False
   counting with a dict: {'the': 3, 'cat': 1, 'sat': 1, 'on': 1, 'mat': 1, 'end': 1}  (one pass, O(n))

── Recursion — the head asks the deputy, who asks the teachers … (lesson 06)
   5! = 120 — the asking went 5 levels deep before the base case answered
   fib(25): asked 242,785 times without a board · 49 times with one (memoisation, lesson 11)

── Sorting — lining up the class by height: n² walks vs n log n splits (lesson 07)
   bubble    1,997,047 comparisons   N.NNN ms
   insertion   985,773 comparisons    N.NNN ms
   merge        19,384 comparisons     N.NNN ms
   quick        13,248 comparisons     N.NNN ms
   nearly sorted: insertion needs 1,999 comparisons, bubble 1,999 — the input shape matters
   Python's sorted() (Timsort) in N.NNN ms — at work you call it; here you know why it is fast

── Binary search — the register is sorted, so open it in the middle (lesson 08)
   50,000 pupils, find #823853: linear looked at 41,235 · binary at 15  (log2(50,000) ≈ 15.6)
   search on the answer: the smallest locker that fits 8 bags of 30 kg into 3 lockers → 90 kg (binary search over capacities 1–240)

── Trees — the catalogue drawer (BST) and the podium (heap) (lesson 09)
   balanced insert order: height 4, search(43) looked at 4 cards · in-order walk = sorted: [6, 12, 18, 25, 31, 37]…
   sorted insert order:   height 11 — a list in disguise; search(11) looked at 11 cards (why balanced trees exist)
   heap of 100 m times: top 10.8 · pop → 10.8, 11.4, 12.1  (each fix-up O(log n))

── Graphs — the corridor map: BFS floods by hops, DFS follows one corridor, Dijkstra measures (lesson 10)
   BFS from office (hops): {'office': 0, 'hall': 1, 'lab': 2, 'library': 2, 'gym': 3, 'field': 4}
   DFS from office (order): ['office', 'hall', 'lab', 'gym', 'library', 'field']
   Dijkstra from office (metres): {'office': 0, 'hall': 20, 'lab': 50, 'library': 30, 'gym': 65, 'field': 105}  · cycle? True

── Dynamic programming and greedy — remember answers on the board; take the meeting that ends first (lesson 11)
   stairs(10) ways to climb 10 steps by 1s and 2s: 89 · coin_change([1,5,10,25], 63) → 6 coins · coin_change([4,7], 5) → -1
   one room, most meetings: ['chess', 'coding', 'art']  (sort by end time, greedily take what fits)

── Choosing the structure — the question decides (lesson 12)
   jump to the i-th thing                   → array / list                     O(1) index
   add/remove at the front constantly       → linked list or deque             O(1)
   undo, nesting, most-recent-first         → stack                            O(1) push/pop
   first come first served                  → queue                            O(1) both ends
   look something up by name                → hash map / set                   O(1) average
   keep things sorted while adding          → balanced BST / sorted container  O(log n)
   always need the smallest / biggest       → heap (priority queue)            O(log n)
   rooms and corridors, shortest path       → graph + BFS / Dijkstra           O(V + E) / O(E log V)
   overlapping sub-problems                 → dynamic programming              usually O(n) or O(n·m)

✅ the library: know the cost of every container and every walk, and the right one picks itself🗺️ संपूर्ण चित्र — एक आकृती, पूर्ण कोर्स
संपूर्ण कोर्स एका कॅनव्हासवर. 4K आवृत्तीसाठी क्लिक करा.
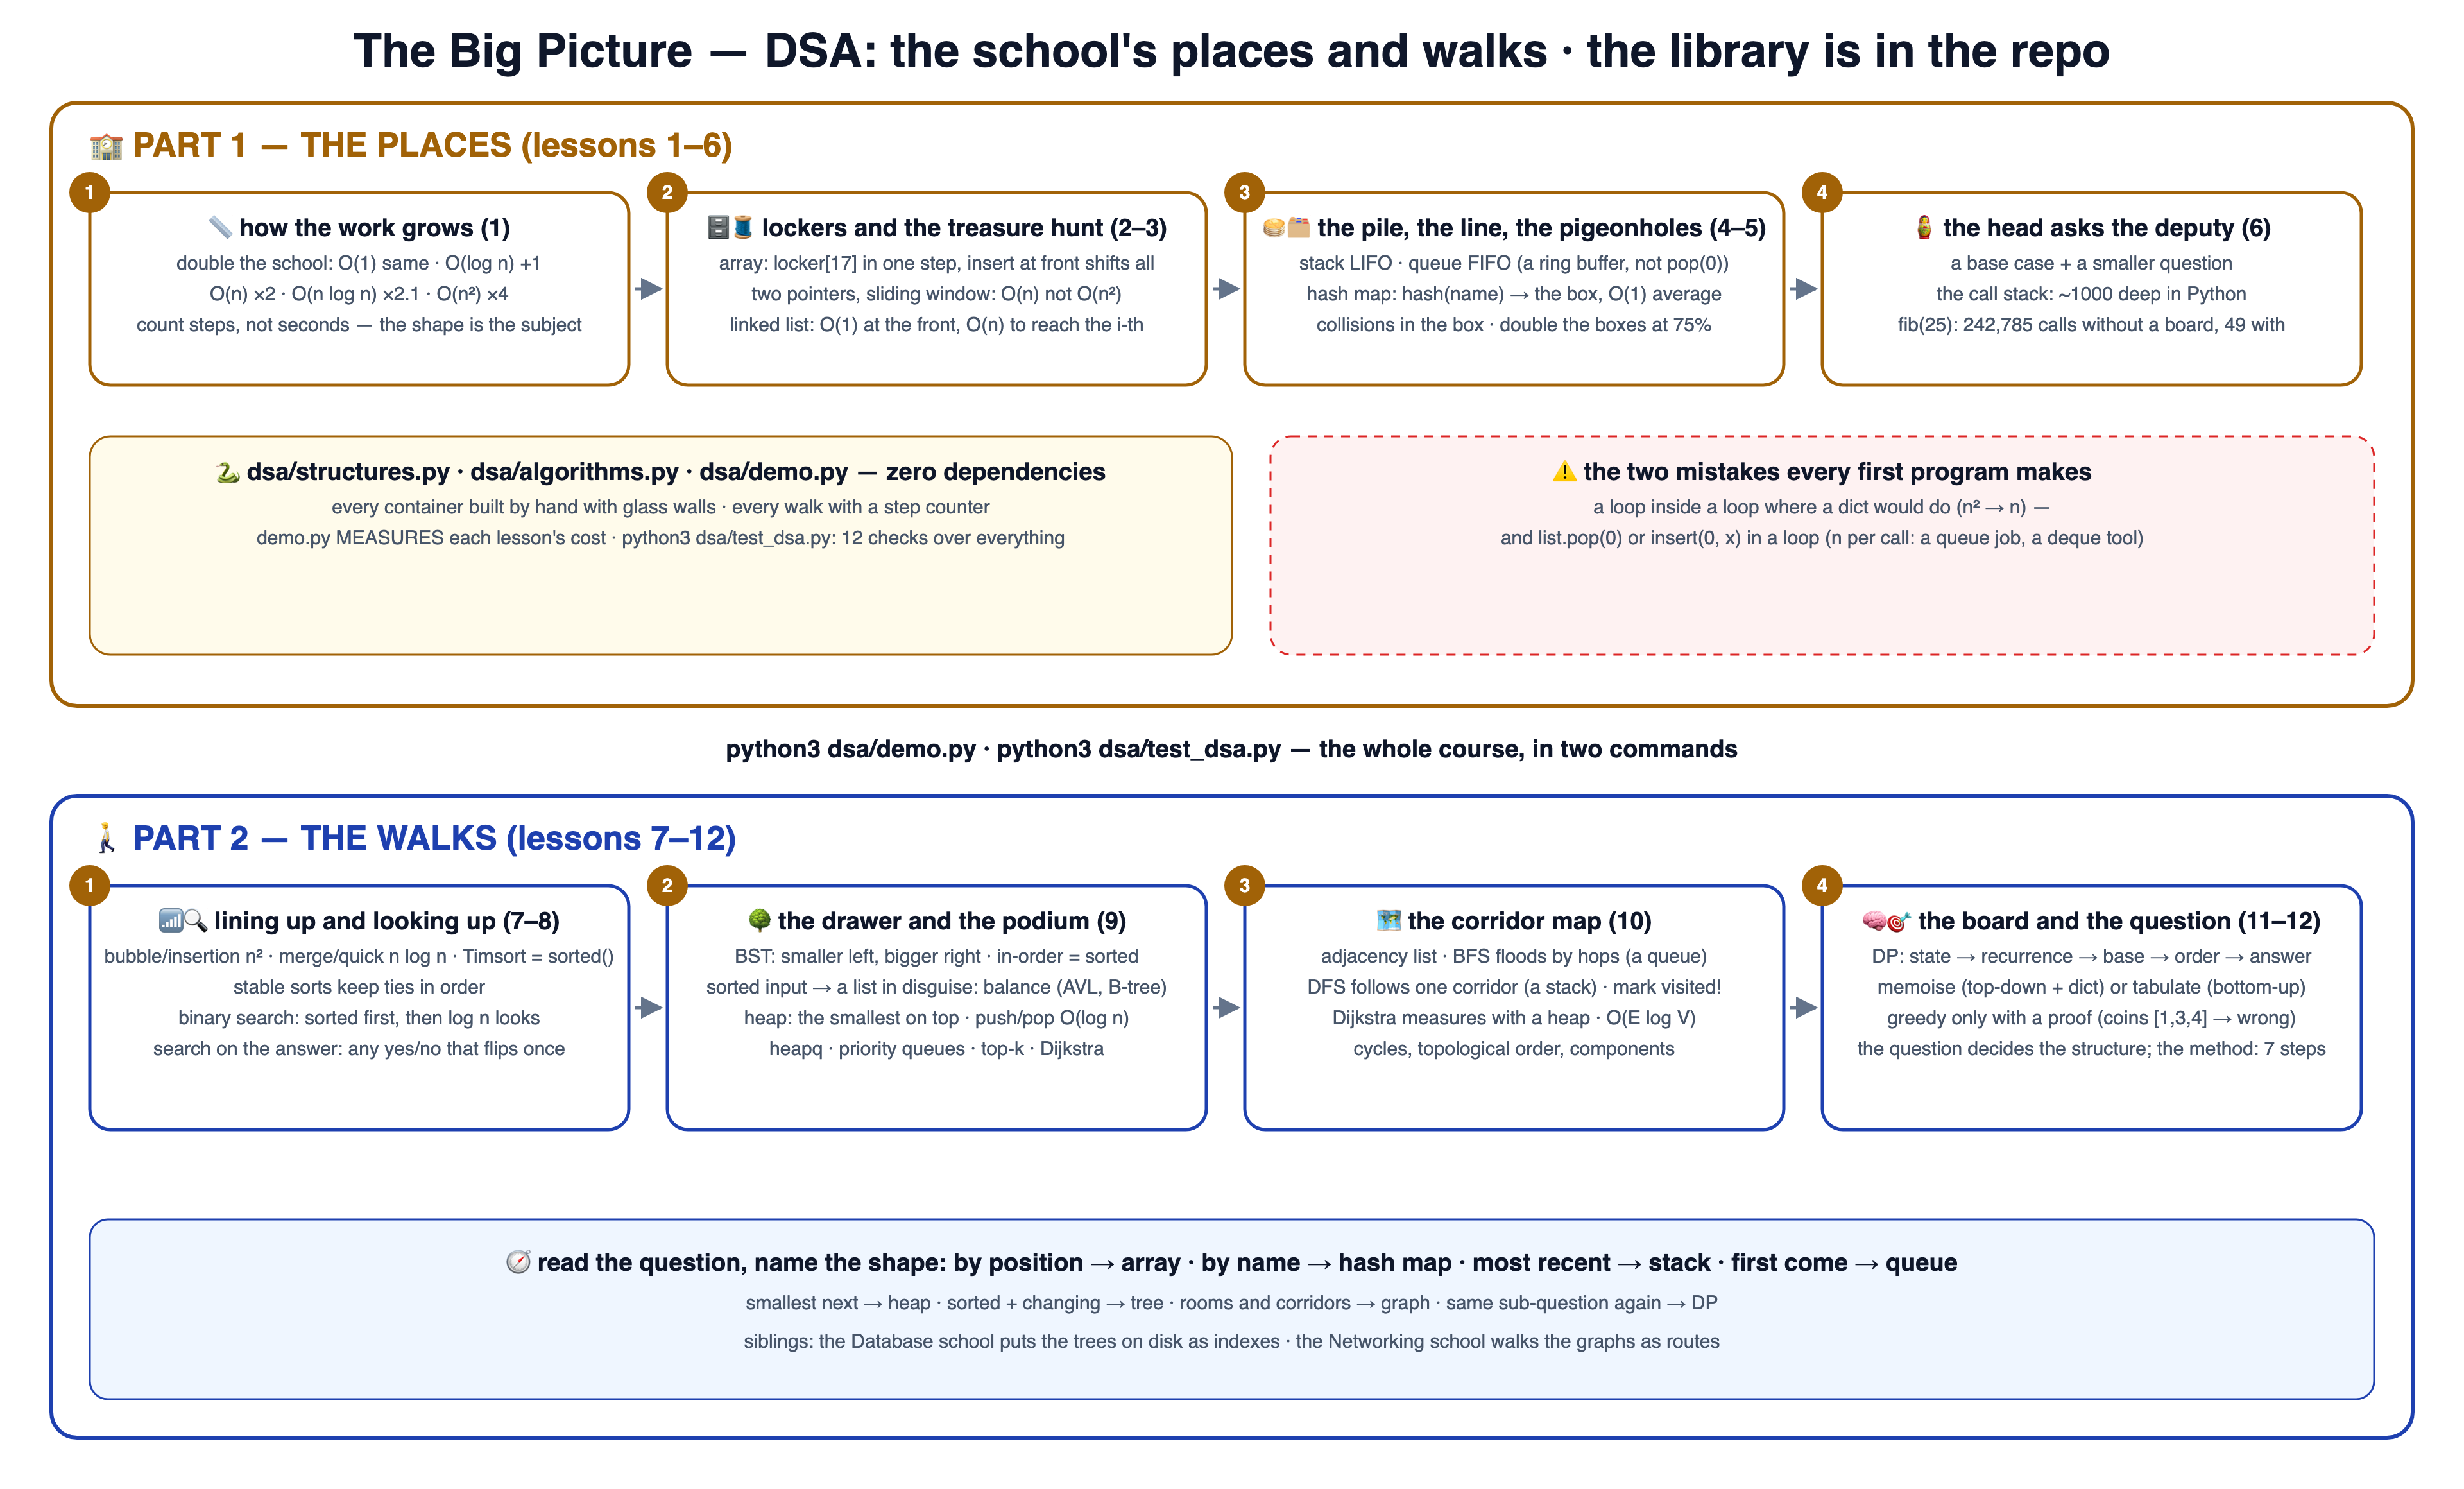
🏫 भाग 1 — जागा (धडे 1–6)
एक git ब्रँच = एक कल्पना; ब्रँच 04 मध्ये धडे 01–04 आहेत. लॅब साध्या Python 3 वर चालतात — libraries नाहीत, installs नाहीत.
📏 DSA & Big-O का
lesson-01-why-dsaधडा वाचा →आकृती पहा ↗🗄️ Arrays & strings
lesson-02-arraysधडा वाचा →आकृती पहा ↗🧵 Linked lists
lesson-03-linked-listsधडा वाचा →आकृती पहा ↗🥞 Stacks & queues
lesson-04-stacks-queuesधडा वाचा →आकृती पहा ↗🗂️ Hash maps & sets
lesson-05-hash-mapsधडा वाचा →आकृती पहा ↗🪆 Recursion
lesson-06-recursionधडा वाचा →आकृती पहा ↗🚶 भाग 2 — चाली (धडे 7–12)
Algorithms, प्रत्येक साध्या आवृत्तीविरुद्ध मोजलेला, म्हणजे Big-O तुम्हाला सांगितलेले नाही तर तुम्ही पाहिलेले असते.
📶 Sorting
lesson-07-sortingधडा वाचा →आकृती पहा ↗🔍 Binary search
lesson-08-binary-searchधडा वाचा →आकृती पहा ↗🌳 Trees & heaps
lesson-09-trees-heapsधडा वाचा →आकृती पहा ↗🗺️ Graphs
lesson-10-graphsधडा वाचा →आकृती पहा ↗🧠 Dynamic programming & greedy
lesson-11-dp-greedyधडा वाचा →आकृती पहा ↗🎯 योग्य structure निवडणे
lesson-12-choosingधडा वाचा →आकृती पहा ↗📐 धड्यांच्या आकृत्या — क्रमांक अनुसरा
प्रत्येक धडा एका क्रमांकित बॉक्स-आणि-बाण आकृतीत — स्वतंत्र पानावरही.
1 📏 DSA & Big-O का
शाळा दुप्पट झाल्यावर काम कसे वाढते — O(1), O(log n), O(n), O(n log n), O(n²); आकार हाच अख्खा विषय.
प्रगतिपुस्तके वाटण्याचा विचार करा. शाळा 1,000 वरून 2,000 विद्यार्थ्यांची झाली की काही कामांना तेवढाच वेळ लागतो, काहींना दुप्पट, आणि प्रत्येक विद्यार्थ्याची प्रत्येकाशी तुलना करायला चारपट. वाढीच्या या आकारालाच Big-O म्हणतात, म्हणजे शाळा वाढण्याआधीच खर्च कळतो.
Big-O शिवाय शाळा दुप्पट झाल्यावर program अचानक चारपट वेळ घेतो तेव्हाच तो slow आहे हे कळते.
n वाढला की steps कसे वाढतात त्याच्या आकाराला Big-O नाव देते: O(1), O(log n), O(n), O(n log n), O(n²).
constants काढा आणि सर्वात मोठे पद ठेवा: 3n + 5 म्हणजे O(n), n² + n म्हणजे O(n²), आणि x in list worst case मध्ये O(n).
1,000 चे 2,000 विद्यार्थी झाले तर O(log n) ला फक्त +1 look, पण O(n²) ला ×4 काम; म्हणून आकारच पुढचा खर्च ठरवतो.
arrays पासून graphs पर्यंत पुढचा प्रत्येक lesson याच एका मापाने तपासला जातो: n दुप्पट झाला की खर्च कसा वाढतो?
2 🗄️ Arrays & strings
लॉकर्सची रांग — लॉकर 17 वर एका पावलात; पुढे घातले की सगळे सरकतात; two pointers आणि sliding window.
शाळेचे lockers एकाच क्रमांकित रांगेत आहेत, सगळे एकाच आकाराचे. locker 17 गाठायला इतर lockers ओलांडावे लागत नाहीत; एका step मध्ये थेट तिथे जाता येते. पण locker 0 मध्ये नवा विद्यार्थी घुसवला तर प्रत्येकाला एक locker पुढे सरकावे लागते, म्हणून सुरुवातीला जोडणे हळू आणि शेवटी जोडणे जलद.
क्रमांक असलेले lockers नसतील तर slot 3 मधला विद्यार्थी शोधायला सुरुवातीपासून प्रत्येक locker पार करावा लागतो.
array म्हणजे शेजारी-शेजारी ठेवलेली समान आकाराच्या lockers ची रांग, त्यामुळे कोणताही index एका step मध्ये मिळतो.
address = start + index × size, म्हणून lockers[3] एका step मध्ये Meera देतो, पण insert(0) सर्व n items सरकवतो: O(n).
index ने जलद वाचन, शेवटी O(1) append, आणि two pointers सारख्या युक्त्या O(n²) शोध एका O(n) pass मध्ये आणतात.
insert करताना सरकवणे महाग पडते तेव्हा पुढचा lesson linked lists वापरून index jump च्या बदल्यात स्वस्त insert देतो.
3 🧵 Linked lists
खजिन्याचा शोध — प्रत्येक चिठ्ठी सांगते पुढची कुठे; चिठ्ठी जोडायला O(1), शोधायला O(n), उडी नाही; जागच्या जागी उलटी करा.
treasure hunt मध्ये प्रत्येक चिठ्ठी पुढची चिठ्ठी कुठे लपवली आहे ते सांगते. सुरुवातीला नवी चिठ्ठी जोडणे सोपे: ती लिहा, जुन्या पहिल्या चिठ्ठीकडे दाखवा, आणि बाकी कोणीच हलत नाही. पण चौथी चिठ्ठी गाठायला आधीच्या तीन वाचाव्या लागतात, कारण चिठ्ठ्यांना थेट उडी मारता येईल असे क्रमांक नसतात.
array मध्ये पुढे एक विद्यार्थी जोडला तर बाकी सर्व lockers सरकतात, n विद्यार्थ्यांसाठी n moves.
linked list म्हणजे चिठ्ठ्यांचा treasure hunt, जिथे प्रत्येक चिठ्ठीत value आणि पुढच्या चिठ्ठीकडे pointer असतो.
push_front एक नवी चिठ्ठी जुन्या head कडे point करून लिहितो आणि head तिच्याकडे हलवतो: O(1), पण Meera शोधणे O(n).
हातातल्या चिठ्ठीजवळ जोडणे किंवा काढणे O(1) आहे आणि array insert सारखे इतर कोणीही सरकत नाही.
जोडलेले nodes पुढच्या lessons मधल्या stacks, queues, trees आणि graphs चे मूळ घटक बनतात.
4 🥞 Stacks & queues
ट्रेची चळत आणि जेवणाची रांग — LIFO आणि FIFO; brackets, undo, call stack; रांग सोडणे O(1) व्हावे म्हणून ring buffer.
canteen मध्ये स्वच्छ trays चा ढीग असतो आणि तुम्ही नेहमी वरचा tray घेता: शेवटी ठेवलेला tray आधी उचलला जातो. जेवणाची रांग उलट: आधी आलेल्याला आधी जेवण. computers दोन्ही सतत वापरतात, undo बटणासाठी आणि वाट पाहणाऱ्या पाळ्यांसाठी, आणि ring buffer मुळे कोणालाही न सरकवता रांग पुढे जाते.
lunch line साठी list.pop(0) वापरले तर प्रत्येक वेळी सर्वांना पुढे सरकवावे लागते: प्रत्येक जाण्याला O(n).
stack म्हणजे trays चा ढीग, शेवटी आलेला आधी बाहेर (LIFO); queue म्हणजे lunch line, आधी आलेला आधी बाहेर (FIFO).
push, pop, peek फक्त top ला हात लावतात: O(1); ring buffer मध्ये (i + 1) % 8 ने head आणि tail हलतात, कोणी सरकत नाही.
bracket matching, undo, call stack आणि न्याय्य रांगा हे सर्व यांच्यावर चालते, प्रत्येक operation O(1) मध्ये.
recursion मध्ये call stack पुन्हा येतो, आणि lesson 10 मध्ये graphs शोधताना queue BFS चालवते.
5 🗂️ Hash maps & sets
नावानुसार कप्पे — hash(name) सांगते कोणता कप्पा; सरासरी O(1); collisions, rehashing, मोजणी, dedupe.
शाळेच्या office मध्ये pigeonholes आहेत. प्रत्येक कप्पा शोधण्याऐवजी एक नियम विद्यार्थ्याच्या नावाचा box क्रमांक बनवतो, म्हणून तुम्ही थेट Meera च्या box कडे जाता. कधी दोन नावे एकाच box मध्ये येतात; हरकत नाही, एक-दोन cards तपासायचे. boxes खूप भरले की office त्यांची संख्या दुप्पट करते आणि सगळ्यांना एकदा पुन्हा मांडते.
साध्या list मध्ये नावाने विद्यार्थी शोधायचा तर तो सापडेपर्यंत प्रत्येक card वाचावे लागते: प्रत्येक वेळी O(n).
hash map प्रत्येक item त्याच्या नावावरून ठरलेल्या pigeonhole मध्ये ठेवतो, म्हणून key ने शोध सरासरी O(1).
hash(name) % 8 box निवडतो; collision झाले तर एकाच box मध्ये दोन cards, आणि load 0.75 झाला की 16 boxes करून पुन्हा मांडणी.
शब्द मोजणे, duplicates काढणे आणि नावाने शोधणे एका pass मध्ये होते, म्हणूनच dict आणि set सगळीकडे दिसतात.
वाईट hash सर्वांना एकाच box मध्ये टाकतो आणि O(n) परत येतो, म्हणून खऱ्या systems चांगले hash निवडून load factor पाहतात.
6 🪆 Recursion
मुख्याध्यापक उपमुख्याध्यापकांना विचारतात, ते शिक्षकांना — base case, एक लहान प्रश्न, call stack; फळ्याशिवाय fib का फुटते.
मुख्याध्यापकांना 5! हवा, ते उपमुख्याध्यापकांना 4! विचारतात, ते एका शिक्षकांना 3!, असे 1! = 1 पर्यंत, जे सगळ्यांना माहीत आहे. मग उत्तरे परत वर जातात: 1, 2, 6, 24, 120. हेच recursion: त्याच प्रश्नाची छोटी आवृत्ती विचारून काम सोडवणे. पण उत्तरे लिहायला फळा नसेल तर fib तेच प्रश्न पुन्हा पुन्हा विचारतो.
काही प्रश्न, जसे 5!, हे त्याच प्रश्नाचे लहान रूप असतात, आणि त्यांना हाताने loop म्हणून लिहिणे अवघड होते.
recursion म्हणजे function जो base case पर्यंत पोहोचेपर्यंत स्वतःलाच लहान प्रश्न विचारून उत्तर देतो.
fact(5) fact(4) ला विचारतो, असे 1! = 1 पर्यंत; पाच frames call stack वर थांबतात आणि उत्तरे 120 पर्यंत वर परत येतात.
stack depth आणि पुन्हा पुन्हा होणारे काम लक्षात ठेवले तर tree आणि divide-and-conquer code छोटा आणि स्पष्ट होतो.
board शिवाय fib हा fib(3) वगैरे पुन्हा विचारतो; हाच अपव्यय lesson 11 मधले dynamic programming काढून टाकते.
7 📶 Sorting
वर्गाची उंचीनुसार रांग — bubble आणि insertion (n²), merge आणि quick (n log n), stability, आणि तुम्ही sorted() का बोलावता.
वर्गाला उंचीप्रमाणे रांगेत उभे करा. शेजाऱ्यांची पुन्हा पुन्हा अदलाबदल करणे चालते, पण 2,000 विद्यार्थ्यांसाठी सुमारे 20 लाख तुलना लागतात. merge sort वर्गाचे अर्धे भाग करतो, प्रत्येक भाग क्रमाने लावतो, मग दोन क्रमाने लावलेल्या रांगा एकत्र गुंफतो, खूप कमी तुलनांत. sorting महत्त्वाचे कारण क्रमाने लावलेल्या list मध्ये शोधणे आणि गट करणे जलद होते.
शेजारी अदलाबदल करून 2,000 विद्यार्थी रांगेत लावायला सुमारे वीस लाख तुलना लागतात, आणि n दुप्पट झाला की चारपट.
sorting म्हणजे items क्रमाने लावणे; bubble आणि insertion sort O(n²) आहेत, तर merge sort आणि quicksort O(n log n).
merge sort रांग log n levels पर्यंत अर्धी करतो, मग प्रत्येक level वर n काम करून sorted अर्धे जोडतो: n log n.
sorted data मुळे binary search आणि सोपे grouping शक्य होते, आणि stability समजली तर equal keys चा क्रम टिकतो का ते कळते.
खऱ्या code मध्ये तुम्ही sorted() वापरता, जो stable n log n sort आहे, आणि तुमची मेहनत योग्य key निवडण्यात जाते.
8 🔍 Binary search
क्रमाने लावलेली नोंदवही — मधोमध उघडा, अर्धी फेकून द्या, 50,000 नावांसाठी जास्तीत जास्त 16 नजरा; उत्तरावर search.
क्रमाने लावलेल्या हजेरीपटात नाव शोधायला तो मध्यभागी उघडा. नाव आधी येत असेल तर मागचा अर्धा भाग बाजूला टाका; नंतर येत असेल तर पुढचा. असे अर्धे करत राहिले तर 50,000 नावांसाठीही जास्तीत जास्त 16 वेळा पाहावे लागते. हे फक्त हजेरीपट क्रमाने लावलेला असल्यामुळेच चालते.
register मध्ये एकेक ओळ वाचून नाव शोधले तर 50,000 नावांसाठी 50,000 पर्यंत looks लागतात.
binary search sorted list मध्ये मध्य उघडून दर वेळी अर्धा भाग टाकून item शोधतो: O(log n).
37 शोधताना: mid 42 डावा भाग ठेवतो, mid 18 मुळे 25 ते 37, mid 31 नंतर फक्त 37 उरतो; 4 looks मध्ये index 6.
register sorted ठेवले तर 50,000 नावांसाठी जास्तीत जास्त 16 looks आणि दहा लाखांसाठी फक्त 20.
हीच अर्धे करण्याची कल्पना थेट उत्तरावर search करू देते, आणि lesson 9 मधल्या balanced trees मध्येही तीच आहे.
9 🌳 Trees & heaps
कॅटलॉगचा खण आणि व्यासपीठ — BST insert आणि search, in-order चाल, balance का महत्त्वाचा; heap सगळ्यात लहान वर ठेवतो.
ग्रंथालयाच्या catalogue drawer मध्ये लहान क्रमांक डावीकडे आणि मोठे उजवीकडे जातात, म्हणून प्रत्येक वेळी पाहताना उरलेल्यापैकी अर्धे वगळले जाते. पण आधीच क्रमाने असलेली cards जोडली तर tree एक लांब रांग बनते आणि वेग जातो, म्हणून ते balanced राहायला हवे. heap म्हणजे podium: सर्वात लहान नेहमी वर, आधी उचलायला तयार.
sorted array मध्ये शोध जलद पण प्रत्येक insert मध्ये items सरकतात, आणि साध्या list मध्ये सर्वात लहान शोधायला सर्व वाचावे लागते.
BST लहान keys डावीकडे आणि मोठ्या उजवीकडे ठेवतो; heap हा tree नेहमी सर्वात लहान value वर ठेवतो.
search(37): 50 वरून डावीकडे, 25 वरून उजवीकडे, 3 looks मध्ये सापडले; array मधल्या heap मध्ये i ची मुले 2i+1 आणि 2i+2 वर.
balanced trees O(log n) search आणि insert तसेच मोफत sorted walk देतात, आणि heap पुढचा सर्वात लहान पटकन देतो.
1 ते 7 क्रमाने घातले तर height 7 ची list बनते, म्हणून खऱ्या systems AVL सारखे self-balancing trees वापरतात.
10 🗺️ Graphs
कॉरिडॉरचा नकाशा — adjacency lists, BFS hops ने पसरतो, DFS एक कॉरिडॉर धरतो, Dijkstra मोजतो, cycles.
शाळेचा नकाशा म्हणजे corridors ने जोडलेल्या खोल्या. gym पर्यंत सर्वात कमी corridors शोधायला office पासून एकेक फेरी बाहेर पसरा (BFS). सर्वात कमी मीटर शोधायला अजून निश्चित न झालेली सर्वात जवळची खोली निवडत राहा (Dijkstra). दोन्ही वेगळे उत्तर देऊ शकतात: lab मार्गे gym 65 m, पण library मार्गे 90 m.
rooms आणि corridors एका रांगेत किंवा tree मध्ये बसत नाहीत, म्हणून graphs शिवाय gym कडे सर्वात छोटा रस्ता विचारताही येत नाही.
graph म्हणजे corridors (edges) ने जोडलेल्या rooms (vertices) चा संच, जो neighbours च्या adjacency list मध्ये साठवला जातो.
BFS hops ने पसरतो, DFS एक corridor खोलवर पकडतो, आणि Dijkstra metres मोजून office ते gym चा 65 m रस्ता शोधतो.
सर्वात कमी hops आणि सर्वात कमी metres वेगळे असू शकतात, म्हणून BFS आणि Dijkstra मधला फरक कळला तर नेमक्या प्रश्नाचे उत्तर मिळते.
maps, networks, build systems आणि friend lists हे सर्व graphs आहेत, म्हणून हे walks खऱ्या software मध्ये सगळीकडे दिसतात.
11 🧠 Dynamic programming & greedy
फळ्यावरची उत्तरे — memoisation आणि tabulation (पायऱ्या, नाणी); greedy: आधी संपणारी meeting घ्या.
एका वेळी 1 किंवा 2 पायऱ्या चढत 8 पायऱ्या किती प्रकारे चढता येतील? खालून सुरू करा आणि प्रत्येक उत्तर फळ्यावर लिहा: प्रत्येक नवे उत्तर म्हणजे आधीच्या दोनांची बेरीज, म्हणून काहीच दोनदा मोजावे लागत नाही. greedy म्हणजे आत्ता सर्वात चांगला दिसणारा पर्याय घेणे; आधी संपणारी meeting निवडताना ते चालते, पण 1, 3, 4 च्या coins ने 6 बनवताना चुकते.
साधे recursion तेच छोटे प्रश्न पुन्हा पुन्हा सोडवते, म्हणून stairs(n) किंवा fib(n) exponentially वाढतो.
dynamic programming प्रत्येक छोटे उत्तर board वर एकदाच लिहून पुन्हा वापरते; greedy आत्ता सर्वात चांगली दिसणारी पायरी घेतो.
board खालून वर भरा: s(5) = s(4) + s(3) = 5 + 3, प्रत्येक cell एकदाच लिहिली जाते, म्हणून stairs O(n) होतो.
coins [1, 3, 4] ने 6 बनवताना DP 2 coins (3 + 3) शोधते, greedy 4 + 1 + 1 घेतो; म्हणून greedy कधी सुरक्षित ते कळते.
board ची ही विचारपद्धत diff tools, route planners आणि schedulers चालवते, आणि लवकर संपणारी meeting सारखा greedy सिद्ध झाल्यावर जिंकतो.
12 🎯 योग्य structure निवडणे
प्रश्न ठरवतो — complexity cheat sheet, निर्णय तक्ता, मुलाखतीची पद्धत, आणि कळस-प्रकल्प.
काहीही बनवण्याआधी प्रश्न मोठ्याने बोला. '5 वा विद्यार्थी दे' म्हणजे array; 'नावाने शोध' म्हणजे hash map; 'पुढचा सर्वात लहान कोण' म्हणजे heap; 'खोल्या आणि corridors' म्हणजे graph. प्रश्नच structure निवडतो, आणि योग्य structure हळू कामाला जलद बनवते.
दहा structures माहीत असूनही नवीन प्रश्नासमोर कोणता हवा हे ओळखता आले नाही तर उपयोग नाही.
प्रश्न काय विचारतो आणि कोणता structure त्याचे उत्तर देतो, त्याच्या Big-O खर्चासह, हे जोडणारे decision table.
i-th गोष्ट म्हणजे array O(1), नावाने म्हणजे hash map O(1) avg, पुढचा लहान म्हणजे heap O(log n), rooms म्हणजे graph O(V+E).
प्रश्न मोठ्याने बोला आणि structure स्वतः उत्तर देतो; हीच पद्धत coding interviews मध्येही कामी येते.
आधी brute force लिहा, मग pattern ओळखा; capstone आणि प्रत्येक खरा design review याच सवयीने चालतो.