🏎️ शाळेच्या पद्धतीने performance engineering शिका
एक program किंवा service वेगवान कशी करायची, हे शाळेच्या क्रीडा दिनाच्या रूपात शिकवले आहे: अंतिम रेषेवरचे स्टॉपवॉच, धावण्याचा ट्रॅक, रिलेमधील बॅटन-बदल, पाण्याच्या टेबलावरची रांग आणि रिलेतील सर्वात हळू धावपटू. प्रत्येक धडा म्हणजे शाळेतील एक गोष्ट, सोबत काढलेली आकृती आणि एक lab — आणि क्रीडा दिन repo मध्येच आहे: pure Python मधील deterministic models (perf/sim.py, शून्य dependencies), ज्यात खरे cProfile call counts, खरे tracemalloc, खरे SQLite query plans आणि simulated खर्च आहेत, त्यामुळे प्रत्येक run तेच आकडे छापतो.
⏱️ भाग 1 — मोजमाप (1–4)
- स्टॉपवॉच ⏱️
- warm-up आणि अनेक फेऱ्या 🏁
- प्रशिक्षिकेचा clipboard 📋
- जोडीने तपासा की आधी क्रमाने लावा 📈
🔧 भाग 2 — नेहमीचे उपाय (5–8)
- एका वेळी एक अडथळा 🎒
- scoreboard लक्षात ठेवतो 🗂️
- मैदानावर कमी फेऱ्या 🔁
- एक बॅटन, अनेक धावपटू 🧵
🏟️ भाग 3 — संपूर्ण system (9–12)
- पाण्याच्या टेबलावरची रांग 🚰
- index कार्डांची पेटी 🗃️
- फोनवरचे page 📱
- पात्रता वेळा 🏆
# the 60-second wow — one program, measured and made fast:
git clone https://github.com/BaluRaut/learn-performance-school.git && cd learn-performance-school
python3 perf/demo.py               # 12 lessons: stopwatches, hot spots, N+1, the GIL, queues, query plans, budgets
python3 perf/test_perf.py          # 12 checks across the lessons
तुम्हाला काय दिसायला हवे (छाटलेले — यश असे दिसते):
═══ latency ═══
── 1000 requests timed by the finish-line stopwatches (ms per request = latency)
   mean 51.3 · p50 40 · p95 59 · p99 260 · max 1364
   37 of 1000 took 100 ms or more · 7 took 800 ms or more — the tail
   the mean (51.3) describes nobody: most finish near 40, a few take far longer
── throughput = finishers per second: one lane at 40 ms a lap → 25/s · four lanes → 100/s · each lap is still 40 ms
   a page that waits for   1 call(s): 1.0% of page loads meet at least one call slower than its p99
   a page that waits for  10 call(s): 9.6% of page loads meet at least one call slower than its p99
   a page that waits for 100 call(s): 63.4% of page loads meet at least one call slower than its p99
   report percentiles, not the mean — and remember the p99 of each call becomes common in a big fan-out

═══ bench ═══
── Katrina times version A 20 times (simulated stopwatch): first three runs [42.1, 31.7, 21.6] ms — cold, warming up
   one run says 42.1 ms · the mean of all 20 says 15.5 ms · after 3 warm-up runs, the median of 17 says 12.4 ms
   spread of the 17: min 11.2 · p25 11.7 · median 12.4 · p75 12.7 · max 19.9 (one spike: another program woke up)
── A vs B1 (a small tweak): medians 12.4 vs 12.0 ms · middle halves 11.7–12.7 vs 11.3–12.3 → no clear difference: the change is smaller than the noise
── A vs B2 (a real fix): medians 12.4 vs 8.1 ms · middle halves 11.7–12.7 vs 7.8–8.4 → B is faster (1.53x)
   warm up, repeat, report the median and the spread; claim a win only when it is bigger than the noise

═══ profile ═══
── Dipika profiles the results program with cProfile: 300 runners, 2000 laps (we read CALL COUNTS, not times)
   find_runner 2000× · best_of 4× · results_slow 1×
   find_runner walks the runner list every time: 297,098 comparisons for 2000 lookups — the hot spot
── fix: build a dict by bib once →   best_of 4× · results_fast 1×
   find_runner comparisons now 0 · same results: True · best 100 m per house (ms) {'blue': 11000, 'green': 11006, 'red': 11006, 'yellow': 11005}
   measure first: the slow part is rarely where you guessed, and one hot function is usually most of it

═══ complexity ═══
── any duplicate bib numbers? three ways, counting comparisons (no duplicates, so each does its full work)
       n   every pair O(n²)   sort + neighbours O(n log n)   a set O(n)
     250             31,125                          1,921          250
     500            124,750                          4,355          500
    1000            499,500                          9,724        1,000
    2000          1,999,000                         21,436        2,000
   double n: every pair does 4× the work · sorting a little over 2× · the set exactly 2×
   big-O is how the work GROWS; at n = 2000 the pairwise way already does 93× the comparisons of sorting

═══ memory ═══
── the sum of squares of 0..99,999: a list holds every result, a generator makes one at a time
   same answer: True (333,328,333,350,000)
   results held at once: list 100,000 · generator 1
   tracemalloc peak: the list needs over 100× the generator's memory: True
   stream data you only walk through once; keep a list when you need it again, in any order, or its length

═══ caching ═══
── fib(25) = 75025: plain recursion does the work 242,785 times · memoized (lru_cache) 26 times (23 cache hits)
── parents look up results: 2000 requests over 500 runners, a few asked for far more often · a hit costs 1 ms, a miss 50 ms
   LRU cache of  10 → hit ratio 15.4% · average 42.5 ms per request
   LRU cache of  50 → hit ratio 33.0% · average 33.9 ms per request
   LRU cache of 100 → hit ratio 44.9% · average 28.0 ms per request
   LRU cache of 250 → hit ratio 67.7% · average 16.8 ms per request
   a cache is only as good as its hit ratio — and every cached answer can be stale until it is refreshed

═══ io ═══
── best lap for each of 50 runners, from SQLite (sqlite3's trace callback counts the queries)
   N+1: one query for the runners, then one per runner → 51 queries
   batched with IN (...)                            → 2 queries
   one JOIN + GROUP BY                              → 1 query · same answer all three ways: True
   at 1 ms round trip to a database server: 51 ms vs 2 ms vs 1 ms of waiting (here SQLite is in-process)
── writing 10,000 result lines (210,000 bytes) unbuffered     → 10,000 raw writes
── writing 10,000 result lines (210,000 bytes) buffered (8 KB) → 26 raw writes
   every trip costs a fixed toll: carry many things per trip

═══ concurrency ═══
── 8 tasks · I/O-bound: 5 ms of Python + 100 ms waiting for a reply · CPU-bound: 100 ms of Python (a teaching model)
                                             I/O-bound   CPU-bound
   one after another                           840 ms      800 ms
   8 threads, one baton (the GIL)              140 ms      800 ms
   asyncio, 1 thread, 8 tasks                  140 ms      800 ms
   4 processes on 4 cores (+50 ms start)       260 ms      250 ms
   8 threads, free-threaded build, 4 cores     110 ms      200 ms
   waiting needs no baton: threads and asyncio overlap the waits · Python work needs the baton: processes, or a free-threaded build
   (the GIL is released while waiting on I/O and inside many C extensions; free-threaded CPython exists since 3.13)

═══ queueing ═══
── one water table, 10 ms to serve a runner · M/M/1 approximation: time at the table = 10 ms ÷ (1 − utilisation)
   utilisation 50% → formula     20 ms · simulated (20,000 runners)     20 ms
   utilisation 80% → formula     50 ms · simulated (20,000 runners)     49 ms
   utilisation 90% → formula    100 ms · simulated (20,000 runners)    104 ms
   utilisation 95% → formula    200 ms · simulated (20,000 runners)    186 ms
   utilisation 99% → formula   1000 ms · simulated (20,000 runners)    519 ms
   near 100% busy, the wait explodes (and a short simulation has not caught up with it yet)
── Little's law L = λW: 80 runners/s × 50 ms = 4 runners at the table on average
── Amdahl's law: 90% of the relay can be shared out, 10% is one runner's leg that nobody can help with
   2 runners → 1.82× · 4 runners → 3.08× · 8 runners → 4.71× · 16 runners → 6.40× · endless runners → 10.00×
   keep utilisation well below 100% for low latency · speed up the serial part, it caps everything

═══ database ═══
── 10,000 laps, 500 runners · EXPLAIN QUERY PLAN for: SELECT lap_ms FROM laps WHERE runner_id = ?
   no index            → SCAN laps   (reads all 10,000 rows)
   index on runner_id  → SEARCH laps USING INDEX idx_laps_runner (runner_id=?)   (jumps to runner 42's 20 rows)
   index on (runner_id, lap_ms) → SEARCH laps USING COVERING INDEX idx_laps_runner_ms (runner_id=?)
   covering: every column the query needs is in the index, so the table itself is never read
   runners WHERE name = 'runner042'         → SEARCH runners USING COVERING INDEX idx_runners_name (name=?)
   runners WHERE lower(name) = 'runner042'  → SCAN runners
   runners WHERE name LIKE '%042'           → SCAN runners
   a function on the column or a leading % hides the index; read the plan before and after every change

═══ web ═══
── the sports-day results page on a phone: 150 ms round trip, 500 KB/s (a teaching model of one page load)
   as built: 30 KB HTML, 80 KB CSS, 900 KB JS, 1200 KB hero image   LCP  5020 ms (poor) ·   2210 KB
   + compress text (gzip/Brotli, text to about 25%)                 LCP  3505 ms (needs improvement) · 1452.5 KB
   + defer the script (no longer blocks the first paint)            LCP  3055 ms (needs improvement) · 1452.5 KB
   + resize the hero and serve AVIF (1200 → 200 KB)                 LCP  1055 ms (good) ·  452.5 KB
   repeat visit: files cached, the HTML revalidated (304)           LCP   450 ms (good) ·      0 KB
   (hashed files: Cache-Control: max-age=31536000, immutable · the HTML: Cache-Control: no-cache)
── CLS: an image with no width/height pushes the text down a quarter of the screen → 0.1875 (needs improvement) · with width/height set → 0.0 (good)
── INP: a tap runs 300 ms of script in one piece → 316 ms (needs improvement) · in 50 ms chunks that yield → 66 ms (good)
   Core Web Vitals (75th percentile of real visits): LCP ≤ 2.5 s · INP ≤ 200 ms (replaced FID in March 2024) · CLS ≤ 0.1

═══ budgets ═══
── a load test (simulated, open model): one server, 10 ms per request, capacity about 100 requests/s
    50 req/s → p50    14 ms · p95    60 ms · p99    98 ms
    70 req/s → p50    25 ms · p95   109 ms · p99   160 ms
    90 req/s → p50    64 ms · p95   280 ms · p99   411 ms
   110 req/s → p50  1716 ms · p95  3122 ms · p99  3187 ms
   the knee: past about 80% busy, p95 climbs fast · above capacity the queue only grows
── budget check, before the fixes: SQL queries per page 51 / 5 ❌ · LCP ms (simulated) 5020 / 2500 ❌ · page weight KB 2210 / 500 ❌ · p95 ms at 70 req/s 109 / 100 ❌ → FAIL (the CI job exits 1)
── budget check, after the fixes : SQL queries per page 1 / 5 ✅ · LCP ms (simulated) 1055 / 2500 ✅ · page weight KB 452.5 / 500 ✅ · p95 ms at 70 req/s 23 / 100 ✅ → PASS
   (after: the profiled fix is assumed to cut the service time from 10 ms to 5 ms — an input of the model)
   budget counts (queries, bytes, calls) in CI — they do not flake like timings; time things on a quiet, fixed machine
── the whole picture: measure → profile → fix the algorithm → memory, caching, I/O, concurrency → queues → queries → the page → budgets

✅ done — every runner timed, the relay is faster🗺️ संपूर्ण चित्र — एक आकृती, पूर्ण कोर्स
संपूर्ण कोर्स एका कॅनव्हासवर. 4K आवृत्तीसाठी क्लिक करा.
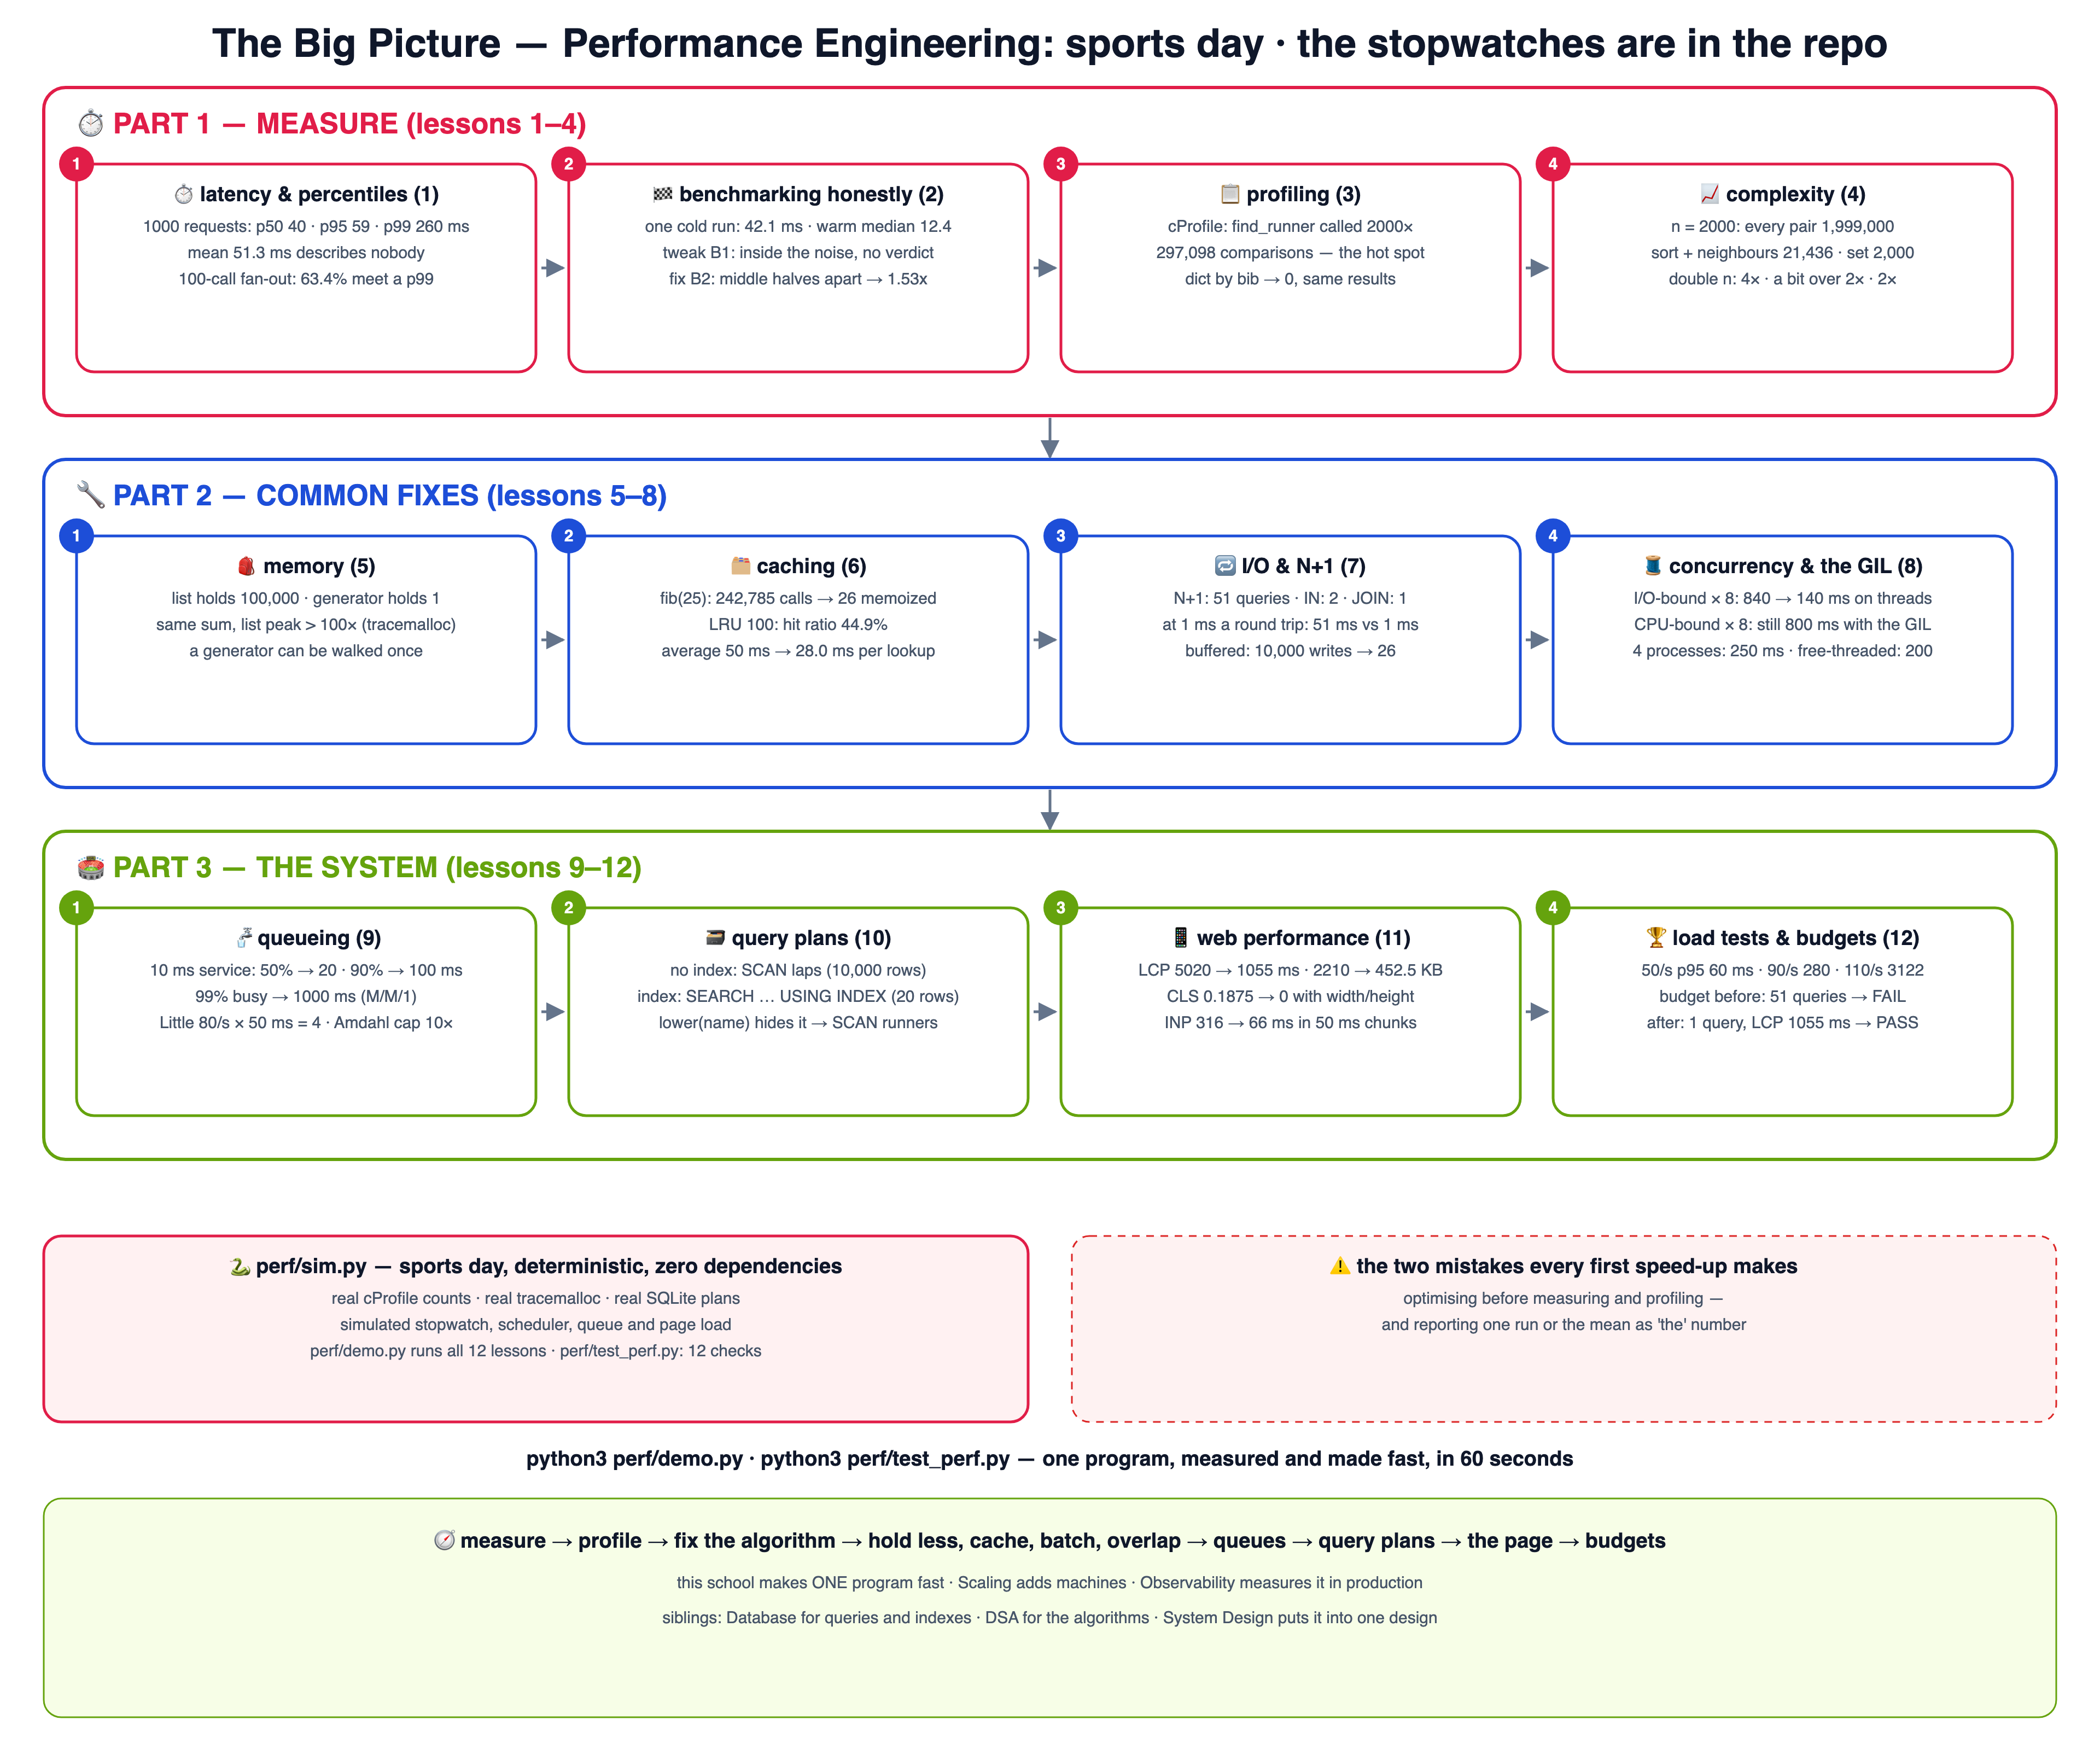
⏱️ भाग 1 — मोजमाप (धडे 1–4)
एक git branch = एक कल्पना; branch 04 मध्ये धडे 01–04 आहेत. perf/ चा प्रत्येक run सारखाच असतो — खर्च simulated आणि seeded आहेत, आणि lab घड्याळाच्या वेळा नव्हे तर counts वाचते.
⏱️ Latency आणि percentiles
lesson-01-latency-percentilesधडा वाचा →आकृती पहा ↗🏁 प्रामाणिक benchmarking
lesson-02-benchmarkingधडा वाचा →आकृती पहा ↗📋 Profiling
lesson-03-profilingधडा वाचा →आकृती पहा ↗📈 व्यवहारातील complexity
lesson-04-complexityधडा वाचा →आकृती पहा ↗🔧 भाग 2 — नेहमीचे उपाय (धडे 5–8)
पुन्हा पुन्हा लागणारे उपाय: कमी धरून ठेवा, दोनदा गणना करू नका, कमी फेऱ्या करा, वाट पाहणे एकमेकांवर चढवा (overlap).
🎒 Memory
lesson-05-memoryधडा वाचा →आकृती पहा ↗🗂️ Caching आणि memoization
lesson-06-cachingधडा वाचा →आकृती पहा ↗🔁 I/O, N+1 आणि batching
lesson-07-io-batchingधडा वाचा →आकृती पहा ↗🧵 Concurrency आणि GIL
lesson-08-concurrencyधडा वाचा →आकृती पहा ↗🏟️ भाग 3 — संपूर्ण system (धडे 9–12)
तुमच्या code भोवतीची service: queues, database, browser, आणि load tests व budgets वापरून ती वेगवान ठेवणे.
🚰 Queueing, Little आणि Amdahl
lesson-09-queueingधडा वाचा →आकृती पहा ↗🗃️ Database query performance
lesson-10-database-queriesधडा वाचा →आकृती पहा ↗📱 Web performance
lesson-11-web-performanceधडा वाचा →आकृती पहा ↗🏆 Load tests, budgets आणि संपूर्ण चित्र
lesson-12-load-testing-budgetsधडा वाचा →आकृती पहा ↗📐 धड्यांच्या आकृत्या — क्रमांक अनुसरा
प्रत्येक धडा एका क्रमांकित बॉक्स-आणि-बाण आकृतीत — स्वतंत्र पानावरही.
1 ⏱️ Latency आणि percentiles
Latency विरुद्ध throughput, आणि mean हळू धावपटूंना का लपवतो — p50, p95, p99 आणि tail.
आज शाळेचा क्रीडा दिवस आहे. 1000 धावपटू प्रत्येकी एक फेरी धावतात, आणि कतरिना सगळ्यांची वेळ घेते. बहुतेक जण सुमारे 40 मध्ये पूर्ण करतात. काही अडखळतात, आणि मोजक्या जणांचा बूट निघतो, त्यांना 800 पेक्षा जास्त लागतात. सरासरी 51 येते, पण कोणीच 51 मध्ये धावले नाही! म्हणून कतरिना वेळा रांगेत लावते आणि मधली (40) आणि हळू टोकाची (260) वाचते.
Teams dashboard वर एकच सरासरी response time दाखवत, आणि काही users एक second पेक्षा जास्त थांबले तरी ते ठीक दिसत असे.
Latency म्हणजे एका धावपटूला लागणारा वेळ; throughput म्हणजे दर second किती पूर्ण करतात. Percentiles नेहमीचा वेळ आणि tail दाखवतात.
कतरिना 1000 धावपटूंची वेळ घेते: mean 51.3 ms, पण p50 40, p95 59, p99 260 आणि max 1364 ms. 37 जणांना 100 ms किंवा जास्त लागले.
Mean 51.3 कोणाचेच वर्णन करत नाही, आणि 100 calls ची वाट पाहणाऱ्या page ला 63.4% loads मध्ये p99 पेक्षा हळू call भेटतो.
पुढच्या धड्यात बदलाची प्रामाणिक वेळ घेतली जाते: warm-up फेऱ्या, अनेक heats, median आणि spread, आणि मगच विजयाचा दावा.
2 🏁 प्रामाणिक benchmarking
warm-up फेऱ्या, अनेक heats, median आणि पसारा — आणि खरा फायदा आवाजापासून (noise) कसा ओळखायचा.
नवे बूट ऐश्वर्याला जलद करतात का हे दीपिकाला जाणून घ्यायचे आहे. कतरिना तिची वेळ एकदाच घेते, सकाळी थंडीत: 42 seconds. नंतर: 12. बूटांमुळे नाही, फक्त शरीर गरम झाल्यामुळे! म्हणून त्या आधी warm-up फेऱ्या घेतात, मग अनेक heats, आणि मधली वेळ पाहतात. नव्या वेळा स्पष्टपणे कमी असतील तरच खरा विजय.
लोक code ची वेळ एकदाच घेत, 42.1 ms मग 12 ms पाहून नवीन version तिप्पट जलद म्हणत, खरे तर ते फक्त warm झाले होते.
प्रामाणिक benchmark warm-up runs सोडून देतो, अनेक heats घेतो, आणि median सोबत मधला अर्धा भाग (p25–p75) सांगतो.
कतरिना A 20 वेळा चालवते: पहिले runs 42.1, 31.7, 21.6 ms. Mean 15.5 ms म्हणतो; 17 warm runs चा median 12.4 ms म्हणतो.
B1 (12.0 विरुद्ध 12.4 ms) A शी overlap होतो, म्हणून तो noise आहे. B2 (8.1 ms, 7.8–8.4) overlap होत नाही: खरा 1.53x विजय.
पुढचा धडा विचारतो वेळ कुठे जातो: दीपिकाचा clipboard, cProfile, कोणते function किती वेळा चालते ते मोजतो.
3 📋 Profiling
प्रशिक्षिकेचा clipboard: काहीही बदलण्याआधी cProfile call counts दाखवतात की वेळ कुठे जातो.
Results छापायला खूप वेळ लागतो, आणि प्रत्येकाचा वेगळा अंदाज आहे. प्रशिक्षक दीपिका अंदाज करत नाही. ती clipboard घेते आणि प्रत्येक कामावर खूण करते. मोठ्या यादीत धावपटू शोधण्याला 2000 खुणा मिळाल्या, आणि प्रत्येक शोध 300 नावे एकेक करून पाहतो. म्हणून ती bib क्रमांकानुसार लावलेली card box बनवते, आणि हळू काम संपते.
Results हळू का छापले जातात याचा सगळे अंदाज करत: जुना printer, कठीण बेरजा. कोणी मोजले नाही, म्हणून उपाय चुकत.
Profiler प्रत्येक function call नोंदवतो. cProfile चे ncalls एकही ओळ बदलण्याआधी hot spot दाखवतात.
दीपिका 300 धावपटू आणि 2000 laps profile करते: find_runner 2000 वेळा चालते आणि 297,098 comparisons करते.
एकदाच बनवलेली bib नुसार dict प्रत्येक lookup एका झटक्यात करते: comparisons 0 होतात आणि results तेच राहतात.
पुढचा धडा काम कसे वाढते ते मोजतो: bibs जोडीने तपासणे, sort करून, किंवा set वापरून, n दुप्पट होताना.
4 📈 प्रत्यक्षातील Complexity
bib क्रमांक जोडी-जोडीने तपासणे विरुद्ध आधी sort करणे — O(n²) विरुद्ध O(n log n), मोजून.
प्रत्येक धावपटूला bib क्रमांक मिळतो, आणि कोणतेही दोन सारखे नसावेत. ऐश्वर्या तपासते. 2000 धावपटूंच्या प्रत्येक जोडीची तुलना केली तर जवळजवळ 20 लाख checks लागतात. आधी त्यांना क्रमाने लावले, म्हणजे सारखे क्रमांक शेजारी उभे राहतात, तर सुमारे 21,000. प्रत्येक क्रमांकासाठी एक चौकट असलेल्या tick sheet ला फक्त 2000. उत्तर एकच, काम खूप वेगळे.
250 test rows वर जलद असलेला code 2000 खऱ्या rows ला भेटला, आणि त्याचे काम कसे वाढते हे कोणी विचारले नव्हते.
Big-O सांगतो n सोबत काम कसे वाढते: प्रत्येक जोडी O(n²), sort करून पाहणे O(n log n), set म्हणजे O(n).
ऐश्वर्या 2000 bibs तपासते: प्रत्येक जोडीला 1,999,000 checks, sorting ला 21,436, आणि set ला 2,000 लागतात.
n दुप्पट केल्यास जोड्यांचे काम 4×, sorting थोडे जास्त 2×, set बरोबर 2× होते. 2000 वर जोड्या sorting च्या 93× काम करतात.
पुढचा धडा memory पाहतो: list मध्ये 100,000 hurdles एकदम बाहेर आणणे, की generator ने एका वेळी एक.
5 🎒 Memory
साहित्याची खोली: सगळे अडथळे एकदम की एका वेळी एक — lists, generators आणि tracemalloc.
Hurdles शर्यतीला साहित्याच्या खोलीतून 100,000 hurdles लागतात. एक पद्धत: सगळे आधी बाहेर आणायचे, आणि मैदान भरून जाते. दुसरी पद्धत: ऐश्वर्या एक hurdle आणते, धावपटू ते उडी मारून पार करते, आणि ती पुढचे आणते. शर्यत आणि उत्तर तेच, पण मैदानावर एका वेळी एकच असते. ते मोजायचे किंवा पुन्हा पाहायचे असतील तर पूर्ण ढीग लागतो.
Programs प्रत्येक result ची पूर्ण list बनवत, मग प्रत्येक एकदाच वापरत, आणि data वाढल्यावर memory संपत असे.
List सगळे items एकाच वेळी ठेवते; generator एका वेळी एक item बनवतो. tracemalloc सर्वात जास्त memory मोजते.
0..99,999 च्या वर्गांची बेरीज: list एकाच वेळी 100,000 results ठेवते, generator फक्त 1. दोन्हीचे उत्तर एकच येते.
tracemalloc दाखवते की त्याच 333,328,333,350,000 साठी list ला generator च्या 100× पेक्षा जास्त memory लागते.
पुढचा धडा काम दोनदा करणे थांबवतो: memoization आणि LRU scoreboard, आणि मदत होते का हे ठरवणारा hit ratio.
6 🗂️ Caching आणि memoization
scoreboard लक्षात ठेवतो: memoization, LRU cache, hit ratio — आणि शिळी उत्तरे.
पालक results office ला धावपटूंच्या वेळा विचारत राहतात. प्रत्येक वेळी ऐश्वर्या मागच्या खोलीत जाते आणि मोठे पुस्तक उघडते: 50 seconds. म्हणून ती दाराजवळ एक छोटा scoreboard लावते. उत्तर board वर असेल तर 1 second लागतो. बहुतेक पालक त्याच अंतिम फेरीतल्या धावपटूंबद्दल विचारतात, म्हणून छोटा board खूप मदत करतो. पण दुरुस्त केलेली वेळ board वर जुनीच राहू शकते.
पालक तेच थोडे प्रश्न पुन्हा पुन्हा विचारत असले तरी प्रत्येक request सगळे काम पुन्हा करत असे.
Cache आधी काढलेली उत्तरे ठेवतो. Memoization एका function ला cache करते; LRU cache सर्वात जास्त काळ न वापरलेले विसरतो.
fib(25) साधारण पद्धतीने 242,785 वेळा काम करते, lru_cache ने 26 वेळा. 100 चा LRU 44.9% hit करतो: सरासरी 28.0 ms.
Hit ला 1 ms आणि miss ला 50 लागतात, म्हणून hit ratio सगळे ठरवतो; 250 चा board 67.7% आणि 16.8 ms देतो.
पुढचा धडा मैदान ओलांडण्याच्या फेऱ्या मोजतो: N+1 queries, IN आणि JOIN ने batching, आणि buffered writes.
7 🔁 I/O, N+1 आणि batching
रिलेमधील प्रत्येक बॅटन-बदलाला एक फेरी लागते: N+1 queries, IN आणि JOIN वापरून batching, buffered writes.
दीपिकाला मैदानापलीकडच्या office मधून प्रत्येक धावपटूचा best lap हवा आहे. हळू पद्धत: यादीसाठी एक फेरी, मग प्रत्येक धावपटूसाठी एक फेरी. म्हणजे 51 फेऱ्या! चांगली: सगळ्या नावांची यादी घेऊन एक फेरी, 2 फेऱ्या. सर्वोत्तम: प्रत्येक धावपटू आणि त्याचा best lap एकदम मागणे, 1 फेरी. प्रत्येक फेरीला चालायलाच वेळ लागतो, म्हणून एका फेरीत अनेक गोष्टी न्या.
ORM loop एक ओळ दिसत असे पण प्रत्येक row साठी एक query चालवत असे; 3 test rows ला दिसत नसे, खऱ्या data ला हळू.
Database किंवा disk च्या प्रत्येक फेरीला ठराविक toll लागतो. Batching एका फेरीत अनेक गोष्टी नेते: IN, JOIN, write buffer.
50 धावपटूंचे best laps: N+1 51 queries चालवते, IN (...) 2, एक JOIN 1. 10,000 ओळी: 10,000 raw writes, किंवा buffered 26.
प्रत्येक round trip ला 1 ms असेल तर 51 ms विरुद्ध 2 ms विरुद्ध 1 ms थांबणे, आणि N+1 प्रत्येक नव्या धावपटूसोबत वाढते.
पुढचा धडा थांबणे एकमेकांवर आणतो: threads, asyncio आणि processes, आणि GIL, track वरचा एकच baton.
8 🧵 Concurrency आणि GIL
एक बॅटन, अनेक धावपटू: CPU-bound विरुद्ध I/O-bound, threads, asyncio, processes आणि GIL.
Relay संघात 8 धावपटू आणि एकच baton आहे, आणि फक्त baton हातात असलेलीच धावू शकते. पाण्याच्या टेबलाच्या कामात प्रत्येक जण थोडे धावते, मग पाण्याची वाट पाहते, आणि वाट पाहायला baton लागत नाही. म्हणून आठही जणी एकत्र थांबतात: सुमारे 140, 840 नाही. Sprints ला पूर्ण वेळ baton लागतो, म्हणून ते 800 घेतात. जलद sprints साठी जास्त tracks वापरा, प्रत्येकाचा स्वतःचा baton.
Programs एका वेळी एकच task करत आणि network कडून प्रत्येक उत्तराची वाट पाहत रिकामे बसत.
GIL म्हणजे एकच baton: एका वेळी एकच thread Python चालवतो. I/O ची वाट पाहायला baton लागत नाही; processes स्वतःचा आणतात.
5 ms Python आणि 100 ms थांबणे असे 8 tasks: एकामागून एक 840 ms, threads किंवा asyncio ने 140 ms, free-threaded 110 ms.
100 ms Python चे 8 tasks GIL खाली threads ने 800 ms घेतात, पण 4 processes वर 250 ms आणि free-threaded 200 ms.
पुढचा धडा पाण्याच्या टेबलाजवळ उभा राहतो: 100% busy जवळ थांबणे का वाढते, Little's law आणि Amdahl चा सर्वात हळू टप्पा.
9 🚰 रांगा, Little आणि Amdahl
पाण्याच्या टेबलावरची रांग: utilisation विरुद्ध प्रतीक्षा, Little चा नियम, आणि Amdahl चा सर्वात हळू धावपटू.
पाण्याचे एकच टेबल आहे, आणि ऐश्वर्या 10 seconds मध्ये cup भरते. धावपटू अधूनमधून आले तर प्रत्येकाला सुमारे 20 लागतात. टेबल 90% वेळ busy असेल तर सुमारे 100. 99% ला सुमारे 1000! धावपटू घोळक्याने येतात, आणि busy टेबल कधीच मागे पडलेले भरून काढत नाही. आणि relay मध्ये फक्त एकच धावपटू धावू शकेल असा एक टप्पा पूर्ण संघाला मर्यादा घालतो.
पैसे वाचवण्यासाठी servers 95% busy चालत, आणि traffic थोडे वाढल्यावर latency का उडी मारते हे कोणी सांगू शकत नसे.
Queueing theory busy असणे आणि थांबणे जोडते: वेळ = service ÷ (1 − utilisation). Little: L = λW. Amdahl speed-up ला मर्यादा घालतो.
ऐश्वर्या 10 ms मध्ये cup भरते: 50% busy असताना धावपटूला 20 ms, 90% ला 100 ms, 99% ला 1000 ms टेबलाजवळ लागतात.
80 धावपटू/s × 50 ms = टेबलाजवळ 4. 10% काम serial असेल तर अगणित धावपटू असले तरी जास्तीत जास्त 10.00× speed-up.
पुढचा धडा results office उघडतो: SQLite मध्ये EXPLAIN QUERY PLAN, scan, index आणि covering index.
10 🗃️ Database query performance
प्रत्येक निकालपत्रक शोधा की index वापरा: EXPLAIN QUERY PLAN, scans, indexes आणि covering indexes.
Results office मध्ये एका ढिगात 10,000 lap sheets आहेत. एक पालक runner 42 चे laps विचारतात. मदतीशिवाय ऐश्वर्या 20 शोधण्यासाठी प्रत्येक sheet वाचते. हा scan आहे. कतरिनाच्या runner क्रमांकानुसार लावलेल्या card box ने ती थेट 42 वर जाते आणि फक्त 20 sheets आणते. प्रत्येक card वर lap ची वेळ लिहिली असेल तर तिला sheets ची गरजच पडत नाही.
Queries लहान table वर ठीक चालत, मग production मध्ये 10,000 पैकी प्रत्येक row वाचत, आणि कोणी plan पाहिला नाही.
EXPLAIN QUERY PLAN database काय करेल ते दाखवतो: SCAN प्रत्येक row वाचतो, SEARCH USING INDEX योग्य rows वर उडी मारतो.
Runner 42 चे laps: index नसताना सगळ्या 10,000 rows चा SCAN; runner_id वरचा index 20 वर उडी घेतो; (runner_id, lap_ms) covering आहे.
Covering index table कधीच वाचत नाही. पण lower(name) किंवा LIKE '%042' index लपवतो आणि परत SCAN runners होतो.
पुढचा धडा पालकांच्या phone वर results page उघडतो: LCP, INP, CLS, compression आणि caching headers.
11 📱 Web performance
पालकांच्या फोनवरचे निकालाचे page: LCP, INP, CLS, payload, compression आणि caching headers.
कतरिनाची आई parking मध्ये phone वर results page उघडते. Page जड आहे, आणि मोठ्या photo साठी तिला 5 seconds थांबावे लागते. ती एक button दाबते, आणि क्षणभर काहीच होत नाही. मग photo आल्यावर मजकूर खाली उडी मारतो. ऐश्वर्या files लहान करते, script ला थांबायला सांगते, लहान photo वापरते आणि त्याची जागा राखून ठेवते. आता page सुमारे 1 second मध्ये दिसते.
Pages office च्या जलद Wi-Fi वर तपासले जात, आणि कमकुवत phone signal वर पालकांना होणारा 5 second चा उशीर कोणी पाहिला नाही.
p75 वर Core Web Vitals: LCP (मुख्य content दिसणे) ≤ 2.5 s, INP (tap ला उत्तर) ≤ 200 ms, CLS (layout उड्या) ≤ 0.1.
जसे बनवले तसे LCP 5020 ms आणि 2210 KB. Text compress: 3505 ms. Script defer: 3055 ms. 200 KB चा AVIF hero: 1055 ms.
Width आणि height दिल्याने CLS 0.1875 वरून 0.0; 50 ms chunks ने INP 316 वरून 66 ms; पुन्हा भेट 450 ms घेते.
शेवटचा धडा गर्दीसह सराव करतो: load test knee शोधतो, आणि CI मधले budgets प्रत्येक उपाय जागी ठेवतात.
12 🏆 Load tests, budgets आणि संपूर्ण चित्र
गर्दीसोबतची रंगीत तालीम, आणि CI मधील पात्रता वेळा — load tests, budgets आणि संपूर्ण नकाशा.
क्रीडा दिवसाआधी शाळा सराव घेते आणि पाण्याच्या टेबलाकडे अधिकाधिक धावपटू पाठवते. दर second 50 ला सगळे ठीक. 90 ला रांग लांब होते. 110 ला ती वाढतच जाते. मग दीपिका भिंतीवर पात्रता वेळा लिहिते: जास्तीत जास्त 5 फेऱ्या, 2.5 seconds पेक्षा कमी, जास्तीत जास्त 500 KB. प्रत्येक बदलावर एक मदतनीस त्या तपासते.
मोठ्या launch आधी performance हाताने तपासला जाई, मग एकेका लहान बदलाने हळूहळू हरवत असे.
Load test वाढते traffic पाठवून knee शोधतो; performance budget म्हणजे CI job प्रत्येक बदलावर तपासणारी मर्यादा.
एक 10 ms server: p95 50 req/s ला 60 ms, 70 ला 109, 90 ला 280, आणि क्षमतेपेक्षा जास्त 110 ला 3122 ms.
उपायांआधी 51 queries, LCP 5020 ms, 2210 KB आणि p95 109 ms budget मध्ये fail; नंतर 1, 1055, 452.5 आणि 23 pass.
पुढे कुठे: Scaling school machines वाढवते, आणि Observability school हे सगळे production मध्ये मोजते.