🛠️ शाळेच्या पद्धतीने Site Reliability Engineering शिका
production विश्वासार्ह ठेवणे हे एक engineering काम आहे, आणि ते शाळेच्या देखभाल पथकाच्या रूपात शिकवले आहे: कतरिना, दीपिका आणि ऐश्वर्या जास्त बादल्या वाहून नव्हे, तर tools लिहून इमारती चालू ठेवतात. प्रत्येक धडा ही एक शाळेची गोष्ट आहे, सोबत काढलेली आकृती आणि एक lab — आणि हे पथक repo मध्येच आहे: शुद्ध Python मधील deterministic models (sre/crew.py, sre/design.py, एकही dependency नाही), ज्यांना तुम्ही overload करू शकता, page करू शकता आणि मोडू शकता.
🪣 भाग 1 — काम (1–4)
- पन्हाळ दुरुस्त करा 🛠️
- सही केलेले दुरुस्ती budget 📜
- बादल्या मोजा 🪣
- ड्युटीचा फोन 📟
🎚️ भाग 2 — सुरक्षितपणे बदल करणे (5–8)
- आधी एकच वर्ग 🐤
- वर्गामागून वर्ग, एका switch सह 🎚️
- पुढच्या सत्रासाठी खुर्च्या 📈
- जबाबदारी कोणाची 🦺
🧯 भाग 3 — अपयशासाठी रचना (9–12)
- एका रांगेतील दारे 🔢
- आधी परीक्षेचे विद्यार्थी 🚦
- ठरवून केलेली वीजकपात 🧯
- checklist ✅
# the 60-second wow — one crew, twelve buildings:
git clone https://github.com/BaluRaut/learn-sre-school.git && cd learn-sre-school
python3 sre/demo.py               # 12 lessons: budgets, canaries, capacity, chaos
python3 sre/test_sre.py           # 12 checks across the lessons
तुम्हाला काय दिसायला हवे (छाटलेले — यश असे दिसते):
═══ job ═══
── the crew: Katrina, Dipika, Aishwarya · 3 × 40 h = 120 h a week · ops work (tickets, pages, manual fixes) per week:
   week 1:  48 h ops = 40.0%
   week 2:  54 h ops = 45.0%
   week 3:  63 h ops = 52.5%  ← over the 50% cap: extra tickets and pages go back to the dev team
   week 4:  71 h ops = 59.2%  ← over the 50% cap: extra tickets and pages go back to the dev team
   week 5:  58 h ops = 48.3%
   week 6:  45 h ops = 37.5%
   six-week average 47.1% · the rest of the week is ENGINEERING: tools that make next week's ops smaller
   ops team: carry more buckets as the school grows · SRE: fix the gutter, so the buckets are not needed
   DevOps is the culture (share ownership, automate, measure); SRE is one concrete way to practise it

═══ budget ═══
── timetable service · SLO 99.9% over a rolling 28 days · 1,000,000 requests a day → budget 28,000 failed requests
   example policy, signed in advance: < 75% used → normal · 75–100% → caution · ≥ 100% → freeze (P0 + security fixes only)
   day  1:   0.9% of the budget used → normal
   day 20:  83.9% of the budget used → caution
   day 24: 101.8% of the budget used → freeze
   day 34:  80.4% of the budget used → caution
   day 43:  57.1% of the budget used → normal
   day  6 incident burned 7,000 = 25.0% (> 20%) → its postmortem must carry a P0 action item
   day 15 incident burned 6,500 = 23.2% (> 20%) → its postmortem must carry a P0 action item
   the budget refills only as old failures leave the 28-day window — the freeze is lifted by time plus fixes, not by argument

═══ toil ═══
── the toil ledger: toil 24.2 h/week · overhead 3.0 h · engineering 8.0 h
   copy grades to the backup drive   5.00 h/week · build  6 h · upkeep 0.10 h/week → pays back in    1.2 weeks
   reset locked pupil accounts      10.00 h/week · build 16 h · upkeep 0.25 h/week → pays back in    1.6 weeks
   grow a full disk by hand          3.00 h/week · build  8 h · upkeep 0.10 h/week → pays back in    2.8 weeks
   restart the stuck print queue     6.00 h/week · build 20 h · upkeep 0.25 h/week → pays back in    3.5 weeks
   renew a TLS certificate by hand   0.19 h/week · build 12 h · upkeep 0.10 h/week → pays back in  137.1 weeks
   40 h of automation this quarter, best payback first: copy grades to the backup drive, reset locked pupil accounts, grow a full disk by hand (30 h)
   toil falls from 24.2 to 6.2 h/week, plus 0.45 h/week of upkeep for the new tools
   the print queue (20 h) waits for next quarter — better still, find out why it sticks and fix that
   the certificate never pays back by the ledger; renew it with ACME anyway, because an expired one is an outage

═══ oncall ═══
── 4 weeks of pages for the timetable service: 55 pages · 0.98 per 12-hour shift on average
   busiest shift 3 pages · shifts with more than 2 pages: 4 of 56
   one Pune crew, 24 h on call: 17 pages between 22:00 and 07:00
   follow-the-sun: Pune takes 07:00–19:00, a sister crew 12 h away takes the rest in its own daytime → night pages 0 + 0
   weekly rotation of 3: each person is on call 33.3% of weeks  ← over 25%: no time left for engineering
   weekly rotation of 5: each person is on call 20.0% of weeks
   weekly rotation of 8: each person is on call 12.5% of weeks
   the Google SRE book's numbers: at most 2 incidents per 12-hour shift, at most 25% of time on call, 8 people for one site

═══ canary ═══
── the baseline: the OLD version on a fresh copy, same size and traffic slice as the canary · 11 errors / 10,000 · p99 180 ms
   canary A: 13 errors / 10,000 · p99 185 ms → z   0.41 · p99 ×1.03 → PROMOTE
   canary B: 42 errors / 10,000 · p99 182 ms → z   4.26 · p99 ×1.01 → ROLLBACK
   canary C: 12 errors / 10,000 · p99 260 ms → z   0.21 · p99 ×1.44 → ROLLBACK
   canary D:  3 errors /    400 · p99 179 ms → z    n/a · p99 ×0.99 → EXTEND  (first minutes: baseline 1 / 400)
   rules: ROLLBACK if z > 3.0 (error rate clearly worse) or p99 > 1.2 × baseline · EXTEND under 1,000 requests each
   compare with a fresh baseline, not the whole old fleet: long-running machines differ (warm caches, leaks, old hosts)

═══ rollout ═══
── 1,000 requests/min · a bad change fails 30% of the requests it serves · noticed after 30 failures (at least 5 min)
   big bang, rollback = redeploy (15 min)     300 bad/min · noticed after  5 min → 6,000 failed requests
   big bang, flag off (1 min)                 300 bad/min · noticed after  5 min → 1,800 failed requests
   canary at 1%, rollback = redeploy            3 bad/min · noticed after 10 min →    75 failed requests
   canary at 1%, flag off                       3 bad/min · noticed after 10 min →    33 failed requests
   stages 1% → 5% → 25% → 100%, 30 min each: a full rollout takes 2 hours instead of 1 minute — that is the price
   exposure is the biggest lever, rollback speed the next; a flag only helps if the old path still works and the flag is removed later

═══ capacity ═══
── weekly peak requests/s, 12 weeks: [1206, 1226, 1276, 1373, 1365, 1448, 1474, 1533, 1600, 1613, 1684, 1707]
   straight-line fit: +47.8 req/s per week · forecast 26 weeks ahead: 2,963 req/s
   one server: 300 req/s at its load-test limit; plan at 70% = 210 → N = 15 servers for the forecast peak
   N+1 = 16 (one server can fail) · N+2 = 17 (one in maintenance AND one fails) · survive losing 1 of 3 zones: 24
   results day (2.5 × the normal peak = 7,408 req/s) needs 36 — plan it as an event, pre-scale, don't wait for autoscaling

═══ command ═══
── without roles: the timetable service is down at 23:00 · resolved after 110 min · 5 problem(s)
   ✗ 00:00 Katrina went off shift still holding ops — nobody holds it now
   ✗ no IC was ever named
   ✗ no comms was ever named
   ✗ no scribe was ever named
   ✗ 23:00 no status update for 110 min (rhythm: every 30)
── with incident command: the timetable service is down at 23:00 · resolved after 100 min · 0 problem(s)
   ✓ Dipika is IC (and scribe while it is small), Katrina fixes, Aishwarya talks; at 00:00 Dipika hands IC to crew-5 — acknowledged
   the detection clocks, the metrics and the postmortem are the Observability school's lessons 10–12

═══ nines ═══
── a request needs all three: gateway 99.99% × timetable app 99.95% × database 99.90% = 99.840%
   the chain is worse than its weakest part: 14.0 h a year of downtime allowed by the math
   two independent database copies: 1 − (1 − 0.999)² = 99.9999% → chain 99.940%
        99% →   87.60 h a year ·  403.2 min in 28 days
      99.9% →    8.76 h a year ·   40.3 min in 28 days
     99.95% →    4.38 h a year ·   20.2 min in 28 days
     99.99% →    0.88 h a year ·    4.0 min in 28 days
    99.999% →    0.09 h a year ·    0.4 min in 28 days
   each extra nine is 10 × less downtime: at 99.99% a 28-day window allows 4.0 min — about the time a paged person needs
   to wake up and log in, so at that level the fix must be automatic (failover, rollback), not a human

═══ overload ═══
── capacity 1,000 req/s · offered: critical 400 (log in, see timetable) + normal 500 + sheddable 600 (recommendations, prefetch)
   no priorities (everyone gets 1000/1500): {'critical': 267, 'normal': 333, 'sheddable': 400}
   shed by priority:                        {'critical': 400, 'normal': 500, 'sheddable': 100}
   + graceful degradation (normal and sheddable skip photo thumbnails: cost 0.7 each): {'critical': 400, 'normal': 500, 'sheddable': 357}
   3 retries per request           → 3,000 attempts/s arrive at a server that can do 1,000
   3 retries + a 10% retry budget  → 1,650 attempts/s arrive at a server that can do 1,000
   retries turn 1.5× overload into 3×; a retry budget caps the extra at 10% (bounded queues: Distributed Systems school, lesson 12)

═══ chaos ═══
── hypothesis: if zone B is lost, the cell's success rate stays ≥ 99.5% · abort if any minute < 99.0% · blast radius: 1 cell = 10% of users
   6 replicas in 3 zones: minutes 0–9 success 100% 100% 100% 100% 100% 100% 100% 100% 100% 100%
      → hypothesis held · no abort · 0 failed
   4 replicas in 2 zones: minutes 0–9 success 100% 100% 100% 57% 100% 100% 100% 100% 100% 100%
      → hypothesis refuted · ABORTED at minute 3, fault undone · 18,000 requests failed in the cell
   the same fault on all 10 cells at once would have failed 10 × as many — start small, widen only after a pass

═══ prr ═══
── production readiness review: the timetable service asks the crew to carry its pager
   ✅ L02  SLO agreed + error-budget policy signed
   ✅ L01  ops work under the 50% cap, toil ledger kept
   ✅ L04  on-call: 8+ people or two sites, a runbook per page
   ✅ L05  automated canary analysis gates every release
   ❌ L06  rollback in 5 minutes or less; risky features behind flags  [blocker]
   ✅ L07  capacity: 2-quarter forecast, survives a zone loss
   ✅ L08  incident roles trained, handoff template ready
   ❌ L09  dependency chain meets the SLO  [blocker]
   ✅ L10  load shedding by priority + a client retry budget
   ❌ L11  a game day in the last 90 days, abort conditions written
   ✅ obs  dashboards + burn-rate alerts (Observability school)
   ✅ ops  a backup restored in a test in the last 90 days
   → NOT READY — 2 blocker(s), 1 other item(s) to fix
   after fixes (flag-off rollback 1 min, two database copies, a game day): → READY — the crew takes the pager
── the whole picture: cap ops work → agree the budget → kill toil → sane on-call → judge canaries → roll out in stages
   → plan capacity → command incidents → do the availability math → shed load → test with chaos → review before launch

✅ done — the crew fixed the gutter🗺️ संपूर्ण चित्र — एक आकृती, पूर्ण कोर्स
संपूर्ण कोर्स एका कॅनव्हासवर. 4K आवृत्तीसाठी क्लिक करा.
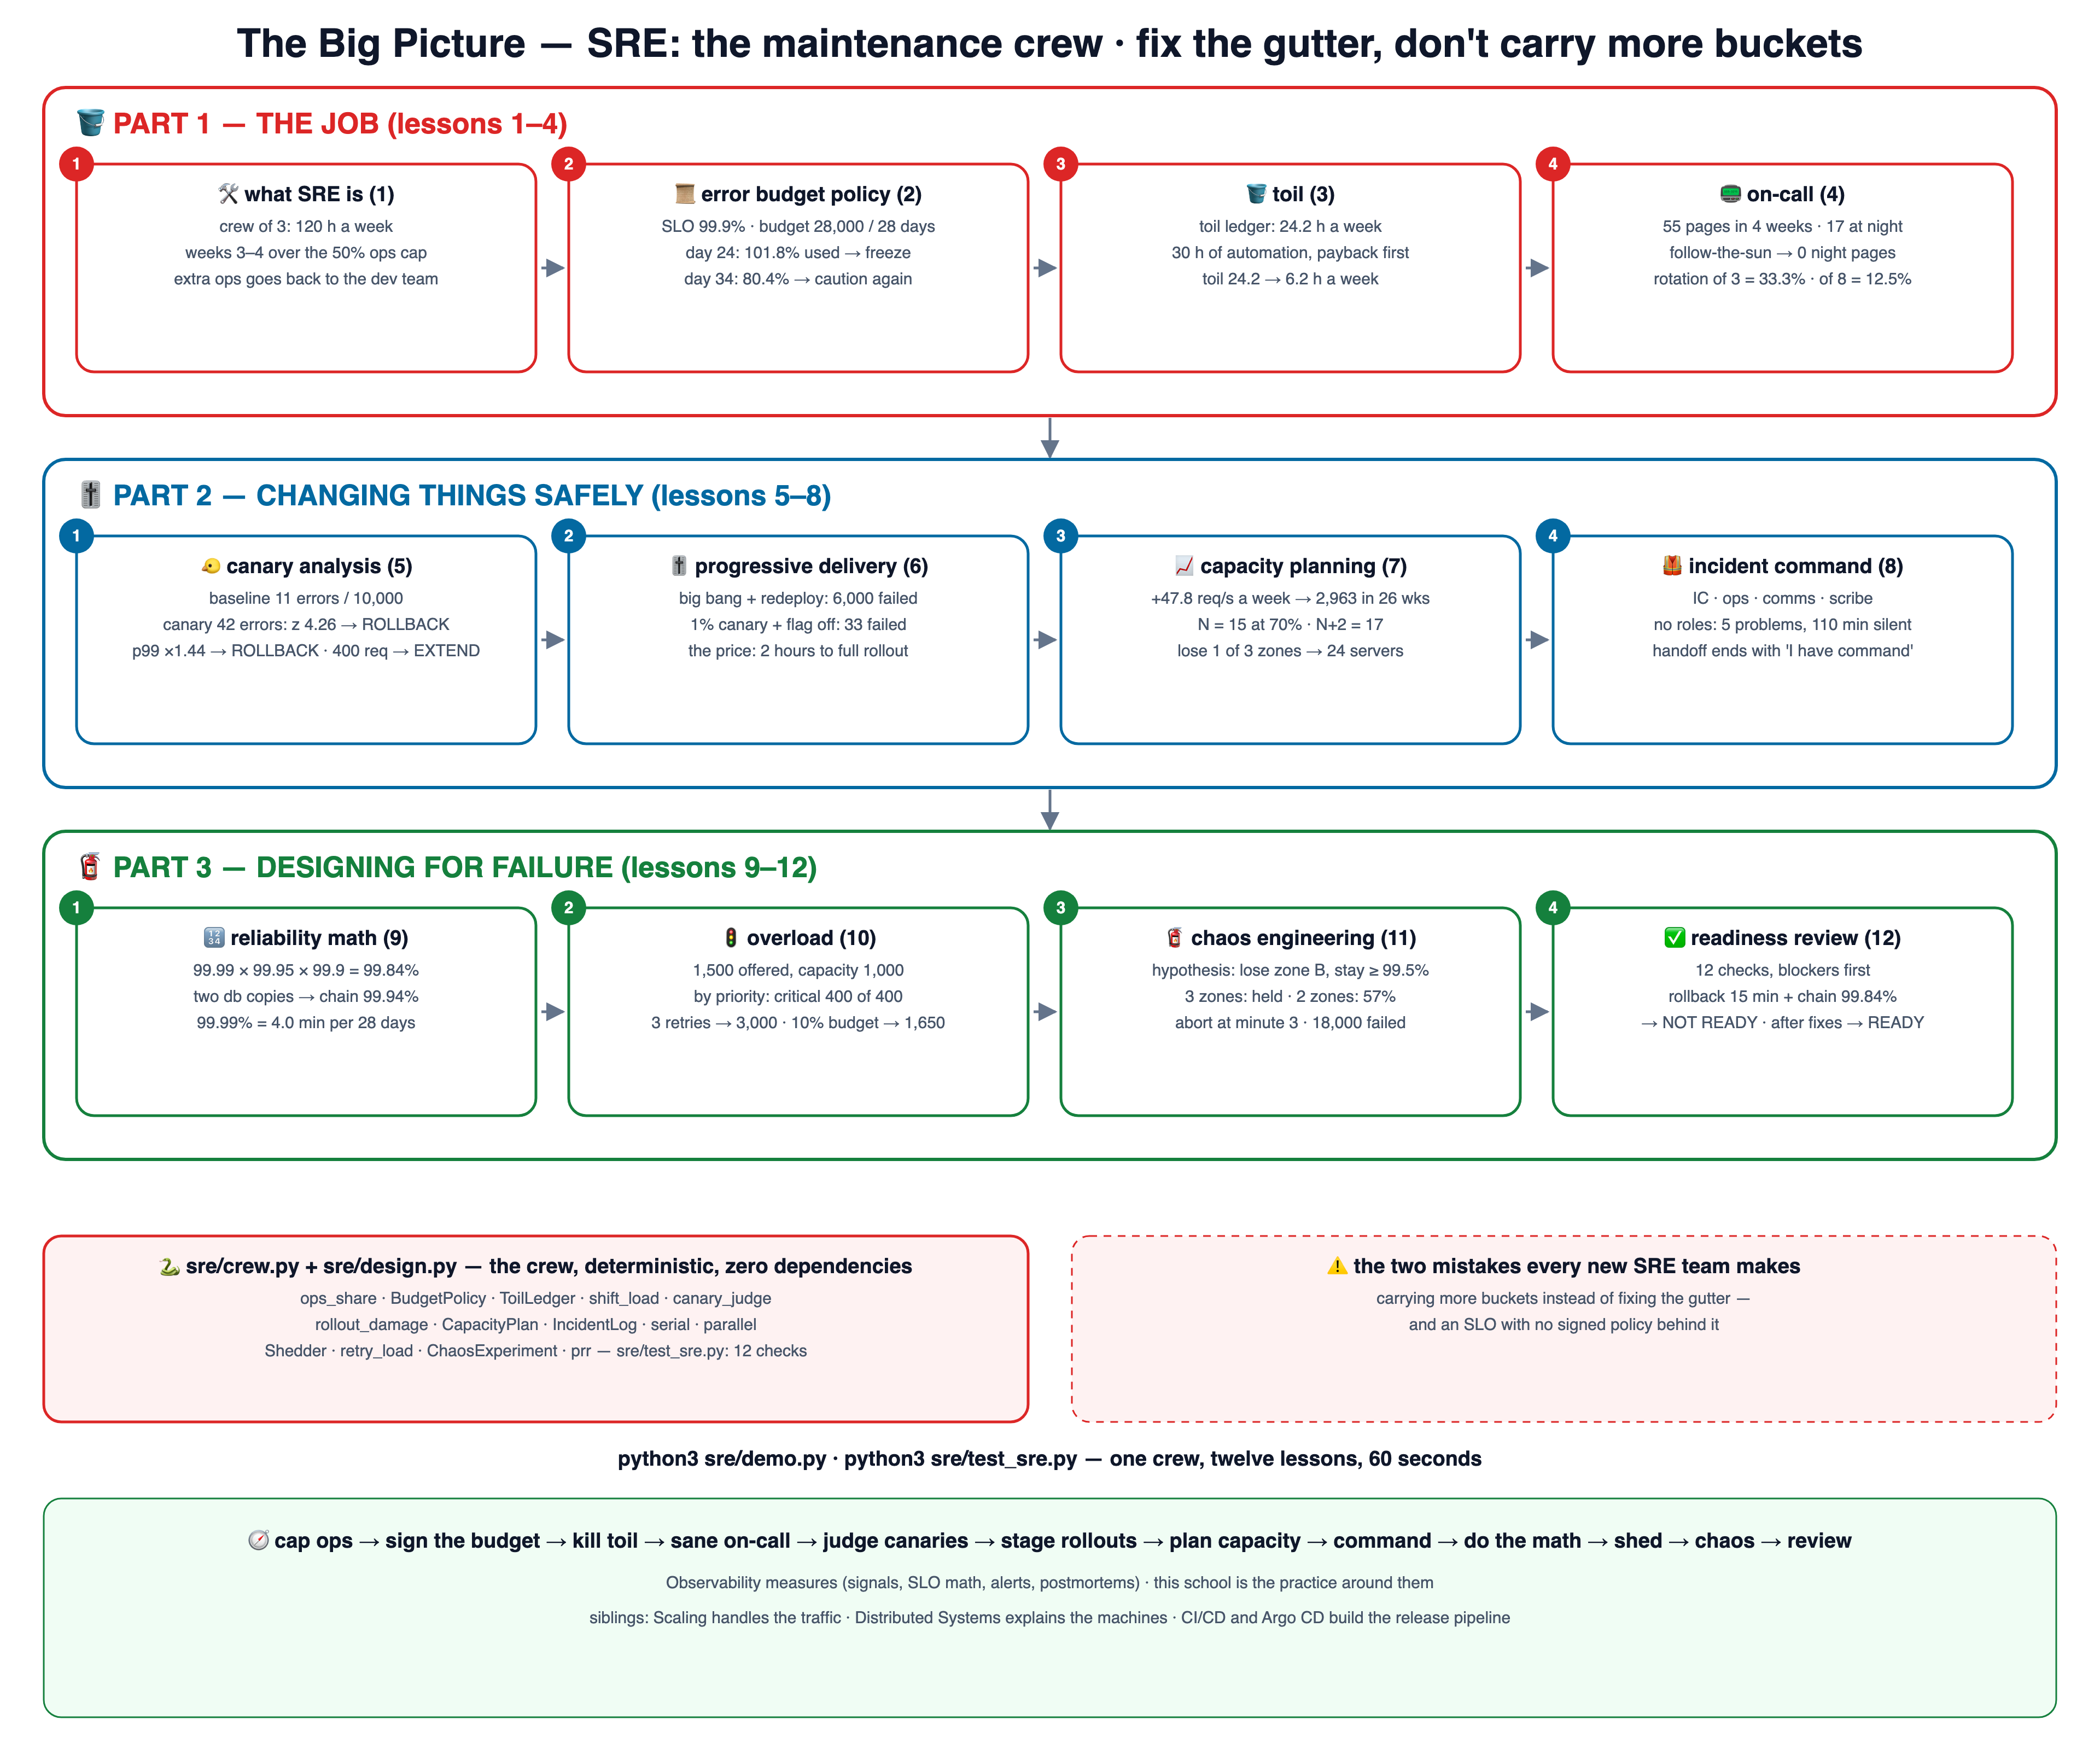
🪣 भाग 1 — काम (धडे 1–4)
एक git branch = एक कल्पना; branch 04 मध्ये धडे 01–04 आहेत. sre/ प्रत्येक वेळी चालवल्यावर तेच निकाल येतात — randomness ला seed दिलेला आहे.
🛠️ SRE म्हणजे काय
lesson-01-what-is-sreधडा वाचा →आकृती पहा ↗📜 error budget धोरण
lesson-02-error-budget-policyधडा वाचा →आकृती पहा ↗🪣 Toil
lesson-03-toilधडा वाचा →आकृती पहा ↗📟 On-call
lesson-04-on-callधडा वाचा →आकृती पहा ↗🎚️ भाग 2 — सुरक्षितपणे बदल करणे (धडे 5–8)
बहुतेक outages एखाद्या बदलापासून सुरू होतात: तो छोट्या भागावर तपासा, तो कोणाला दिसतो ते मर्यादित ठेवा, capacity चे नियोजन करा, आणि काही बिघडले तर incident चे नेतृत्व करा.
🐤 Canary विश्लेषण
lesson-05-canary-analysisधडा वाचा →आकृती पहा ↗🎚️ Progressive delivery आणि flags
lesson-06-progressive-deliveryधडा वाचा →आकृती पहा ↗📈 Capacity नियोजन
lesson-07-capacity-planningधडा वाचा →आकृती पहा ↗🦺 Incident command
lesson-08-incident-commandधडा वाचा →आकृती पहा ↗🧯 भाग 3 — अपयश गृहीत धरून design (धडे 9–12)
वचन देण्याआधी हिशोब करा, overload मध्ये नीट अपयशी व्हा, chaos ने दाव्यांची तपासणी करा, आणि पथक pager हाती घेण्याआधी आढावा घ्या.
🔢 Reliability चे गणित
lesson-09-reliability-mathधडा वाचा →आकृती पहा ↗🚦 Overload
lesson-10-overloadधडा वाचा →आकृती पहा ↗🧯 Chaos engineering
lesson-11-chaos-engineeringधडा वाचा →आकृती पहा ↗✅ Production readiness आणि संपूर्ण चित्र
lesson-12-production-readinessधडा वाचा →आकृती पहा ↗📐 धड्यांच्या आकृत्या — क्रमांक अनुसरा
प्रत्येक धडा एका क्रमांकित बॉक्स-आणि-बाण आकृतीत — स्वतंत्र पानावरही.
1 🛠️ SRE म्हणजे काय
पन्हाळ दुरुस्त करा, जास्त बादल्या वाहू नका — SRE, ops आणि DevOps यांतील फरक, आणि ops कामावरची 50% मर्यादा.
पाऊस पडला की timetable इमारतीचे छप्पर गळते. साधे दुरुस्ती पथक प्रत्येक गळतीखाली बादली ठेवते, आणि पुढच्या आठवड्यात आणखी बादल्या वाहते. कतरिना, दीपिका आणि ऐश्वर्या आजची बादलीही वाहतात, पण मग त्या पन्हाळ दुरुस्त करतात. त्यांचा एक नियम आहे: आठवड्याचा जास्तीत जास्त अर्धा वेळ बादल्यांसाठी. आठवडा 4 मध्ये बादल्यांनी 120 पैकी 71 तास घेतले, म्हणून जास्तीचे काम इमारत बांधणाऱ्यांकडे परत गेले.
साधी ops team शाळा वाढेल तशा जास्त बादल्या वाहत असे, आणि फक्त त्या वाहण्यासाठी जास्त लोक भरती करत असे.
SRE म्हणजे देखभाल पथक: कतरिना, दीपिका आणि ऐश्वर्या tools लिहून शाळेच्या इमारती चालू ठेवतात.
पथकाकडे आठवड्याला 3 × 40 h = 120 h असतात; आठवडा 4 मध्ये 71 h ops झाले, म्हणजे 59.2%, 60 h च्या 50% cap च्या वर.
Cap च्या वरचे ops काम dev team कडे परत जाते, म्हणून आठवड्याचा किमान अर्धा वेळ पुढचा आठवडा हलका करणाऱ्या engineering साठी राहतो.
पुढचा धडा SLO ला सही केलेला करार बनवतो: 28,000-request error budget संपत आला की शाळा काय करते.
2 📜 error budget धोरण
दुरुस्तीचे बजेट, गळती होण्याआधीच सही केलेले — error budget चे 75% आणि 100% वापरले गेल्यावर काय होते.
सत्राच्या सुरुवातीला पथक आणि मुख्याध्यापक एका करारावर सही करतात. Timetable थोडे अयशस्वी होऊ शकते: 1,000 पैकी 1 request. 28 दिवसांत ते 28,000 failed requests, म्हणजे दुरुस्ती budget. Budget शिल्लक असेपर्यंत शिक्षक मोकळेपणाने बदल करतात. 75% वापरला की त्या सावकाश होतात आणि आधी दुरुस्ती करतात. दिवस 24 ला budget संपतो, म्हणून बदल थांबतात. कोणी वाद घालत नाही, कारण कागदावर आधीच तसे लिहिले आहे.
Reliability विरुद्ध नवीन features यावर प्रत्येक बैठकीत वाद होत, आणि बहुतेक वेळा सर्वात मोठ्या आवाजाचा माणूस जिंकत असे.
Error budget policy: 28 दिवसांत 99.9% SLO, दिवसाला 1,000,000 requests, म्हणून 28,000 failed requests ची मुभा.
75% पेक्षा कमी वापर: normal. 75–100%: caution. 100% किंवा जास्त: freeze. दिवस 20 ला 83.9%, दिवस 24 ला 101.8%.
गळती सुरू होण्याआधीच त्यावर सही झाली होती, म्हणून दिवस 24 ला कोणी वाद घालत नाही: कागदावर आधीच freeze लिहिले आहे.
पुढचा धडा बादल्या मोजतो: toil ची नोंदवही, जी प्रत्येक हाताने केलेले काम automation किती लवकर वसूल होते त्यानुसार लावते.
3 🪣 Toil
बादल्या मोजा — toil म्हणजे काय, toil ची नोंदवही, आणि payback नुसार क्रम लावलेले automation.
दीपिका हाताने केलेल्या प्रत्येक कंटाळवाण्या कामाची वही ठेवते. Locked accounts reset करणे आठवड्याला 60 वेळा होते, प्रत्येकी 10 मिनिटे: 10 तास. कतरिना सांगते की reset button बनवायला 16 तास लागतील, म्हणून ते दोन आठवड्यांपेक्षा कमी काळात वसूल होते. पथकाकडे या सत्रात 40 तास आहेत, आणि ते सर्वात लवकर फायदा देणारी कामे आधी बनवते. कंटाळवाणे काम आठवड्याला 24.2 वरून 6.2 तासांवर येते.
पथक हाताने accounts reset करत, queues restart करत आणि disks वाढवत असे, पण त्याला किती वेळ लागतो हे कधीच नोंदवले नाही.
Toil म्हणजे हाताने, पुन्हा पुन्हा केले जाणारे, automate करता येणारे आणि टिकाऊ मूल्य नसलेले काम: दीपिकाच्या नोंदवहीत आठवड्याला 24.2 h.
Payback = build ÷ (वाचलेले तास − upkeep). Account reset: 16 h ÷ आठवड्याला 9.75 h = 1.6 आठवडे. सर्वात चांगले आधी.
40 h च्या automation मधून 30 h मध्ये तीन tools बनतात, आणि toil आठवड्याला 24.2 वरून 6.2 h वर येते, अधिक 0.45 h upkeep.
पुढचा धडा duty phone सोपवतो: एका shift मध्ये किती pages जास्त आहेत, आणि rotation किती मोठे हवे.
4 📟 On-call
ड्युटीचा फोन — प्रत्येक shift मधील pages, रात्रीचे pages, rotation चा आकार आणि follow-the-sun.
पथकाकडे एक duty phone आहे, जो इमारत बिघडली की वाजतो. चार आठवड्यांत तो 55 वेळा वाजला, आणि त्यापैकी 17 वेळा रात्री. फक्त तिघी असल्याने प्रत्येकीकडे तीनपैकी एक आठवडा phone असतो, हे फारच वारंवार आहे. म्हणून आणखी लोक सामील होतात, आणि आठ जणांत प्रत्येकाकडे आठपैकी एक आठवडा. जगाच्या दुसऱ्या बाजूचे sister crew रात्र सांभाळते. आता कोणाचाही phone रात्री वाजत नाही.
एकच व्यक्ती सतत pager सांभाळत असे, रात्रीचा प्रत्येक call उचलत असे, आणि थकून शेवटी ती सोडून गेली.
On-call: 4 आठवड्यांत 55 pages आले, 12 तासांच्या shift ला 0.98; 56 पैकी 4 shifts मध्ये पुस्तकातील 2 च्या मर्यादेपेक्षा जास्त.
Follow-the-sun: पुणे 07:00–19:00 घेते आणि 12 h दूरचे sister crew उरलेले घेते, म्हणून 17 रात्रीचे pages 0 होतात.
3 जणांच्या rotation मध्ये प्रत्येकजण 33.3% आठवडे on call असते, 25% च्या वर; 8 जणांत ते 12.5%, म्हणून बांधायला वेळ उरतो.
पुढचा धडा बदल सुरक्षितपणे करतो: एका वर्गाला आधी नवा boiler मिळतो, आणि judge आकड्यांनी त्याची तुलना करतो.
5 🐤 Canary विश्लेषण
नवा boiler आधी एकाच वर्गात बसवला जातो — canary विरुद्ध ताजी baseline, आकड्यांवरून निर्णय.
पथकाला प्रत्येक वर्गात नवा boiler बसवायचा आहे, पण तो वाईट निघाला तर? त्या आधी एकाच वर्गात तो बसवतात. शेजारच्या वर्गात त्या एक ताजा जुना boiler बसवतात, तेवढाच मोठा वर्ग आणि तेवढेच विद्यार्थी. एका दिवसानंतर ऐश्वर्या तक्रारी मोजते: जुना 11, नवा 42. हा वाईट boiler आहे, म्हणून तो काढला जातो. दुसऱ्या वेळी 11 विरुद्ध 13 येते, हा सामान्य चढउतार, म्हणून नवा boiler सगळीकडे जातो.
नवी version एकदम सगळ्या servers वर जात असे, आणि लोक graph कडे बघून ठीक दिसते असे म्हणून निर्णय घेत.
Canary analysis: नवी version एका छोट्या भागावर, आणि त्याच आकाराच्या जुन्या version च्या ताज्या copy शी तुलना.
Baseline ला 10,000 मध्ये 11 errors. Canary B ला 42: z 4.26 > 3.0, ROLLBACK. Canary C चा p99 ×1.44 > ×1.2: ROLLBACK.
Canary A चे 11 विरुद्ध 13 हे सामान्य चढउतार आहे (z 0.41), म्हणून ती promote होते; D कडे फक्त 400 requests, म्हणून judge थांबतो.
पुढचा धडा वाईट बदल निसटला तर होणारे नुकसान मर्यादित करतो: टप्प्याटप्प्याने rollout, आणि परत जाण्यासाठी एक switch.
6 🎚️ Progressive delivery आणि flags
एकेक खोली, हातात switch ठेवून — exposure, detection आणि rollback चा वेग; feature flags.
पथक दिवे बदलते, आणि नव्या दिव्यांत दोष आहे: 10 पैकी 3 bulbs बंद पडतात. सगळ्या खोल्या एकदम बदलल्या आणि परत आणायला 15 मिनिटे लागली तर 6,000 requests अयशस्वी होतात. जुन्या दिव्याकडे परत नेणारा switch असेल तर 1,800. आधी शंभरातील फक्त एक खोली बदलली तर 75. शंभरातील एक खोली आणि switch: फक्त 33. काळजीपूर्वक पद्धतीला प्रत्येक खोलीपर्यंत पोहोचायला 2 तास लागतात.
सगळ्यांना नवी version एकदम मिळत असे, आणि rollback म्हणजे नवा build आणि 15 मिनिटांचे redeploy.
Progressive delivery: बदल 1% → 5% → 25% → 100% पर्यंत पोहोचतो, प्रत्येकी 30 min; feature flag तो बंद करतो.
मिनिटाला 1,000 requests पैकी 30% अयशस्वी करणारा बदल: big bang + redeploy मध्ये 6,000; 1% canary + flag मध्ये 33.
Exposure हा सर्वात मोठा lever आहे, त्यानंतर rollback चा वेग; किंमत अशी की पूर्ण rollout ला 1 मिनिटाऐवजी 2 तास लागतात.
पुढचा धडा पुढच्या सत्राच्या खुर्च्यांचा आराखडा करतो: peak चा अंदाज, headroom, आणि संपूर्ण zone गेला तरी टिकणे.
7 📈 Capacity planning (क्षमतेचे नियोजन)
पुढच्या सत्रासाठी खुर्च्या — forecast, headroom, N+1, N+2 आणि संपूर्ण zone गमावणे.
दर आठवड्याला ऐश्वर्या सभागृहातील सर्वात गर्दीचा क्षण मोजते: आठवडा 1 मध्ये 1,206 आणि आठवडा 12 मध्ये 1,707. ती एक सरळ रेषा काढते आणि सहा महिने पुढे नेते: सुमारे 2,963. खुर्च्यांची एक रांग 300 जणांसाठी असते, पण कोणी दाटीवाटीत बसू नये म्हणून ती 210 चा आराखडा करते, म्हणून 15 रांगा. एक जास्तीची रांग म्हणजे 16, दोन म्हणजे 17. संपूर्ण wing बंद झाली तर तिला 24 लागतात. निकालाच्या दिवशी 36 लागतात, त्या आधीच उसन्या आणल्या जातात.
Site आधीच हळू झाल्यावर servers जोडले जात, आणि दरवर्षी निकालाचा दिवस शाळेला अचानक गाठत असे.
Capacity planning: 12 आठवड्यांचे peaks 1,206 ते 1,707 req/s, आठवड्याला +47.8 वाढतात, म्हणून 26 आठवड्यांनी 2,963.
एक server 300 req/s हाताळतो; 70% = 210 नुसार आराखडा, म्हणून N = 15. N+1 = 16, N+2 = 17, 3 पैकी 1 zone गेला तर 24.
Headroom अचानक वाढ शोषून घेते; 2.5 × = 7,408 req/s च्या निकालाच्या दिवशी 36 servers लागतात, म्हणून आधीच वाढवा.
पुढचा धडा तरीही बिघडल्याच्या रात्रीचा आहे: incident commander, fixer, बोलणारी व्यक्ती, scribe आणि स्वच्छ handoff.
8 🦺 Incident command
एक commander, एक दुरुस्ती करणारी, एक आवाज आणि एक लेखनिक — भूमिका, update ची लय आणि handoff.
रात्री 23:00 ला timetable इमारत अंधारात जाते. पहिल्या रात्री कतरिना आणि दीपिका दोघीही दुरुस्ती सुरू करतात आणि एकमेकींचे काम उलटवतात. जवळजवळ दोन तास मुख्याध्यापकांना कोणीच काही सांगत नाही. दुसऱ्या रात्री दीपिका सांगते की ती incident commander आहे: ती नेतृत्व करते, दुरुस्ती करत नाही. कतरिना दुरुस्ती करते आणि ऐश्वर्या दर अर्ध्या तासाने काय चालले आहे ते सांगते. मध्यरात्री दीपिका काम सोपवते, आणि crew-5 म्हणते 'I have command.'
सगळे एकदम दुरुस्तीला धावत: दोघी एकमेकींचे काम उलटवत, आणि मुख्याध्यापकांना कोणीच काही सांगत नसे.
Incident command: ठरलेल्या भूमिका. दीपिका IC आणि scribe आहे, कतरिना दुरुस्ती करते, ऐश्वर्या दर 30 मिनिटांनी comms करते.
00:00 ला दीपिका IC crew-5 कडे सोपवते, आणि ती जाण्याआधी crew-5 'I have command' म्हणते; रात्र 100 मिनिटांत संपते.
भूमिका नसताना त्याच बिघाडाला 110 मिनिटे लागली आणि 5 अडचणी आल्या, त्यात 110 मिनिटे एकही status update नव्हता.
पुढचा धडा आधी गणित करतो: रांगेतील दारे गुणाकाराने कमी होतात, आणि copies स्वतंत्र असतील तरच nines वाढवतात.
9 🔢 Reliability चे गणित
ओळीतील दारे गुणाकाराने कमी करतात, प्रती nines वाढवतात — आणि प्रत्येक nine ची किंमत किती.
Timetable पर्यंत पोहोचायला एक विद्यार्थिनी रांगेतील तीन दारांतून जाते. फाटक 99.99% वेळा चालते, सभागृहाचे दार 99.95% आणि office चे दार 99.9%. कोणतेही दार अडकले तर ती आत जाऊ शकत नाही, म्हणून आकडे गुणले जातात: 99.84%. हे सर्वात वाईट दारापेक्षाही वाईट आहे. मग पथक पहिल्या दाराशेजारी office चे दुसरे दार बांधते, आणि संपूर्ण प्रवास 99.94% होतो.
एका team ने 99.9% चे वचन दिले, पण request तीन भागांतून जात होती, आणि त्यांचे आकडे कधीच गुणले नाहीत.
Serial availability: gateway 99.99% × app 99.95% × database 99.9% = 99.840%, सर्वात कमकुवत भागापेक्षाही वाईट.
दोन स्वतंत्र database copies मुळे 1 − (1 − 0.999)² = 99.9999% मिळते, आणि संपूर्ण chain 99.940% पर्यंत जाते.
99.840% chain वर्षाला 14.0 h बंद राहू देते; 99.99% वर 28 दिवसांत फक्त 4.0 min, म्हणून दुरुस्ती automatic हवी.
पुढचा धडा overload मध्ये नीट अपयशी व्हायला शिकवतो: critical काम आधी, बाकीचे degrade, आणि प्रत्येक retry ला मर्यादा.
10 🚦 Overload
परीक्षेच्या विद्यार्थिनींना आधी जेवण द्या — प्राधान्यानुसार load shedding, graceful degradation, retry budgets.
Canteen सेकंदाला 1,000 थाळ्या देऊ शकते, पण 1,500 लोक येतात. काहीच नियोजन नसेल तर सगळे सारखे थांबतात, आणि तीनपैकी फक्त दोघांनाच जेवण मिळते, दहा मिनिटांत परीक्षा असलेल्या विद्यार्थ्यांनासुद्धा. नियोजन असेल तर परीक्षेचे विद्यार्थी आधी, मग नेहमीचे जेवण, मग दुसरे dessert. सजावट टाळल्याने थाळ्या लवकर होतात, म्हणून 357 desserts दिले जातात. परत पाठवलेले सगळे तीन वेळा पुन्हा घुसू शकत नाहीत.
प्रत्येक request एकाच रांगेत थांबत असे, म्हणून overload मध्ये recommendations इतकेच logins सुद्धा अयशस्वी होत.
Capacity 1,000 req/s, आलेले 1,500: critical 400, normal 500, sheddable 600. Load shedding priority नुसार सेवा देते.
Priority नसताना प्रत्येक वर्गाला 3 पैकी 2 (critical 267); priority नुसार 400, 500 आणि 100; degrade केल्यावर 357 sheddable.
प्रत्येक request वर 3 retries मुळे सेकंदाला 1,500 चे 3,000 प्रयत्न होतात; 10% retry budget ते 1,650 वर थांबवते.
पुढचा धडा दावे मुद्दाम तपासतो: एका cell मध्ये ठरवून केलेली वीज कपात, hypothesis आणि abort line सह.
11 🧯 Chaos engineering
नियोजित वीज खंडित — hypothesis, blast radius, abort च्या अटी आणि game days.
पथक म्हणते की पूर्वेकडील wing ची वीज गेली तरी बाकीच्या wings सगळे वर्ग चालवू शकतात. हे कोणीच कधी करून पाहिलेले नाही. म्हणून त्या वर्गांच्या एका block वर, म्हणजे एक दशांश विद्यार्थ्यांवर, test करतात, आणि कधी थांबायचे ते आधीच लिहून ठेवतात. पहिल्या block मध्ये तीन wings आहेत आणि प्रत्येक वर्ग चालू राहतो. दुसऱ्या block मध्ये फक्त दोन wings: जवळजवळ अर्धे वर्ग थांबतात, आणि कतरिना लगेच वीज परत सुरू करते.
खरे outage तपासेपर्यंत designs वर विश्वास ठेवला जात असे, पहाटे 3 वाजता, सगळ्या विद्यार्थ्यांवर एकाच वेळी.
Chaos engineering: hypothesis 'zone B गेला तरी success ≥ 99.5%', 99.0% खाली abort, blast radius 1 cell = 10%.
3 zones मधील 6 replicas 100% वर राहतात. 2 zones मधील 4 replicas 57% पर्यंत घसरतात, आणि test minute 3 ला abort होते.
अयशस्वी run मुळे एका cell मध्ये 18,000 requests गेल्या; सगळ्या 10 cells वर एकदम केले असते तर 10 × जास्त गेल्या असत्या.
पुढचा धडा पथक pager घेण्याआधीची checklist तपासतो, आणि सगळे बारा धडे एका नकाशावर मांडतो.
12 ✅ Production readiness आणि संपूर्ण चित्र
पथक pager हाती घेण्याआधीची checklist — आणि SRE पद्धतीचा संपूर्ण नकाशा.
नवे timetable office तयार आहे, आणि शिक्षकांना सोमवारी तिथे जायचे आहे. पथक त्याची देखभाल करायला तयार होण्याआधी कतरिना checklist घेऊन फिरते. बहुतेक चौकटी पूर्ण आहेत, पण दोन लाल आहेत: बदल परत घ्यायला 15 मिनिटे लागतात, आणि तीन दारे मिळून 99.84% होतात, वचन दिलेल्या 99.9% पेक्षा कमी. शिक्षक एक जलद switch, दुसरे दार आणि वीज कपातीचा सराव जोडतात. आता ते तयार आहे.
नवी service आधी launch होत असे, आणि पथकाची तिच्याशी पहिली भेट पहाटे 3 वाजता page आल्यावर होत असे.
Production readiness review: 12 checks, प्रत्येक धड्याचा एक, अधिक observability आणि backups, त्यापैकी 8 blockers.
कतरिनाला 15 मिनिटांचा rollback आणि 99.9% SLO खालील 99.840% chain सापडते: NOT READY, 2 blockers आणि 1 आणखी fix.
1 मिनिटाचा flag rollback, दोन database copies (99.940%) आणि game day नंतर ती READY होते, आणि पथक pager घेते.
पुढे: SLOs, burn-rate alerts आणि postmortems साठी Observability school, आणि traffic साठी Scaling school.