🌐 शाळेच्या पद्धतीने distributed systems शिका
अनेक machines वर पसरलेल्या systems कठीण का असतात, हे शाळेच्या शाखांच्या रूपात शिकवले आहे: पुणे, नाशिक, नागपूर आणि कोल्हापूर एकाच रजिस्टरच्या प्रती ठेवतात आणि निरोप्यामार्फत एकमत करतात — चिठ्ठ्या हरवतात, घड्याळे जुळत नाहीत, रस्ते तुटतात. प्रत्येक धडा ही एक शाळेची गोष्ट आहे, सोबत काढलेली आकृती आणि एक lab — आणि शाखा repo मध्येच आहेत: pure Python मधील deterministic simulations (dist/sim.py, शून्य dependencies), जे तुम्ही हळू करू शकता, तोडू शकता आणि बिघडवू शकता.
📨 भाग 1 — हे कठीण का आहे (1–4)
- निरोप्ये हरवतात 📨
- घड्याळे जुळत नाहीत 🕰️
- आधी, नंतर, की दोन्ही एकाच वेळी 🔀
- बंद पडली की फक्त हळू? 💓
📚 भाग 2 — प्रती (5–8)
- नोंदवहीच्या प्रती 📚
- पुरेशा प्रती एकमत करतात 🗳️
- वाचणाऱ्याला काय वचन दिले जाते 📏
- रस्ता तुटतो तेव्हा ✂️
👑 भाग 3 — एकमत (9–12)
- एक leader, एक log 👑
- संपणारी कुलुपे 🔏
- effectively once 🎯
- 'नंतर प्रयत्न करा' म्हणणे 🚧
# the 60-second wow — four branches, one register:
git clone https://github.com/BaluRaut/learn-distributed-systems-school.git && cd learn-distributed-systems-school
python3 dist/demo.py               # 12 lessons: lost notes, split roads, elections, fences
python3 dist/test_dist.py          # 12 checks across the lessons
तुम्हाला काय दिसायला हवे (छाटलेले — यश असे दिसते):
═══ failures ═══
── Pune sends 20 notes to Nashik by messenger (10% get lost, 5–50 ms each)
   arrived 18 of 20 · delays 5–48 ms · lost 2
   Pune sent 'is the exam at 10?' and heard nothing. Was the note lost? Is Nashik down? Is the answer lost? Just slow?
   from Pune these all look the SAME — that is partial failure, and it is the whole subject
   the fallacies: the network is reliable · latency is zero · bandwidth is infinite · the topology never changes

═══ clocks ═══
── wall clocks drift: Pune's clock reads 10:00:00.120, Nashik's reads 09:59:59.980 at the same instant
   Pune writes 'exam at 10' at 10:00:00.100 by its clock; Nashik then writes 'exam at 11' at 10:00:00.050 by its clock
   sorting by wall time says Pune's note was LAST — the later change is silently thrown away
── Lamport: Pune writes (L=1) → Nashik receives (L=2) → Nashik writes (L=3) — cause always has a smaller number
   Lamport numbers give an order everyone agrees on, but cannot say whether two events were independent

═══ ordering ═══
── vector clocks: e1 at Pune {'pune': 1, 'nashik': 0, 'nagpur': 0, 'kolhapur': 0}
   e2 at Nashik after reading e1 {'pune': 1, 'nashik': 1, 'nagpur': 0, 'kolhapur': 0}
   e3 at Nagpur, unaware of both {'pune': 0, 'nashik': 0, 'nagpur': 1, 'kolhapur': 0}
   e1 vs e2: before
   e2 vs e3: concurrent
   e1 vs e3: concurrent
   'concurrent' = nobody saw the other → a real conflict to resolve, not an order to pick

═══ detection ═══
── Kolhapur's heartbeats arrive with gaps (ms): [100, 110, 95, 340, 105, 120, 180, 95] — two slow moments (a GC pause, a busy network), then it really dies
   timeout 150 ms → false alarms while alive: 2 · the real death is noticed after 150 ms
   timeout 400 ms → false alarms while alive: 0 · the real death is noticed after 400 ms
   timeout 800 ms → false alarms while alive: 0 · the real death is noticed after 800 ms
   short timeout: fast but jumpy · long timeout: calm but slow · you cannot have both — tune, and make actions safe to repeat

═══ replication ═══
── asynchronous replication: 4 grades acknowledged, then Pune (leader) dies → new leader has ['g1', 'g2'], lost ['g3', 'g4']
── synchronous replication: 4 grades acknowledged, then Pune (leader) dies → new leader has ['g1', 'g2', 'g3', 'g4'], lost []
   async: fast writes, but acknowledged data can vanish on failover · sync: nothing lost, every write waits for a follower
   the common middle: one synchronous follower (semi-sync), the rest asynchronous

═══ quorums ═══
── 3 copies, the change reached only W=2 of them: [(2, 'exam moved to Tuesday'), (2, 'exam moved to Tuesday'), (1, 'exam on Monday')]
   read R=2 from copies 1 and 2 → 'exam moved to Tuesday' · copy [2] was stale and got repaired → [(2, 'exam moved to Tuesday'), (2, 'exam moved to Tuesday'), (2, 'exam moved to Tuesday')]
   R + W > N (2 + 2 > 3): every read quorum overlaps every write quorum, so the newest version is always seen
   anti-entropy (background repair) fixes copies nobody reads

═══ models ═══
── the same question — 'what is the exam day?' — under different promises:
   linearizable      every read sees the latest completed write, as if there were one copy
   sequential        everyone sees the same order, maybe a little late
   causal            if you saw the cause (the change notice), you will see its effect (the new timetable)
   read-your-writes  Dipika always sees the change SHE made, others may lag
   eventual          copies agree when writes stop — meanwhile anything goes
   stronger promises cost coordination (latency, availability) — pick per piece of data

═══ cap ═══
── the road between Pune+Nashik and Nagpur+Kolhapur is cut (a partition); Nagpur holds v1, the latest is v2
   CP: Nagpur is asked the exam day → refused — cannot reach a majority, so no answer rather than a wrong one
   AP: Nagpur is asked the exam day → answered v1 (stale!)
── both sides accepted a change during the split: (5, '3A trip on Friday') and (6, '3A trip on Saturday')
   last-writer-wins → '3A trip on Saturday' (the other write is silently dropped) · merge → ['3A trip on Friday', '3A trip on Saturday'] (a person decides)
   PACELC: during a Partition choose A or C; Else (normal days) choose Latency or Consistency

═══ raft ═══
── 5 branches run Raft; a leader needs a majority of ALL 5 (3 votes)
   term 1: nashik elected with 5/5 votes
   append 'exam on Tuesday', copied to pune + nagpur → committed — 3 of 5 with the leader
   append 'trip on Friday', copied to pune only   → not committed (no majority) — only 2 of 5
── the road splits: {nashik, pune} | {nagpur, kolhapur, satara}
   term 2: nashik got 2/5 — no majority, no leader
   term 3: nagpur elected with 3/5 votes
   the minority side cannot elect or commit — so there are never two leaders in the same term

═══ locks ═══
── Katrina takes the timetable lock, lease 1 s, fencing token 1 — then pauses for 2 s (a long GC)
   at 1.5 s the lease has expired; Aishwarya takes the lock → token 2 and writes → wrote 'timetable v2'
   Katrina wakes at 2.0 s, still thinks she holds the lock, writes with token 1 → refused token 1 (already saw 2)
   without fencing tokens → wrote 'timetable v1' — newer work silently overwritten
   a lease alone is not enough; the storage must check the token

═══ exactlyonce ═══
── the queue redelivers pay-dipika (at-least-once) · plain consumer      → effects ['pay-katrina', 'pay-dipika', 'pay-aishwarya', 'pay-dipika']
── the queue redelivers pay-dipika (at-least-once) · idempotent consumer  → effects ['pay-katrina', 'pay-dipika', 'pay-aishwarya']
   'exactly once' in the wire sense does not exist across a network; 'effectively once' = at-least-once + idempotency
   tools: idempotency keys, dedupe tables, upserts, the outbox, transactional reads-process-writes inside one system

═══ backpressure ═══
── 120 requests/s arrive, 100/s can be served · queue limit none → wait after 5 s 1.0 s, after 10 s 2.0 s · shed 0
── 120 requests/s arrive, 100/s can be served · queue limit  200 → wait after 5 s 1.0 s, after 10 s 1.0 s · shed 100
   an unbounded queue turns overload into ever-growing latency; a bounded one says 'try later' (429/503) early
── the whole picture: messengers fail → clocks disagree → copies drift → quorums and consensus agree → leases fence → keys dedupe → queues push back

✅ done — the branches agree🗺️ संपूर्ण चित्र — एक आकृती, पूर्ण कोर्स
संपूर्ण कोर्स एका कॅनव्हासवर. 4K आवृत्तीसाठी क्लिक करा.
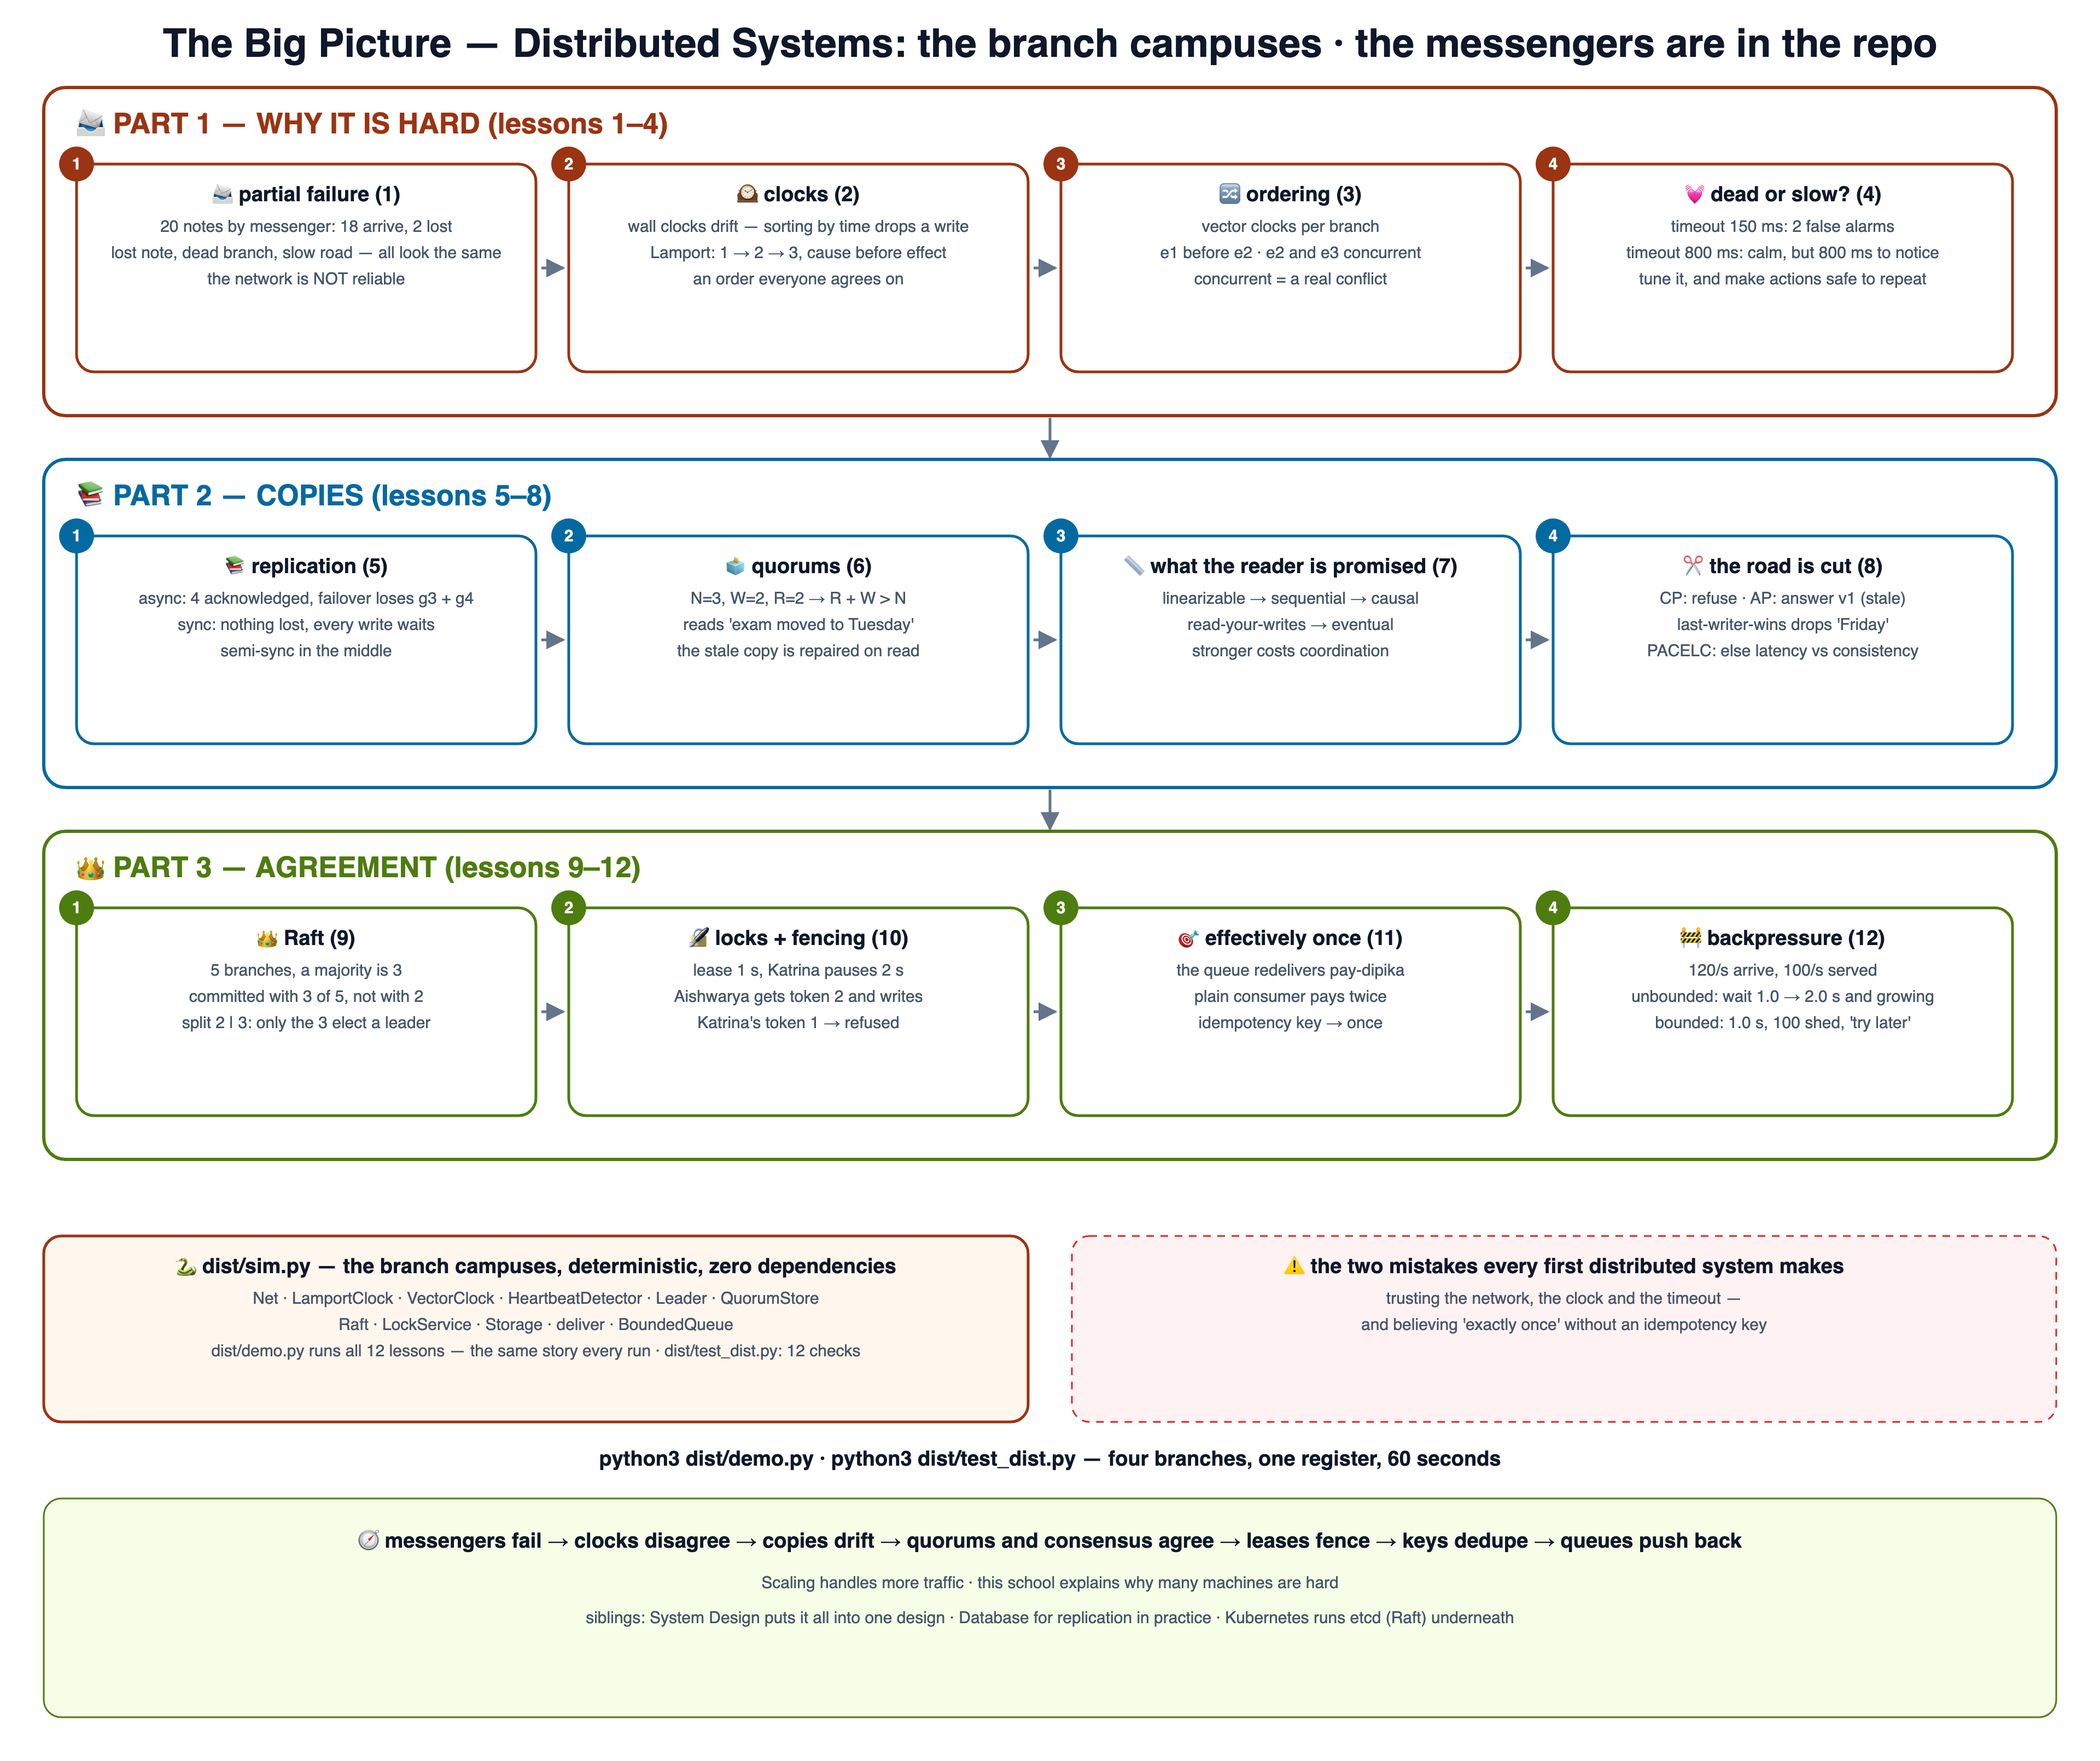
📨 भाग 1 — हे कठीण का आहे (धडे 1–4)
एक git branch = एक कल्पना; branch 04 मध्ये धडे 01–04 आहेत. dist/ चा प्रत्येक run सारखाच असतो — randomness seeded आहे.
📨 Partial failure
lesson-01-partial-failureधडा वाचा →आकृती पहा ↗🕰️ घड्याळे
lesson-02-clocksधडा वाचा →आकृती पहा ↗🔀 क्रम आणि causality
lesson-03-orderingधडा वाचा →आकृती पहा ↗💓 Failure detection
lesson-04-failure-detectionधडा वाचा →आकृती पहा ↗📚 भाग 2 — प्रती (धडे 5–8)
एकाच data च्या अनेक प्रती ठेवणे: त्या कशा वेगळ्या होत जातात, quorums सर्वात नवीन कसे वाचतात, आणि partition भाग पाडते ती निवड.
📚 Replication
lesson-05-replicationधडा वाचा →आकृती पहा ↗🗳️ Quorums
lesson-06-quorumsधडा वाचा →आकृती पहा ↗📏 Consistency models
lesson-07-consistency-modelsधडा वाचा →आकृती पहा ↗✂️ CAP आणि PACELC
lesson-08-cap-pacelcधडा वाचा →आकृती पहा ↗👑 भाग 3 — एकमत (धडे 9–12)
अनेक machines ना एकमत करून सुरक्षितपणे वागायला लावणे: consensus, fencing, idempotency आणि backpressure.
👑 Consensus आणि Raft
lesson-09-raftधडा वाचा →आकृती पहा ↗🔏 Locks, leases आणि fencing
lesson-10-locks-leasesधडा वाचा →आकृती पहा ↗🎯 exactly-once चे मिथक
lesson-11-exactly-onceधडा वाचा →आकृती पहा ↗🚧 Backpressure आणि संपूर्ण चित्र
lesson-12-backpressureधडा वाचा →आकृती पहा ↗📐 धड्यांच्या आकृत्या — क्रमांक अनुसरा
प्रत्येक धडा एका क्रमांकित बॉक्स-आणि-बाण आकृतीत — स्वतंत्र पानावरही.
1 📨 Partial failure
निरोप्यामार्फत बोलणाऱ्या शाखा — हरवलेली चिठ्ठी, बंद पडलेली शाखा आणि हळू रस्ता इथून सगळे सारखेच दिसतात.
शाळेच्या चार शाखा आहेत: पुणे, नाशिक, नागपूर आणि कोल्हापूर. त्या एकच नोंदवही वापरतात आणि निरोप्यामार्फत बोलतात. पुणे नाशिकला 20 चिठ्ठ्या पाठवते. 18 पोहोचतात, 2 हरवतात. उत्तर आले नाही तर पुण्याला कारण कळत नाही. चिठ्ठी हरवली? नाशिक बंद आहे? की उत्तर फक्त उशिरा येत आहे?
एका इमारतीत एक शाळा आणि एकच नोंदवही होती; office उघडे असेल तर उत्तर मिळे, नसेल तर ते बंद आहे हे कळत असे.
Distributed system म्हणजे शाखा: पुणे, नाशिक, नागपूर, कोल्हापूर एकच नोंदवही ठेवतात आणि निरोप्यामार्फत एकमत करतात.
पुणे नाशिकला 20 चिठ्ठ्या पाठवते, 10% हरवतात: 20 पैकी 18 पोहोचतात 5–48 ms मध्ये, आणि 2 हरवतात, परत काहीच कळत नाही.
पुण्याहून पाहिले तर हरवलेली चिठ्ठी, बंद पडलेले नाशिक, हरवलेले उत्तर आणि उशिराचे उत्तर सगळे सारखेच दिसतात: हेच partial failure.
पुढचा धडा विचारतो किती वाजले: पुणे आणि नाशिकची घड्याळे पुढे-मागे होतात, आणि wall-clock क्रम एक खरा बदल फेकून देतो.
2 🕰️ घड्याळे
प्रत्येक शाखेचे घड्याळ थोडेसे चुकीचे असते — wall time घटनांचा क्रम का ठरवू शकत नाही, आणि Lamport clocks.
पुण्याचे घड्याळ थोडे पुढे आहे आणि नाशिकचे थोडे मागे. पुणे 'exam at 10' लिहिते, मग नाशिक 'exam at 11' लिहिते. घड्याळाच्या वेळेनुसार पुणे शेवटचे दिसते, म्हणून नाशिकचा नवा बदल हरवतो. म्हणून शाखा घटना मोजतात: पुणे लिहिते 1, नाशिकला मिळते 2, नाशिक लिहिते 3.
शाखा प्रत्येक बदलावर आपल्या घड्याळाची वेळ टाकत आणि त्यानुसार क्रम लावत, सगळी घड्याळे सारखीच वेळ दाखवतात असे मानून.
घड्याळे पुढे-मागे होतात: पुणे 10:00:00.120 दाखवते तेव्हा नाशिक 09:59:59.980 दाखवते. Lamport clock त्याऐवजी घटना मोजते.
पुणे लिहिते (L=1), नाशिकला ती मिळते (L=2), नाशिक लिहिते (L=3): कारणाला नेहमी लहान क्रमांक मिळतो.
Wall time नुसार क्रम लावल्याने पुण्याचे 'exam at 10' शेवटचे दिसले, आणि नाशिकचा नंतरचा 'exam at 11' बदल गुपचूप फेकला गेला.
पुढचा धडा विचारतो आधी, नंतर की दोन्ही एकाच वेळी: vector clocks खरा क्रम आणि दोन स्वतंत्र बदल वेगळे ओळखतात.
3 🔀 क्रम आणि कार्यकारणभाव
आधी, नंतर, की एकाच वेळी — vector clocks खरे conflicts आणि साधा उशीर यातला फरक ओळखतात.
आता प्रत्येक चिठ्ठीवर एक छोटा तक्ता असतो: प्रत्येक शाखेचा एक आकडा. पुणे e1 लिहिते. नाशिक e1 वाचते, मग e2 लिहिते, म्हणून e1 हा e2 च्या आधी. नागपूर दोन्ही माहीत नसताना e3 लिहिते. कोणीच दुसऱ्याचे पाहिले नाही, म्हणून e3 दोघांशी concurrent आहे. हा कोणीतरी सोडवायचा खरा conflict आहे.
Lamport क्रमांक प्रत्येक बदल एका रांगेत लावत, पण दोन शाखांनी एकमेकांना न कळता बदल केले का हे सांगू शकत नसत.
Vector clock म्हणजे प्रत्येक चिठ्ठीवर प्रत्येक शाखेचा एक counter, त्यामुळे लिहिणाऱ्याने कोणते बदल वाचले होते ते नेमके दिसते.
पुण्यात e1, e1 वाचून नाशिकमध्ये e2, काहीच माहीत नसताना नागपूरमध्ये e3: e1 हा e2 च्या आधी, आणि e3 दोघांशी concurrent.
Concurrent म्हणजे कोणीच दुसऱ्याचे पाहिले नाही: हा सोडवायचा खरा conflict आहे, शेवटी आला तो निवडायचा क्रम नव्हे.
पुढचा धडा विचारतो कोल्हापूर बंद पडले की फक्त हळू आहे: heartbeats आणि timeout ठरवतात, आणि दोन्ही निवडींची किंमत असते.
4 💓 Failure detection
बंद पडली की फक्त हळू? Heartbeats, timeouts आणि खोटे अलार्म व उशिरा कळणे यांच्यातील तडजोड.
कोल्हापूर सुमारे दर 100 ms ला 'मी चालू आहे' चिठ्ठी पाठवते. दोनदा ती उशिरा येते, 340 ms आणि 180 ms, मग कोल्हापूर खरेच थांबते. 150 ms मर्यादेने इतर शाखा 2 खोटे alarm देतात. 800 ms ने खोटा alarm नाही, पण खरे थांबणे 800 ms नंतरच लक्षात येते.
शाखा गप्प झालेल्या शाखेची कायम वाट पाहत, किंवा ती अजून चालू आहे का हे शोधायला कोणीतरी फोन फिरवत असे.
Failure detector heartbeats ऐकतो; timeout मध्ये एकही आला नाही तर तो ती शाखा बंद पडली असे जाहीर करतो.
कोल्हापूरच्या gaps मध्ये 340 ms आणि 180 ms आहेत: 150 ms timeout ने 2 खोटे alarm, 800 ms ने 0, पण लक्षात यायला 800 ms.
जलद आणि शांत दोन्ही एकदम होता येत नाही, म्हणून timeout जुळवा आणि खोट्या alarm नंतरची प्रत्येक कृती पुन्हा करायला सुरक्षित ठेवा.
पुढचा धडा नोंदवहीच्या प्रती ठेवतो: async replication जलद आहे पण failover वर गुण हरवतो, sync काहीच हरवत नाही.
5 📚 Replication
रजिस्टरच्या प्रती — leader आणि followers, synchronous विरुद्ध asynchronous, आणि failover मध्ये काय हरवू शकते.
पुण्याकडे मुख्य नोंदवही आहे आणि इतर शाखांकडे प्रती. पुणे 4 गुणांसाठी 'saved' म्हणते, मग पुणे बंद पडते. पुण्याने प्रतींची वाट पाहिली नसेल, तर नव्या प्रमुखाकडे फक्त g1 आणि g2 असतात, g3 आणि g4 गेले. प्रत्येक वेळी एका प्रतीची वाट पाहिली असेल, तर चारही वाचतात, पण प्रत्येक write हळू झाला.
पुण्यात एकच नोंदवही: पुणे बंद पडले की प्रत्येक शाखा कालच्या रात्रीच्या backup मधून restore होईपर्यंत थांबत असे.
Replication नोंदवहीच्या प्रती इतर शाखांवर ठेवते; पुणे प्रमुख (leader) असते आणि followers त्याचा log copy करतात.
4 गुण acknowledged, मग पुणे बंद पडते: async failover g1 आणि g2 ठेवतो आणि g3, g4 हरवतो; sync चारही ठेवतो.
Async मध्ये acknowledged data नाहीसा होऊ शकतो; sync मध्ये प्रत्येक write थांबतो. Semi-sync एक खात्रीची प्रत ठेवतो, बाकी async.
पुढचा धडा पुरेशा प्रतींना एकमत करू देतो: N=3 मध्ये R=2 वाचणे आणि W=2 लिहिणे नेहमी सर्वात नवी version पाहते.
6 🗳️ Quorums
N पैकी W ला लिहा, R मधून वाचा — R + W > N ला सर्वात नवीन का दिसते, आणि read repair.
नोंदवहीच्या 3 प्रती आहेत. 'exam moved to Tuesday' हा बदल फक्त 2 प्रतींपर्यंत पोहोचतो; प्रत 2 अजून Monday सांगते. वाचणारी 2 प्रतींना विचारते आणि नवी version घेते, म्हणून तिला नेहमी Tuesday दिसतो. जाता जाता ती जुनी प्रत दुरुस्त करते. दोन writes अधिक दोन reads हे तीन प्रतींपेक्षा जास्त आहे.
प्रत्येक बदल प्रत्येक प्रतीपर्यंत पोहोचायलाच हवा होता, त्यामुळे एक हळू किंवा गैरहजर शाखा शाळेतील प्रत्येक write अडवत असे.
Quorum म्हणजे पुरेशा प्रतींचे एकमत: N पैकी W प्रतींवर लिहा, R वरून वाचा, आणि R + W > N ठेवा म्हणजे त्या एकमेकांवर येतात.
'exam moved to Tuesday' 3 पैकी W=2 पर्यंत पोहोचला; R=2 read तेच परत देतो आणि अजून Monday सांगणारी जुनी प्रत 2 दुरुस्त करतो.
2 + 2 > 3 असल्याने प्रत्येक read quorum प्रत्येक write quorum ला भेटतो, त्यामुळे वाचणाऱ्याला सर्वात नवी version नेहमी दिसते.
पुढचा धडा वाचणाऱ्याला काय वचन आहे त्याला नावे देतो: linearizable, sequential, causal, read-your-writes किंवा eventual.
7 📏 Consistency models
Linearizable, sequential, causal, read-your-writes, eventual — प्रत्येक जण वाचणाऱ्याला काय वचन देतो.
पालक विचारतात 'exam day कोणता?' उत्तर वचनावर अवलंबून असते. सर्वात मजबूत वचन एकाच प्रतीसारखे वागते: नेहमी सर्वात नवीन. कमी मजबूत: Dipika ला तिने केलेला बदल नेहमी दिसतो, इतर मागे असू शकतात. सर्वात कमकुवत: बदल थांबले की प्रती एकमत होतात. मजबूत वचनांना वेळ लागतो.
वाचणाऱ्याला काय वचन आहे हे कोणीच सांगत नसे, त्यामुळे एका पालकाला नवा exam day दिसे तर दुसऱ्याला अजून जुना.
Consistency model म्हणजे वाचणाऱ्याला मिळणारे वचन, linearizable (जणू एकच प्रत) पासून eventual पर्यंत.
'Exam day कोणता?' विचारा: linearizable सर्वात नवीन दाखवतो, causal notice शिवाय नवा timetable कधीच दाखवत नाही.
जास्त मजबूत वचनाला coordination ची किंमत लागते, latency आणि availability मध्ये, म्हणून प्रत्येक data साठी वचन वेगळे निवडा.
पुढचा धडा रस्ता तोडतो: CP उत्तर नाकारतो, AP जुने उत्तर देतो, आणि last-writer-wins एक खरा write टाकून देतो.
8 ✂️ CAP & PACELC
रस्ता तुटतो तेव्हा: नकार द्या किंवा जुने उत्तर द्या — आणि दोन्ही बाजूंनी केलेले दोन बदल कसे मिटवायचे.
पुणे-नाशिक आणि नागपूर-कोल्हापूर यांच्यातला रस्ता तुटला आहे. नागपूरकडे जुना exam day, v1 आहे. बरोबर राहायचे ठरवले तर ते उत्तर नाकारते. उघडे राहायचे ठरवले तर ते v1 देते, जे जुने आहे. दरम्यान दोन्ही बाजूंनी 3A trip चा दिवस लिहिला: Friday आणि Saturday. Last-writer-wins Saturday ठेवतो आणि Friday टाकून देतो.
शाखांमधले रस्ते कधी तुटत नाहीत असे सगळे मानत, त्यामुळे तुटलेल्या शाखेने काय करावे हे कोणी ठरवलेच नव्हते.
CAP: रस्ता तुटला (partition) की प्रत्येक शाखेने बरोबर राहणे (CP) किंवा उत्तर देत राहणे (AP) यापैकी एक निवडायचे.
नागपूरकडे v1, सर्वात नवी v2: CP नकार देतो, AP जुनी v1 देतो; LWW 'Saturday' ठेवतो आणि 'Friday' टाकून देतो.
Partition ही निवड करायला भाग पाडतो. PACELC जोडतो की सामान्य दिवशीही latency आणि consistency यांत देवाणघेवाण असते.
पुढचा धडा Raft ने एक प्रमुख (leader) निवडतो: 5 पैकी 3 मते जिंकतात, आणि अल्पसंख्य बाजू कधीच निवड किंवा commit करू शकत नाही.
9 👑 Consensus आणि Raft
एका leader आणि एका log वर एकमत — terms, मते, बहुमत, आणि अल्पमतातील बाजू का थांबते.
पाच शाखा, आता सातारा सोबत, एका प्रमुखासाठी मत देतात. नाशिक पाचही मते जिंकते. 5 पैकी 3 कडे बदल पोहोचला तरच तो ग्राह्य. मग रस्ता तुटतो: एका बाजूला नाशिक आणि पुणे, दुसऱ्या बाजूला नागपूर, कोल्हापूर आणि सातारा. नाशिकला फक्त 2 मते मिळतात आणि ते प्रमुख राहू शकत नाही. नागपूरला 3 मिळतात आणि ते नवे प्रमुख होते.
जुनी मुख्य शाखा बंद पडली की कोणीतरी हाताने नवी निवडत असे, आणि कधी कधी दोघींनाही आपणच प्रमुख वाटत असे.
Raft म्हणजे consensus: शाखा प्रत्येक term मध्ये एका प्रमुखाला मत देतात, आणि बहुमताने copy केल्यावरच बदल ग्राह्य धरला जातो.
नाशिक 5/5 जिंकते; 5 पैकी 3 वर 'exam on Tuesday' commit, 2 वर 'trip on Friday' नाही. रस्ता तुटल्यावर नागपूर 3/5 जिंकते.
2 शाखांच्या बाजूला फक्त 2/5 मिळतात आणि ती निवड किंवा commit करू शकत नाही, त्यामुळे एका term मध्ये कधीच दोन प्रमुख नसतात.
पुढचा धडा timetable ला कुलूप लावतो: lease संपते, आणि क्रमांक-टोकन (fencing token) थांबलेल्या holder ला लिहू देत नाही.
10 🔏 कुलूप, lease आणि fencing
संपणारे कुलूप, थांबलेला धारक — आणि जुन्या writes थांबवणारा token.
Katrina timetable चे कुलूप 1 second साठी घेते आणि तिला token 1 मिळतो. मग ती 2 seconds थांबून राहते. कुलूप संपते, म्हणून Aishwarya token 2 सह ते घेते आणि लिहिते. Katrina जागी होते, अजून कुलूप तिच्याकडे आहे असे तिला वाटते, आणि token 1 सह लिहिते. नोंदवहीने token 2 आधीच पाहिला आहे, म्हणून ती तिला नकार देते.
कुलूप कधी संपतच नसे, त्यामुळे timetable चे कुलूप धरून बंद पडलेली शाखा सगळ्यांना कायमचे अडवत असे.
Lease म्हणजे संपणारे कुलूप; क्रमांक-टोकन (fencing token) म्हणजे कुलूपाच्या प्रत्येक नव्या holder सोबत वाढणारा क्रमांक.
Katrina ला token 1 मिळतो आणि ती 2 s थांबते; Aishwarya ला token 2 मिळतो आणि ती लिहिते; Katrina चा उशिराचा token 1 write नाकारला जातो.
Token तपासला नाही तर Katrina ची 'timetable v1' नव्या कामावर लिहिली जाते; फक्त lease पुरेशी नाही.
पुढचा धडा पुनरावृत्ती हाताळतो: रांग pay-dipika पुन्हा देते, आणि फक्त idempotent consumer एकदाच पैसे देतो.
11 🎯 exactly-once चे मिथक
At-least-once delivery अधिक idempotency — हाच 'exactly once' चा खरा अर्थ.
रांग पैसे देण्याच्या चिठ्ठ्या पाठवते: Katrina ला द्या, Dipika ला द्या, Aishwarya ला द्या. एखादी चिठ्ठी दोनदा येऊ शकते, आणि pay-dipika दोनदा येते. साधा worker Dipika ला दोनदा पैसे देतो. काळजी घेणारा worker केलेली प्रत्येक चिठ्ठी लिहून ठेवतो आणि पुन्हा आलेली सोडून देतो, म्हणून प्रत्येकाला एकदाच पैसे मिळतात.
Teams रांग प्रत्येक message नेमका एकदाच देईल यावर विसंबत, आणि तो आधीच हाताळला आहे का ते तपासत नसत.
Effectively once म्हणजे at-least-once delivery अधिक idempotency: तोच message दोनदा आला तरी परिणाम एकदाच.
रांग pay-dipika पुन्हा देते: साधा consumer Dipika ला दोनदा पैसे देतो, idempotent consumer 3 जणांना एकदाच देतो.
Network वर wire-level exactly once अस्तित्वातच नाही, म्हणून idempotency keys आणि dedupe tables हे काम करतात.
पुढचा धडा 'नंतर या' म्हणतो: bounded रांग 100 requests नाकारते पण थांबणे 2.0 s ऐवजी 1.0 s वर ठेवते.
12 🚧 Backpressure आणि संपूर्ण चित्र
लवकरच 'नंतर प्रयत्न करा' म्हणा — मर्यादित रांगा, load shedding, आणि distributed system चा संपूर्ण नकाशा.
दर सेकंदाला 120 requests येतात, पण फक्त 100 हाताळता येतात. रांगेला मर्यादा नसेल तर 10 seconds नंतर थांबणे 2.0 s होते, आणि वाढतच राहते. 200 ची मर्यादा असेल तर थांबणे 1.0 s वरच राहते, आणि 100 requests ना दारातच 'नंतर या' सांगितले जाते. खूप लांब थांबण्यापेक्षा स्पष्ट नकार बरा.
प्रत्येक request स्वीकारली जात असे, त्यामुळे जास्त load वर रांग वाढत गेली आणि प्रत्येक request थांबून शेवटी time out झाली.
Backpressure म्हणजे bounded रांग, जी थांबणे कायम वाढू देण्याऐवजी लवकरच 'नंतर या' (429/503) सांगते.
120/s येतात, 100/s हाताळल्या जातात: unbounded थांबणे 10 s पर्यंत 2.0 s होते; 200 ची मर्यादा 1.0 s ठेवते आणि 100 नाकारते.
Backoff सह स्पष्ट 'नंतर या' हे सगळ्यांसाठी हळू timeout पेक्षा चांगले, आणि load खाली memory सुरक्षित राहते.
पुढे कुठे: System Design school हे सगळे खऱ्या designs मध्ये वापरते, Scaling traffic हाताळते, Database आणखी खोलात जाते.