📈 शाळेच्या पद्धतीने scaling शिका
सगळे एकाच वेळी आले की web app तो दिवस कसा निभावते, हे निकालाच्या दिवशीची शाळेची जत्रा म्हणून शिकवले आहे: प्रत्येक दारावर झेरॉक्स प्रती (CloudFront), जास्त खिडक्या (load balancers, Auto Scaling, Kubernetes, Lambda), सूचना फलक (Redis), नोंदवहीच्या प्रती (replicas) आणि टोकनची रांग (SQS). प्रत्येक धडा ही शाळेतील एक गोष्ट आहे, सोबत काढलेली आकृती आणि एक lab — आणि ही जत्रा repo मध्येच आहे: शुद्ध Python मधील छोटी, प्रामाणिक simulations (scale/sim.py, शून्य dependencies), जी तुम्ही overload करू शकता, tune करू शकता आणि मोडू शकता.
🖥️ भाग 1 — UI चे SCALING (1–4)
- up की out, आणि सर्वात हळू भाग 🎪
- बांधण्याआधी मोजा ⏱️
- प्रत्येक दारावर झेरॉक्स प्रती 🌍
- live पाने काही सेकंदांसाठी cache केलेली ⚡
🔌 भाग 2 — API चे SCALING (5–8)
- कोणतीही खिडकी कोणत्याही पालकांना सेवा देते ⚖️
- रांग वाढली की जास्त खिडक्या 📈
- pods, nodes आणि प्रामाणिक requests ☸️
- प्रत्येक पालकासाठी एक खिडकी 🪄
🗄️ भाग 3 — DATABASE चे SCALING (9–12)
- समोरचा सूचना फलक 📌
- नोंदवहीच्या प्रती 📚
- पसरणाऱ्या key ने विभागणी 🗂️
- गर्दीचा लोंढा दारावरच घ्या 📬
🛟 भाग 4 — बिघाडातून टिकणे (13)
- timeouts आणि सौम्य retries ⏳
- गर्दीचा ढीग थांबवणारा breaker 🔌
- error page पेक्षा छोटे page बरे 🪧
- पुन्हा केले तरी सुरक्षित, विषारी संदेश बाजूला 📬
# the 60-second wow — results day, simulated:
git clone https://github.com/BaluRaut/learn-scaling-school.git && cd learn-scaling-school
python3 scale/demo.py              # 13 lessons: every number, every run the same
python3 scale/test_scale.py        # 13 checks across the lessons
तुम्हाला काय दिसायला हवे (छाटलेले — यश असे दिसते):
═══ why ═══
── results day: 40 parents a second became 2,000 when the results went up
   scale UP  = a bigger counter (one server with more CPU) — simple, but there is always a biggest size
   scale OUT = more counters (more servers behind a load balancer) — no ceiling, but the app must allow it
      40 req/s at 150 req/s per server (run at 60%) →   1 server(s)
     400 req/s at 150 req/s per server (run at 60%) →   5 server(s)
    2000 req/s at 150 req/s per server (run at 60%) →  23 server(s)
   the slowest part sets the pace: the page, the API and the database each need their own plan

═══ measure ═══
── 20 requests timed at the counter (ms): 80 85 90 92 95 98 100 105 110 120 130 150 180 240 400 95 88 102 97 1200
   p50    100 ms
   p95    400 ms
   p99   1200 ms
   average 182.8 ms — one 1,200 ms visit hides inside it; percentiles show it
── Little's law: 2,000 req/s × 0.120 s = 240 requests in flight at once
   that is how many threads / connections / Lambda environments you need at that moment

═══ cdn ═══
── 3,000 requests in one minute for 6 pages, popular pages asked far more
   TTL   0 s → hit ratio   0.0% · origin (S3) sees 3,000 requests
   TTL   1 s → hit ratio  88.0% · origin (S3) sees   359 requests
   TTL  10 s → hit ratio  98.8% · origin (S3) sees    36 requests
   TTL  60 s → hit ratio  99.8% · origin (S3) sees     6 requests
── /app.js cached for a day: MISS then HIT; new release → invalidate → MISS
   better: versioned file names (app.3f9c.js) — a new name is a new cache key, no invalidation needed

═══ edge ═══
── what each response tells CloudFront and the browser
   /app.3f9c.js   Cache-Control: public, max-age=31536000, immutable
   /results/3A    Cache-Control: public, s-maxage=10, stale-while-revalidate=30
   /me            Cache-Control: private, no-store
── 5 edge locations, s-maxage 10 s, 60 s of traffic: origin gets 30 requests; with an origin shield: 6
   a 10-second cache on a busy dynamic page turns 2,000 req/s into 1 request per 10 s per location
   CloudFront Functions / Lambda@Edge: tiny code at the edge — redirects, headers, A/B cookies, auth checks

═══ balance ═══
── Katrina's 6 clicks, round-robin across 3 servers
   click  server  session in server memory      session in Redis (shared)
       1  srv-1   logged in                     logged in
       2  srv-2   NOT FOUND → login page        logged in
       3  srv-3   NOT FOUND → login page        logged in
       4  srv-1   logged in                     logged in
       5  srv-2   NOT FOUND → login page        logged in
       6  srv-3   NOT FOUND → login page        logged in
   stateless servers: keep sessions, uploads and caches OUTSIDE the server — then any server can answer
   the load balancer health-checks every server and only sends visitors to healthy ones

═══ autoscale ═══
── results go up at minute 2: target 60% CPU, 150 req/s per server, 2-minute warm-up
   min  req/s  serving  util  over capacity (slow / 5xx)
     0    150        2   50%        0
     1    150        2   50%        0
     2    900        2  100%      600
     3   1800        2  100%     1500
     4   2400       10  100%      900
     5   2400       20   80%        0
     6   2400       20   80%        0
     7   1200       20   40%        0
     8    600       19   21%        0
     9    300       18   11%        0
    10    300       17   12%        0
    11    300       16   12%        0
   the spike arrives faster than new servers warm up → schedule a scale-out BEFORE results day,
   keep a warm minimum, and scale in slowly (one server at a time)

═══ kubernetes ═══
── HorizontalPodAutoscaler on CPU utilisation: desired = ceil(replicas × current % / target %), 10% tolerance
   4 pods at 90% CPU, target 60% → 6 pods
   6 pods at 63% CPU, target 60% → 6 pods
   6 pods at 30% CPU, target 60% → 3 pods
   3 pods at 240% CPU, target 60% → 12 pods
── 16 pods requesting 500m CPU on 2,000m nodes → 4 nodes (4 pods fit per node)
   the same pods requesting 1,100m → 16 nodes (1 fits, 900m wasted per node)
   pods that cannot be placed stay Pending → Cluster Autoscaler / Karpenter adds nodes
   honest CPU/memory requests are what make both autoscalers work

═══ serverless ═══
── Lambda: concurrency ≈ requests per second × average duration (steady traffic; bursts need more)
     100 req/s × 200 ms →    20 environments at once
    2000 req/s × 200 ms →   400 environments at once
    2000 req/s ×  50 ms →   100 environments at once
── the results spike, reserved concurrency 300, cold start ~600 ms:
   second 0:   100 req/s → needs  20, runs  20, cold starts  20, throttled     0
   second 1:  2000 req/s → needs 400, runs 300, cold starts 280, throttled   500
   second 2:  2000 req/s → needs 400, runs 300, cold starts   0, throttled   500
   second 3:   500 req/s → needs 100, runs 100, cold starts   0, throttled     0
── with 400 provisioned (pre-warmed) environments: cold starts at 2,000 req/s = 0
   account default: 1,000 concurrent executions per Region (a quota you can raise)

═══ cache ═══
── 6,000 reads of results:3A in a minute, cache TTL 30 s → database reads: 2, hits: 5,998
   the key expires while 500 parents are waiting — single-flight off → database reads: 500
   the key expires while 500 parents are waiting — single-flight on  → database reads: 1
   cache-aside: read the cache, on a miss read the DB and fill the cache; on a write, delete the key

═══ replicas ═══
── Katrina's grade is written to the primary at t=1000 ms; the replica lags 200 ms
   read from the replica at t=1050 ms → None
   read from the replica at t=1150 ms → None
   read from the replica at t=1250 ms → A+
   read-your-own-writes: after a write, read that user's data from the primary for a moment
── 800 Lambda environments × 1 connection, max_connections 500, proxy pool   — → opened 500, refused 300
── 800 Lambda environments × 1 connection, max_connections 500, proxy pool 100 → opened 100, refused 0
   RDS Proxy (or PgBouncer) shares a small pool of real connections among many callers

═══ shards ═══
── 1,000 pupils hashed across 4 partitions → [245, 262, 249, 244]
   partition key = class, results day (900 of 1,000 writes are 3A) → [19, 31, 928, 22] — one HOT partition
   write-sharding the hot key (class-3A#0 … #39) → [179, 253, 277, 291]
   DynamoDB: a partition gives up to 3,000 RCU + 1,000 WCU (1 RCU = one strong 4 KB read/s, 1 WCU = one 1 KB write/s)
   bigger items use more units; adaptive capacity helps a bit — a key that spreads is still the real fix

═══ queues ═══
── certificate PDFs: 800 requests/s for 3 seconds; each worker makes 100 PDFs/s
   fixed 3 workers                                      peak backlog  1500 · left after 10 s  150
   scale on backlog (1 worker per 100 waiting, max 10)  peak backlog   800 · left after 10 s    0
   the queue (SQS) absorbs the burst; workers process messages asynchronously, at their own pace
   SQS delivers at least once: a visibility timeout, retries, a DLQ and idempotent workers make failed work safe to recover
── the whole fair: CloudFront → load balancer / API Gateway → pods or Lambda → Redis → primary + replicas,
   slow work through a queue — and every tier scales on its own signal

═══ resilience ═══
── timeouts: the results API usually answers in 120 ms; today it is stuck at 30 s
   latency    120 ms, timeout 1,000 ms → ('ok', 120)
   latency  30000 ms, timeout 1,000 ms → ('timeout', 1000)
   without a timeout every thread waits 30 s — 2,000 req/s × 30 s = 60,000 stuck requests (Little's law again)
── retries: 500 clients fail at once and retry 4 times (backoff 100 → 800 ms)
   no jitter   → busiest 10 ms:  500 retries hit the database together
   full jitter → busiest 10 ms:   81 retries hit the database together
── circuit breaker (5 failures → open for 10 s → one trial call); the payments service is down for 30 s
   calls that reached the sick service: 7 · failed fast without waiting: 27 · state at 40 s: closed
── graceful degradation: the grade service is down → show the results page from Redis, marked '5 minutes old'
   a slower, older page beats an error page; non-essential parts (photos, recommendations) can switch off
── at-least-once: 4 deliveries for 3 payments → plain worker charges 4, idempotent worker charges 3
── a poison message: 9 PDFs made, ['pdf-7'] moved to the DLQ after 3 receives (12 receives in total)
── multi-AZ: one AZ at 99.5% → two AZs 99.9975% · three AZs 99.999988%
   a chain API 99.9% × Redis 99.9% × database 99.95% = 99.75% — every dependency lowers the total
   scaling adds capacity; resilience keeps the fair open when one part of it breaks

✅ done — the fair survived results day🗺️ संपूर्ण चित्र — एक आकृती, पूर्ण कोर्स
संपूर्ण कोर्स एका कॅनव्हासवर. 4K आवृत्तीसाठी क्लिक करा.
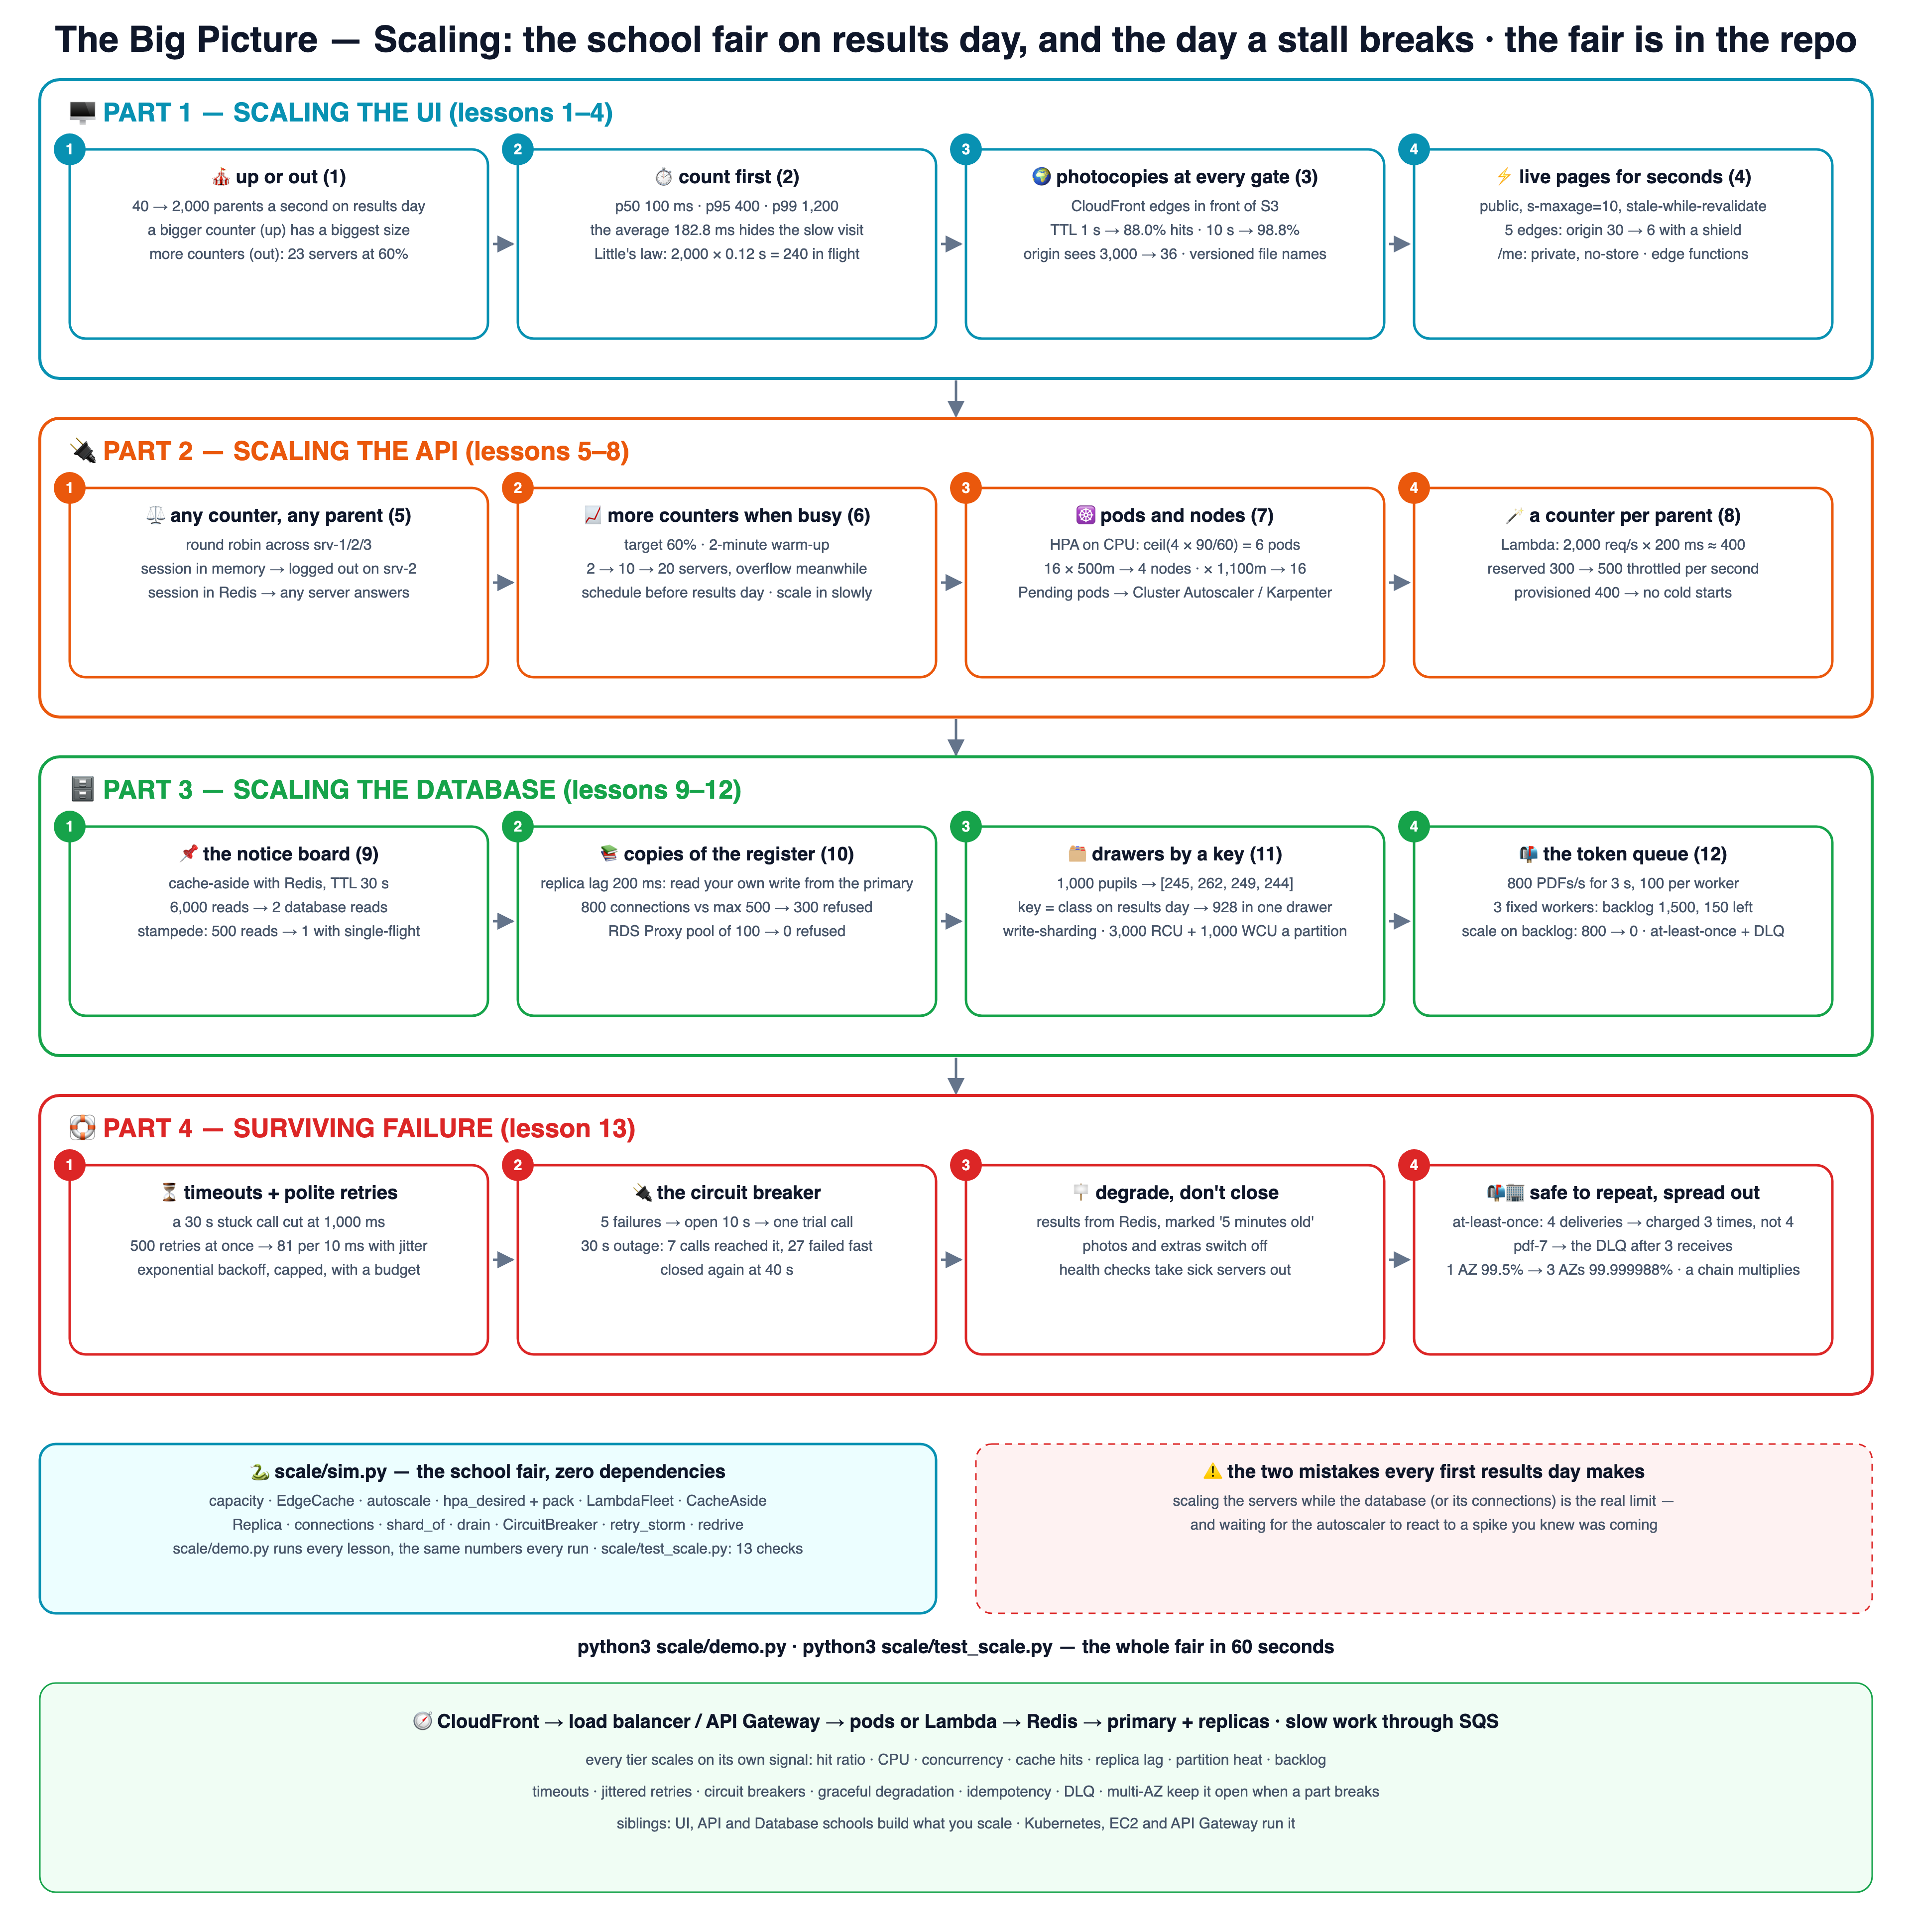
🖥️ भाग 1 — UI चे scaling (धडे 1–4)
एक git branch = एक कल्पना; branch 04 मध्ये धडे 01–04 आहेत. प्रत्येक आकडा scale/sim.py मधून येतो — cloud account ची गरज नाही.
🎪 Scaling का
lesson-01-why-scalingधडा वाचा →आकृती पहा ↗⏱️ Load मोजणे
lesson-02-measuring-loadधडा वाचा →आकृती पहा ↗🌍 UI साठी CloudFront + S3
lesson-03-cloudfront-s3धडा वाचा →आकृती पहा ↗⚡ Edge वर dynamic पाने
lesson-04-dynamic-at-the-edgeधडा वाचा →आकृती पहा ↗🔌 भाग 2 — API चे scaling (धडे 5–8)
UI मागे क्षमता वाढवण्याचे चार मार्ग — servers, Auto Scaling groups, Kubernetes आणि serverless — आणि प्रत्येकाला तुमच्या code कडून काय हवे.
⚖️ Stateless APIs + load balancers
lesson-05-stateless-load-balancerधडा वाचा →आकृती पहा ↗📈 Auto Scaling
lesson-06-auto-scalingधडा वाचा →आकृती पहा ↗☸️ Kubernetes वर scaling
lesson-07-kubernetes-scalingधडा वाचा →आकृती पहा ↗🪄 Serverless scaling
lesson-08-serverless-scalingधडा वाचा →आकृती पहा ↗🗄️ भाग 3 — database चे scaling (धडे 9–12)
Database ही सहसा सहज copy करता न येणारी शेवटची गोष्ट असते — ती cache करा, वाचनासाठी तिच्या प्रती करा, तिची विभागणी करा, आणि हळू कामे रांगेत टाका.
📌 Database चे caching
lesson-09-caching-the-databaseधडा वाचा →आकृती पहा ↗📚 Read replicas + connection pools
lesson-10-replicas-and-poolsधडा वाचा →आकृती पहा ↗🗂️ Partitioning + DynamoDB
lesson-11-partitioningधडा वाचा →आकृती पहा ↗📬 Queues + संपूर्ण आराखडा
lesson-12-queues-and-blueprintधडा वाचा →आकृती पहा ↗🛟 भाग 4 — बिघाडातून टिकणे (धडा 13)
क्षमता हे scaling चे फक्त अर्धे काम आहे: जत्रेचा एखादा भाग बिघडला तरी हा धडा जत्रा चालू ठेवतो.
🛟 बिघाडातून टिकणे
lesson-13-surviving-failureधडा वाचा →आकृती पहा ↗📐 धड्यांच्या आकृत्या — क्रमांक अनुसरा
प्रत्येक धडा एका क्रमांकित बॉक्स-आणि-बाण आकृतीत — स्वतंत्र पानावरही.
1 🎪 Scaling का
शाळेच्या जत्रेतील निकालाचा दिवस — दर सेकंदाला 40 पालकांचे 2,000 होतात; मोठी खिडकी (up) की जास्त खिडक्या (out), आणि सर्वात हळू भाग वेग ठरवतो.
सामान्य दिवशी शाळेच्या office मध्ये थोडेच पालक येतात. निकालाच्या दिवशी सगळे एकदम येतात. एक खिडकी मोठी करता येते, किंवा शेजारी शेजारी अनेक खिडक्या उघडता येतात. जास्त खिडक्या वाढतच राहू शकतात. पण रांग तिच्या सर्वात हळू पायरीइतक्याच वेगाने पुढे सरकते.
वर्षभर एक server सेकंदाला 40 पालक सांभाळत होता; मग निकाल लागला आणि एकदम सेकंदाला 2,000 पालक आले.
Scaling म्हणजे निकालाच्या दिवशीची शाळेची जत्रा: मोठी खिडकी (up) किंवा जास्त खिडक्या (out); सर्वात हळू भाग वेग ठरवतो.
एक server 150 req/s, 60% वर चालवला तर 40 req/s ला 1 server, 400 req/s ला 5 आणि 2,000 req/s ला 23 servers लागतात.
Scale out ला मर्यादा नसते आणि एक server गेला तरी तो अनेकांपैकी एकच असतो, त्यामुळे निकालाच्या दिवशी पूर्ण site बंद पडत नाही.
पुढचा धडा बांधण्याआधी मोजतो: p50, p95, p99 आणि Little's law traffic ला servers च्या खऱ्या संख्येत बदलतात.
2 ⏱️ Load मोजणे
बांधण्याआधी मोजा — p50, p95, p99, Little's law, load tests आणि एका आकड्याचा खरा अर्थ किती servers.
Dipika खिडकीवर प्रत्येक पालकाची वेळ मोजते. बहुतेक जण सुमारे 100 ms मध्ये संपवतात, पण एकाला 1,200 ms थांबावे लागते. सरासरी ठीक दिसते आणि त्या पालकाला लपवते. म्हणून ती वेळा क्रमाने लावते आणि हळू टोक पाहते: p95 आणि p99. आता तिला खरोखर किती खिडक्या लागतील ते कळते.
Teams सरासरी 182.8 ms पाहून नियोजन करत, आणि खिडकीवर 1,200 ms थांबलेला एक पालक त्यांना कधी दिसलाच नाही.
Load मोजणे म्हणजे खिडकीवर प्रत्येक पालकाची वेळ मोजणे: सरासरी लपवते त्या हळू भेटी percentiles दाखवतात.
20 मोजलेल्या requests मधून p50 100 ms, p95 400 ms, p99 1200 ms; 2,000 req/s × 0.12 s = 240 requests एकाच वेळी चालू.
खरे आकडे किती threads, connections किंवा servers लागतील ते सांगतात, निकालाचा दिवस ते तुम्हाला दाखवण्याआधीच.
पुढचा धडा UI पासून सुरू होतो: प्रत्येक gate वर झेरॉक्स प्रती, म्हणजे origin ऐवजी CloudFront pages देते.
3 🌍 UI साठी CloudFront + S3
प्रत्येक दारावर झेरॉक्स प्रती — प्रत्येक पालकाजवळ edge cache, TTLs, hit ratio, invalidation आणि versioned files.
सगळ्यांना तीच निकालाची यादी हवी असते. सगळे पालक एकाच office मध्ये गेले तर रांग संपतच नाही. म्हणून शाळा प्रत्येक gate वर झेरॉक्स प्रती ठेवते. प्रत्येक gate आपली प्रत काही सेकंद देते, मग नवी आणते. Office ला फक्त प्रत न मिळालेले थोडे पालक दिसतात.
प्रत्येक शहरातले पालक प्रत्येक page एकाच S3 origin कडून आणत: मिनिटाला 3,000 requests, सगळ्या एकाच जागी.
CloudFront प्रत्येक gate वर झेरॉक्स प्रती ठेवते: प्रत्येक पालकाजवळचा edge cache UI च्या प्रती TTL पर्यंत ठेवतो.
मिनिटाच्या 3,000 requests पैकी TTL 0 s ला सगळ्या 3,000 S3 कडे जातात; TTL 10 s ला 98.8% hit ratio आणि S3 ला फक्त 36.
पालकांना जवळच्या edge वरून pages मिळतात, जलद आणि स्वस्त; app.3f9c.js सारख्या versioned नावांना invalidation लागत नाही.
पुढचा धडा live pages सुद्धा edge वर काही सेकंद cache करतो: Cache-Control, stale-while-revalidate आणि shield वापरून.
4 ⚡ edge वर dynamic पाने
गजबजलेली live पानेसुद्धा काही सेकंदांसाठी cache करता येतात — Cache-Control, stale-while-revalidate, origin shield आणि edge functions.
निकालाचा फलक बदलतो, पण दर सेकंदाला नाही. 10 सेकंद जुनी प्रतही गर्दीसाठी चालते. प्रत किती वेळ ठेवायची ते सांगणारी चिठ्ठी प्रत्येक page सोबत असते. तुमच्या स्वतःच्या गुणांसारख्या private page वर मात्र माझी कधीच प्रत काढू नका अशी चिठ्ठी असते.
/results/3A सारखी live pages कधीच cache होत नसत, त्यामुळे प्रत्येक पालकाचा refresh थेट origin पर्यंत जात असे.
गर्दीच्या निकालाचीही 10 सेकंदांसाठी झेरॉक्स प्रत काढता येते: प्रत किती वेळ चालेल ते Cache-Control प्रत्येक gate ला सांगते.
/results/3A पाठवते s-maxage=10, stale-while-revalidate=30; 5 edges origin ला 30 requests पाठवतात, shield सह फक्त 6.
10 सेकंदांचा cache 2,000 req/s ला प्रत्येक location मागे 10 s ला 1 request बनवतो, आणि /me private, no-store च राहते.
पुढचा धडा API कडे वळतो: load balancer मागे stateless servers, म्हणजे कोणतीही खिडकी कोणत्याही पालकाला सेवा देऊ शकते.
5 ⚖️ Stateless APIs + load balancers
कोणतीही खिडकी कोणत्याही पालकांना सेवा देऊ शकते — sessions server memory बाहेर, health checks, round robin.
Katrina सहा वेळा click करते आणि प्रत्येक वेळी वेगळी खिडकी उत्तर देते. फक्त खिडकी 1 लाच ती लक्षात असेल, तर खिडकी 2 आणि 3 तिला पुन्हा login ला पाठवतात. म्हणून शाळा तिचे नाव सगळ्या खिडक्या वाचू शकतील अशा एका सामायिक नोंदवहीत लिहिते. आता कोणतीही खिडकी तिला सेवा देऊ शकते.
Sessions server च्या memory मध्ये होते, त्यामुळे round robin ने click srv-2 किंवा srv-3 कडे पाठवताच Katrina logout होत असे.
Stateless म्हणजे कोणतीही खिडकी कोणत्याही पालकाला सेवा देऊ शकते: sessions Redis मध्ये राहतात आणि load balancer पालक वाटून देतो.
Katrina चे 6 clicks round robin ने 3 servers वर जातात: memory sessions 4 clicks वर अपयशी, Redis मुळे ती सहाही वेळा logged in.
Servers मोकळेपणाने वाढवता किंवा काढता येतात, आणि health checks बंद पडलेल्या खिडकीपासून पालकांना दूर ठेवतात.
पुढचा धडा रांग वाढली की आपोआप खिडक्या वाढवतो: target tracking आणि warm-up सह Auto Scaling.
6 📈 Auto Scaling
रांग वाढली की जास्त खिडक्या — target tracking, warm-up, scheduled scaling आणि हळूहळू scale in.
रांग वाढली की शाळा जास्त खिडक्या उघडते. पण नवी खिडकी तयार व्हायला दोन मिनिटे लागतात. निकाल आधी लागला तर पालक लांब रांगेत थांबतात. म्हणून निकालाच्या दिवशी शाळा जादा खिडक्या आधीच उघडते. गर्दी गेली की त्या एकेक करून बंद करते.
मिनिट 2 ला निकाल लागेपर्यंत दोन servers 50% वर चालत होते; मिनिट 3 पर्यंत 1,500 req/s क्षमतेबाहेर गेल्या.
रांग वाढली की Auto Scaling जास्त खिडक्या उघडते: target tracking servers वाढवून CPU 60% जवळ ठेवते.
2,400 req/s वर servers 2 → 10 → 20 झाले, पण 2 मिनिटांच्या warm-up मुळे 600, 1,500 आणि 900 req/s क्षमतेबाहेर राहिल्या.
क्षमता गर्दीमागे जाते, आणि निकालाच्या दिवसाआधी scheduled scale-out केला तर कोणत्याही पालकाला हळू page दिसत नाही.
पुढचा धडा Kubernetes वर scale करतो: CPU-utilisation target साठी HPA pods वाढवतो, आणि Karpenter त्यांच्याखाली nodes वाढवतो.
7 ☸️ Kubernetes वर scaling
Pods आणि ते ज्या जमिनीवर उभे असतात ती — CPU target साठी HPA सूत्र, प्रामाणिक requests, bin packing, Cluster Autoscaler आणि Karpenter.
प्रत्येक खिडकी म्हणजे pod नावाचा छोटा stall, आणि stalls nodes नावाच्या जमिनीच्या तुकड्यांवर उभे असतात. Stalls वर खूप काम आले की एक मदतनीस आणखी stalls लावतो. जमीन उरली नाही की दुसरा मदतनीस आणखी जमीन भाड्याने घेतो. प्रत्येक stall ने किती जागा लागते ते प्रामाणिकपणे सांगायला हवे.
निकालाच्या दिवशी ठरावीक pods 90% CPU वर होते, आणि कोणत्याही node वर जागा नसल्याने नवे pods Pending राहिले.
Pods म्हणजे खिडक्या आणि nodes म्हणजे त्या उभ्या असलेली जमीन: HPA pods वाढवतो, Karpenter त्यांच्यासाठी जमीन वाढवतो.
4 pods 90% CPU वर, CPU-utilisation target 60% साठी → ceil(4 × 90/60) = 6 pods; 500m मागणारे 16 pods 2,000m च्या 4 nodes वर बसतात.
प्रामाणिक requests मुळेच दोन्ही autoscalers चालतात: 1,100m मागितले तर तेच 16 pods 16 nodes घेतात.
पुढचा धडा serverless कडे जातो: Lambda प्रत्येक पालकासाठी खिडकी उघडते, आणि concurrency ≈ requests × duration.
8 🪄 Serverless scaling
प्रत्येक पालकासाठी एक खिडकी उघडते — Lambda concurrency ≈ requests × duration, cold starts, reserved आणि provisioned concurrency.
कल्पना करा, पालक येताच प्रकट होणारी आणि तो गेल्यावर नाहीशी होणारी जादूची खिडकी. तेच Lambda. सेकंदाला 2,000 पालक, प्रत्येकी सेकंदाचा पाचवा भाग, म्हणजे एकाच वेळी 400 खिडक्या. अगदी नवी खिडकी पहिल्या पाहुण्यासाठी हळू असते, म्हणून काही खिडक्या तयार ठेवता येतात.
Autoscaled servers ना सुद्धा warm up व्हायला मिनिटे लागत, आणि शांत रात्रीही न वापरलेल्या खिडक्यांचे पैसे भरावे लागत.
Lambda प्रत्येक पालकासाठी खिडकी उघडते: स्थिर traffic साठी concurrency ≈ सेकंदाला requests × duration.
2,000 req/s × 200 ms ला 400 environments लागतात; reserved concurrency 300 असताना दर सेकंदाला 500 req/s throttled झाल्या.
पैसे प्रति millisecond आणि scaling प्रति request; 400 provisioned environments मुळे 2,000 req/s वर cold starts 0 झाले.
पुढचा धडा database पर्यंत पोहोचतो: त्याच्यासमोर सूचना फलक, Redis cache-aside, म्हणजे बहुतेक reads त्याच्यापर्यंत जातच नाहीत.
9 📌 Database चे caching
कार्यालयासमोरचा सूचना फलक — Redis सह cache-aside, TTLs, hit ratio आणि stampede थांबवणे.
पालक office ला सारखा तोच प्रश्न विचारतात: 3A चा निकाल काय? म्हणून office उत्तर सूचना फलकावर लावते. पालक फलक वाचतात, आणि सूचना काढली गेली तरच office ला विचारले जाते. ती काढली की एकच मदतनीस नवे उत्तर आणतो आणि बाकी सगळे थांबतात.
प्रत्येक पालकाचा refresh database वर तीच निकालाची query चालवत असे: एका मिनिटात results:3A चे 6,000 reads.
Redis म्हणजे office समोरचा सूचना फलक: आधी फलक वाचा, आणि miss झाला तरच office ला विचारा.
TTL 30 s सह 6,000 reads म्हणजे फक्त 2 DB reads; 500 जण थांबले असताना key expire झाली, तर single-flight 500 reads चे 1 करते.
Database ला कामाचा अगदी लहान वाटा उरतो, आणि एका expired key वरचा stampede आता त्याला पाडू शकत नाही.
पुढचा धडा नोंदवहीच्या प्रती बनवतो: वाचणाऱ्यांसाठी read replicas, आणि connections वाटून देणारा proxy.
10 📚 Read replicas + connection pools
वाचणाऱ्यांसाठी नोंदवहीच्या प्रती — replica lag, read-your-own-writes, आणि connections वाटून घेणारा proxy.
शाळा एक मुख्य नोंदवही आणि वाचण्यासाठी काही प्रती ठेवते. प्रती थोड्या उशिराने update होतात. Aishwarya मुख्य नोंदवहीत Katrina चा grade लिहिते, आणि प्रतीमध्ये तो 200 ms नंतर दिसतो. म्हणून लिहिल्यानंतर लगेच मुख्य नोंदवहीतूनच वाचा. एक मदतनीस काही पेन अनेक लिहिणाऱ्यांमध्ये वाटूनही देतो.
एकच database प्रत्येक read आणि write घेत होता, आणि फक्त 500 परवानगी असताना 800 Lambdas ना प्रत्येकी connection हवे होते.
Read replicas म्हणजे वाचणाऱ्यांसाठी नोंदवहीच्या प्रती; RDS Proxy काही खरे connections अनेक callers मध्ये वाटून देते.
200 ms replica lag मुळे Katrina चा grade 1050 ms ला None आणि 1250 ला A+ दिसतो; 100 च्या pool मधून 800 callers: 0 refused.
Reads प्रतींवर पसरतात, writes primary वर सुरक्षित राहतात, आणि database connections नाकारणे थांबवतो.
पुढचा धडा नोंदवहीच विभागतो: पसरणाऱ्या key ने partitions, hot key आणि DynamoDB च्या मर्यादा.
11 🗂️ Partitioning + DynamoDB
पसरणाऱ्या key ने नोंदवहीची विभागणी करा — hash partitions, hot key, write-sharding आणि DynamoDB चे per-partition capacity units.
एक नोंदवही एका कारकुनासाठी खूप जाड आहे. म्हणून शाळा ती एका key ने कप्प्यांमध्ये विभागते, आणि प्रत्येक कारकून एक कप्पा सांभाळतो. Class नुसार विभागली तर निकालाच्या दिवशीची प्रत्येक नोंद 3A च्या कप्प्यात जाते. तो कप्पा ओसंडून वाहतो आणि बाकीचे रिकामे राहतात. चांगली key पाने पसरवते.
Replicas reads वाढवतात, पण प्रत्येक write अजूनही एकाच primary कडे जातो, आणि निकालाच्या दिवशीचे writes एकाच नोंदवहीवर साचतात.
Partitioning नोंदवही एका key ने कप्प्यांमध्ये विभागते; चांगली key पाने सगळ्या कप्प्यांत सारखी पसरवते.
1,000 विद्यार्थी 4 partitions वर hash केले की प्रत्येकी सुमारे 250; class ही key घेतली तर एका hot partition ला 1,000 पैकी 928 writes.
DynamoDB चा एक partition जास्तीत जास्त 3,000 RCU + 1,000 WCU देतो; मोठे items जास्त units वापरतात — पसरणारी key हाच खरा उपाय.
पुढचा धडा हळू काम रांगेत टाकतो: SQS gate वरच गर्दी झेलते, आणि workers backlog नुसार scale होतात.
12 📬 Queues + संपूर्ण आराखडा
गर्दीचा लोंढा दारावरच घ्या, आपल्या गतीने काम करा — SQS, at-least-once delivery, backlog नुसार scale होणारे workers, आणि पूर्ण scale झालेली जत्रा.
Certificates छापायला वेळ लागतो. पालकांना खिडकीवर थांबवण्याऐवजी शाळा tokens देते आणि पालक घरी जातात. Workers आपल्या वेगाने certificates छापतात. Tokens चा ढीग वाढला की आणखी workers मदतीला येतात. छपाई अपयशी झाली तर ती पुन्हा केली जाते, त्यामुळे काम सुरक्षितपणे परत मिळवता येते.
पालक थांबलेला असतानाच certificate PDFs बनत, त्यामुळे सेकंदाला 800 requests च्या गर्दीने प्रत्येक page हळू झाले.
SQS म्हणजे gate वरची token रांग: पालक token घेऊन जातात, आणि workers messages asynchronously, आपल्या वेगाने हाताळतात.
3 s साठी सेकंदाला 800 PDFs: 3 ठरावीक workers ना peak 1,500 आणि 150 उरतात; backlog नुसार scaling ला peak 800 आणि शेवटी 0.
रांग गर्दी झेलते; retries, DLQ आणि idempotent workers असतील तर अपयशी काम सुरक्षितपणे परत मिळवता येते.
पुढचा धडा अपयशातून तगून राहतो: timeout (वेळेची मर्यादा), jitter सह retry (पुन्हा प्रयत्न), circuit breaker (स्विच), DLQ आणि एकापेक्षा जास्त AZ.
13 🛟 बिघाडातून टिकणे
फक्त scaling पुरेसे नाही — timeouts, backoff आणि jitter सह retries, circuit breakers, graceful degradation, idempotency, DLQs आणि multi-AZ.
शाळेच्या जत्रेत payments चा stall बिघडतो. Dipika 1 सेकंदानंतर थांबणे सोडते. पुन्हा प्रयत्न करणारे पालक थोडा अनियमित वेळ थांबतात, म्हणजे ते सगळे एकदम परत येत नाहीत. Stall बरा होईपर्यंत एक स्विच कोणालाही तिकडे पाठवत नाही. सूचना फलक अजूनही निकाल दाखवतो, काही मिनिटे जुना. दोनदा आलेला token एकदाच charge होतो, आणि दुसरी इमारत जत्रा चालू ठेवते.
एका अडकलेल्या service ने प्रत्येक thread 30 s धरून ठेवला, आणि 99.9% × 99.9% × 99.95% ची साखळी फक्त 99.75% चालू होती.
Resilience म्हणजे एक stall बिघडला तरी शाळेची जत्रा चालू ठेवणे: timeout (वेळेची मर्यादा), retry (पुन्हा प्रयत्न), circuit breaker (स्विच) आणि plan B.
1,000 ms चा timeout 30 s अडकलेल्या call ला हरवतो; jitter एकदम 500 retries चे 10 ms मागे 81 करतो; breaker ने 7 आत सोडले, 27 लगेच अपयशी.
4 deliveries असूनही idempotent worker 3 च charges करतो, 3 receives नंतर pdf-7 DLQ मध्ये जातो, आणि दोन AZs 99.5% चे 99.9975% करतात.
पुढे कुठे: Kubernetes school खिडक्या चालवते, Database school नोंदवही, आणि API Gateway school मुख्य दार.