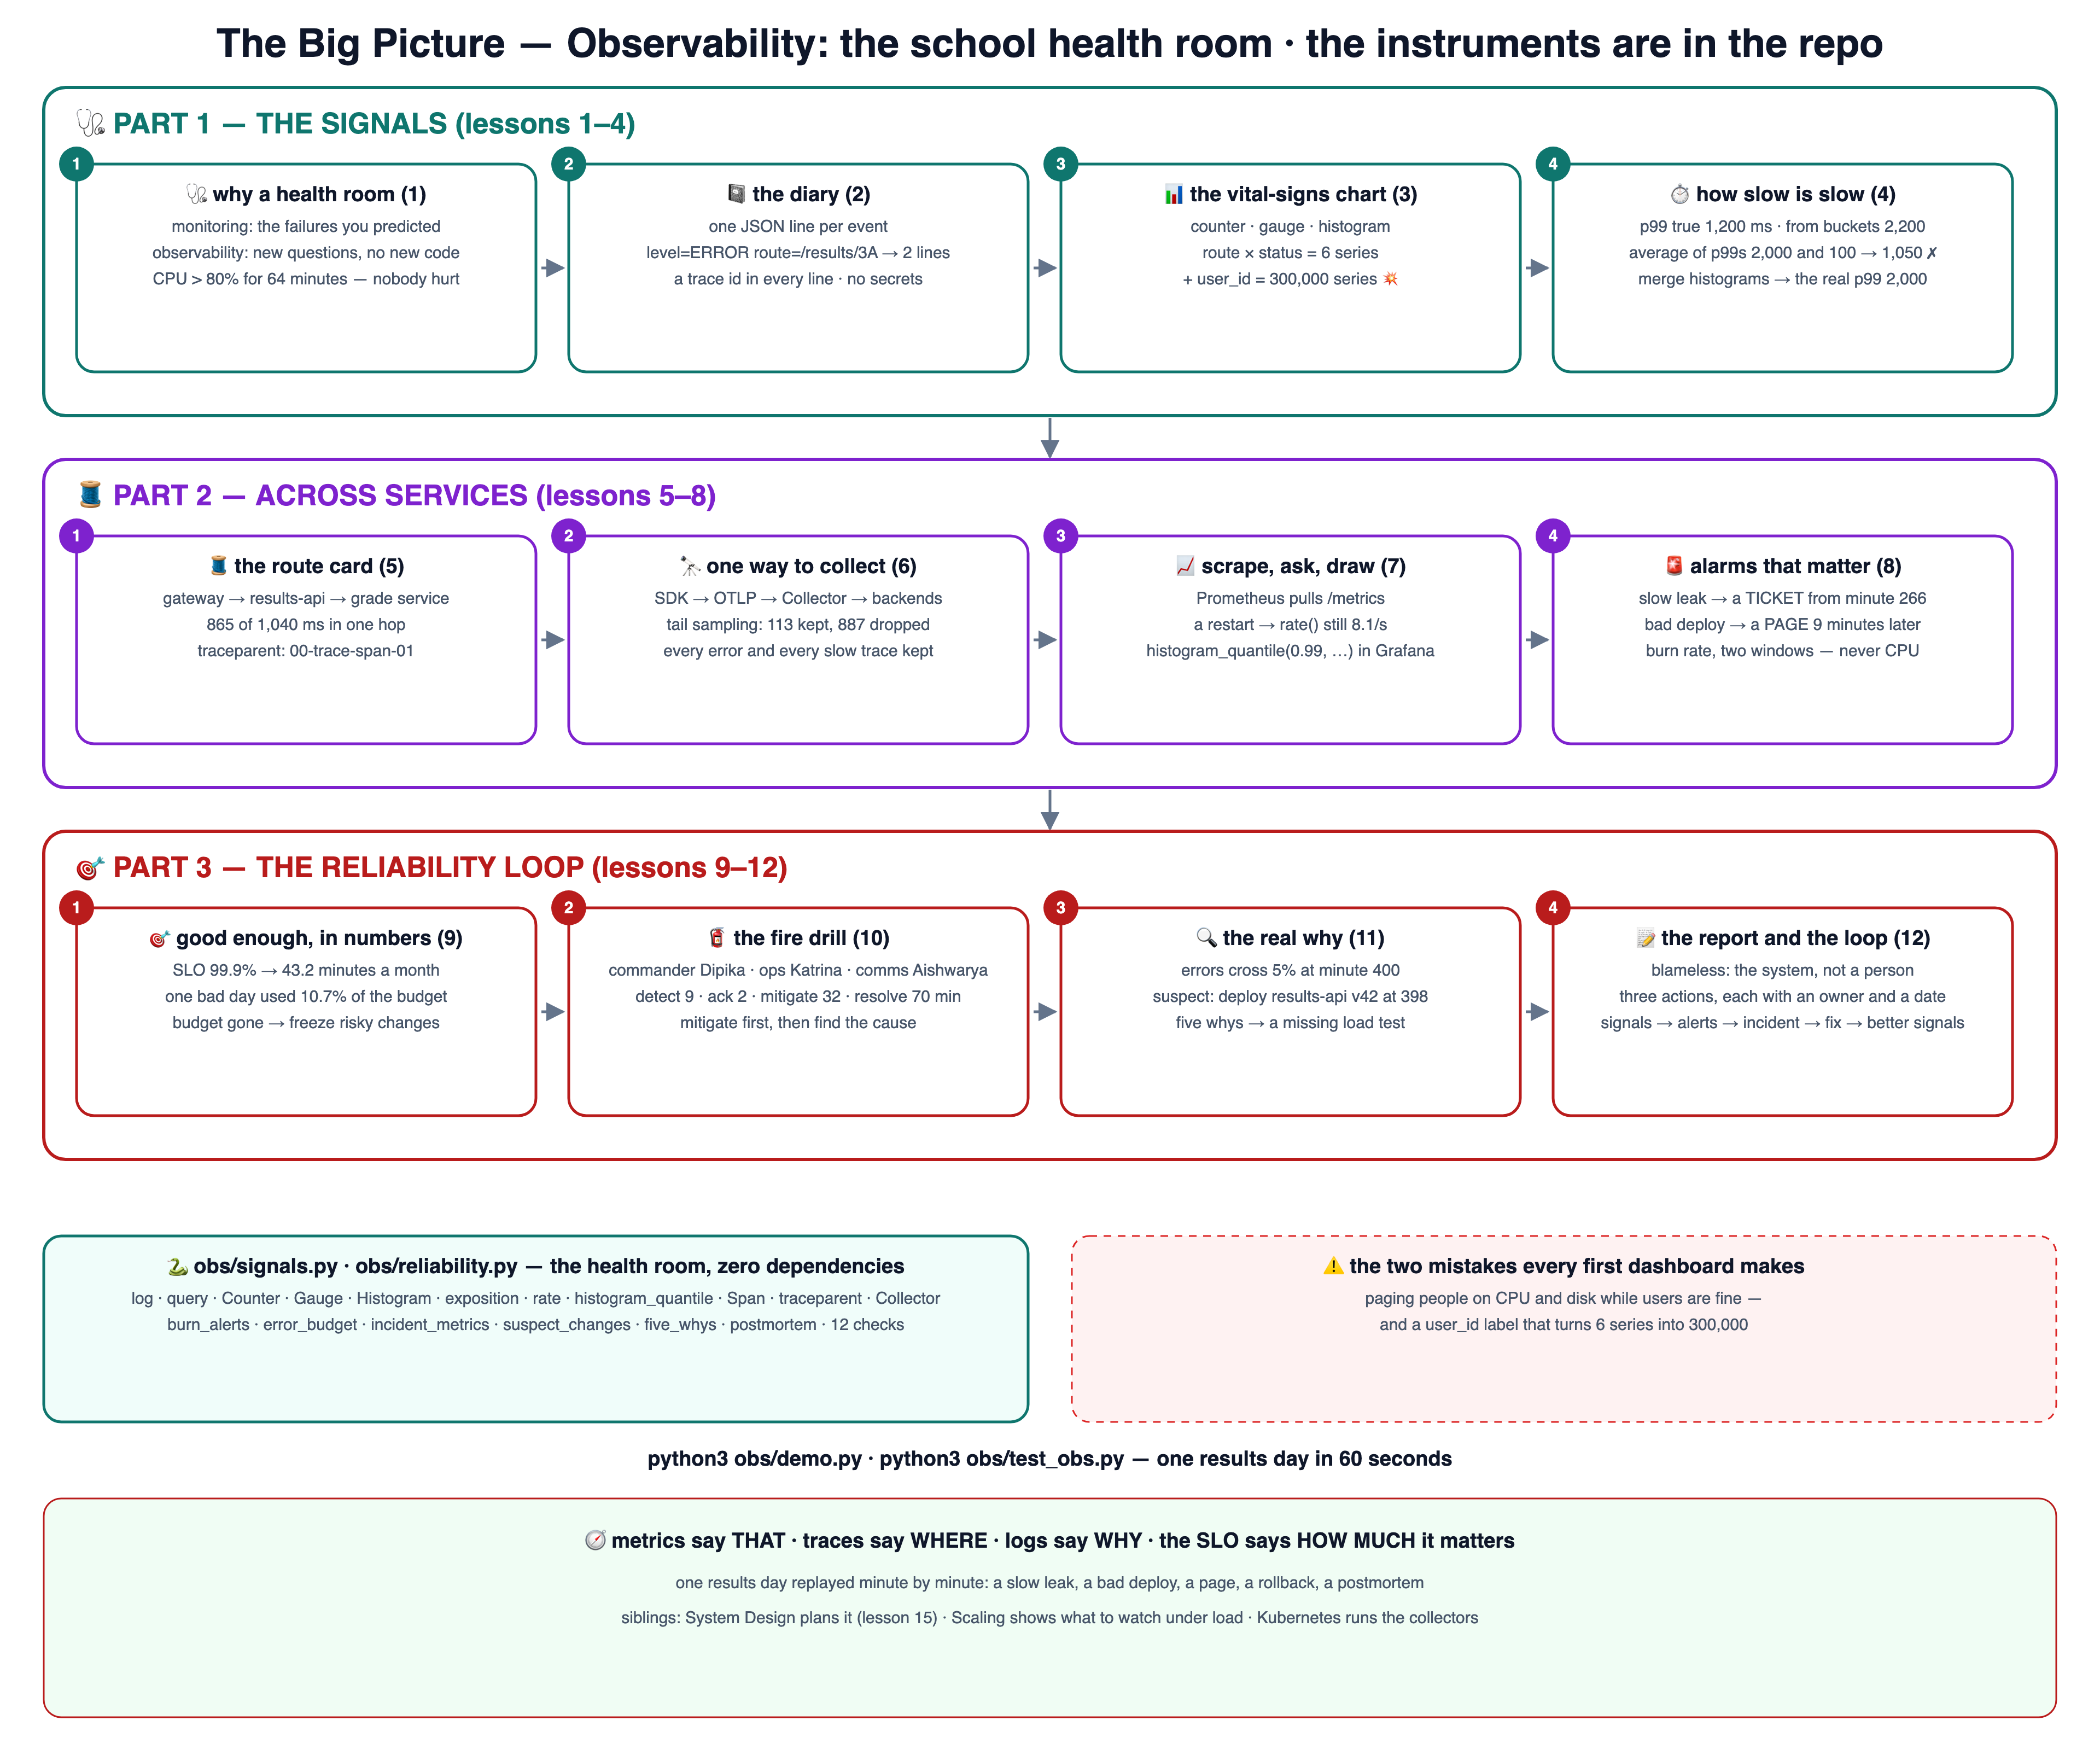
तुमची system काय करत आहे — आणि का — हे कसे ओळखायचे, शाळेच्या आरोग्य कक्षाप्रमाणे शिकवलेले: दैनंदिनी (logs), तपासणी तक्ता (metrics), एका विद्यार्थ्याचे मार्ग कार्ड (traces), खरोखर गरज असतानाच कुणाला उठवणारी धोक्याची घंटा, अग्निशमन सराव आणि त्यानंतरचा अहवाल. प्रत्येक धडा ही आकृती आणि lab असलेली एक शाळेची गोष्ट आहे — आणि आरोग्य कक्ष repo मध्येच आहे: शुद्ध Python मधील छोटे, प्रामाणिक models (obs/signals.py, obs/reliability.py, शून्य dependencies) जे एक निकालाचा दिवस मिनिटा-मिनिटाने पुन्हा चालवतात.
# the 60-second wow — one results day, replayed:
git clone https://github.com/BaluRaut/learn-observability-school.git && cd learn-observability-school
python3 obs/demo.py                # 12 lessons: every signal, alert and minute
python3 obs/test_obs.py            # 12 checks across the lessons
तुम्हाला काय दिसायला हवे (छाटलेले — यश असे दिसते):
═══ why ═══
── results day, 11:40: 'parents say the results page is broken' — can we answer WHY without adding code?
   monitoring: dashboards for failures you predicted (CPU, disk, 5xx)
   observability: ask NEW questions of the system from what it already emits — logs, metrics, traces
   this morning: CPU crossed 80% in 64 minutes — but CPU is not what parents feel
   the three signals: metrics say THAT something is wrong · traces say WHERE · logs say WHY

═══ logs ═══
── structured logs: one JSON object per line, not free text
   {"ts": "11:40:02", "level": "ERROR", "msg": "grade service timeout", "route": "/results/3A", "status": 504, "ms": 1000, "trace_id": "a3ce929d", "user": "parent-9"}
── query level=ERROR route=/results/3A → 2 lines · trace ids ['a3ce929d', 'b7ad6b71']
   levels: DEBUG < INFO < WARN < ERROR · never log passwords, tokens or full personal data
   a request id / trace id in EVERY line is what joins logs to traces

═══ metrics ═══
── three kinds of metric — counter (only up), gauge (up and down), histogram (buckets)
   # HELP http_requests_total Requests served
   # TYPE http_requests_total counter
   http_requests_total{route="/results",status="200"} 9450
   http_requests_total{route="/results",status="404"} 30
   http_requests_total{route="/results",status="500"} 20
   # HELP print_queue_length Certificates waiting
   # TYPE print_queue_length gauge
   print_queue_length 137
   # HELP http_request_duration_seconds Request time
   # TYPE http_request_duration_seconds histogram
   http_request_duration_seconds_bucket{le="0.1"} 10
   http_request_duration_seconds_bucket{le="0.25"} 18
   http_request_duration_seconds_bucket{le="0.5"} 19
   http_request_duration_seconds_bucket{le="1.0"} 19
   http_request_duration_seconds_bucket{le="2.5"} 20
   http_request_duration_seconds_bucket{le="+Inf"} 20
   http_request_duration_seconds_sum 3.657
   http_request_duration_seconds_count 20
── labels route, status → 6 time series
── labels route, status, user_id → 300,000 time series
   never put user ids, emails or full URLs in labels — cardinality explodes the bill and the database

═══ percentiles ═══
── 20 requests (ms): 80 85 90 92 95 98 100 105 110 120 130 150 180 240 400 95 88 102 97 1200
   p50  true   100 ms · from buckets   100.0 ms
   p95  true   400 ms · from buckets   500.0 ms
   p99  true  1200 ms · from buckets  2200.0 ms
── two servers' p99: 2000 and 100 ms · their average 1050 ms · the real p99 of both: 2000 ms
   you cannot average percentiles — merge the histograms and compute again · buckets set the precision

═══ tracing ═══
── one parent's request, as a trace (one tree of spans):
   GET /results/3A [gateway] 0–1040 ms (1040 ms) ✗
     check parent login [auth] 5–45 ms (40 ms)
     load class list [results-api] 50–90 ms (40 ms)
     fetch grades [results-api] 95–1035 ms (940 ms) ✗
       SELECT grades [postgres] 100–160 ms (60 ms)
       grade service call [grade-service] 165–1030 ms (865 ms) ✗
   critical path: GET /results/3A → fetch grades → grade service call — 865 of 1040 ms is the grade service
   passed between services in a header: traceparent: 00-a3ce929d0e0e47364bf92f3577b34da6-00f067aa0ba902b7-01

═══ otel ═══
── OpenTelemetry: one SDK in the app → the Collector → any backend (Tempo, Jaeger, X-Ray, Datadog…)
   app (SDK: traces, metrics, logs) → OTLP → collector (receive → batch → sample → export) → backends
── 1,000 traces, tail sampling (keep every error and every trace > 500 ms, 1 in 10 of the rest) → kept 113, dropped 887
   all 4 error traces and all 10 slow traces survive — the boring ones are sampled
   semantic conventions: http.request.method, http.response.status_code, service.name — the same names everywhere

═══ prometheus ═══
── a counter scraped every 60 s: [(0, 1000), (60, 1600), (120, 2200), (180, 150), (240, 750)] — the app restarted at 180 s
   rate over 4 min = 8.1 requests/s (the reset is handled, not a negative spike)
── PromQL you will type every week:
   sum by (status) (rate(http_requests_total[5m]))
   sum(rate(http_requests_total{status=~"5.."}[5m])) / sum(rate(http_requests_total[5m]))
   histogram_quantile(0.99, sum by (le) (rate(http_request_duration_seconds_bucket[5m])))
   Prometheus PULLS /metrics every 15–60 s and stores series · Grafana draws them · recording rules pre-compute

═══ alerting ═══
── 8 hours of traffic, SLO 99.9%: a slow leak (0.9% errors, minutes 100–379) and a bad deploy (6%, minutes 400–431)
   CPU > 80% alerts: 64 minutes of noise that do not track what users feel
   burn-rate TICKET (≥6× over 6 h AND 30 min): minutes 266–390, 401–408, 435–458 — first the slow leak (nobody woken at night), then around the deploy while the page is not firing
   burn-rate PAGE (≥14.4× over 1 h AND 5 min): minutes 409–434 — the bad deploy, 9 minutes after it began
   page for fast burns that hurt users now; open a ticket for slow burns; never page on a cause like CPU

═══ slo ═══
── SLI: good requests / all requests · SLO: 99.9% over 30 days · SLA: the contract with a penalty
   SLO 99.00% →  432.0 minutes of full outage per 30 days
   SLO 99.90% →   43.2 minutes of full outage per 30 days
   SLO 99.99% →    4.3 minutes of full outage per 30 days
── a 30-day window of 43,200,000 requests may have 43,200 failures · today's 8 hours failed 4,608
   one bad day used 10.7% of the month's budget → 89.3% left
   budget left → ship faster · budget gone → freeze risky changes and fix reliability first

═══ incident ═══
── roles: incident commander (Dipika) · ops lead (Katrina) · communications (Aishwarya) · scribe
   SEV1: most parents cannot see results — page everyone, status page, updates every 30 min
   SEV2: a feature is broken for many — page on-call, updates every hour
   SEV3: degraded or a small group affected — fix in working hours
── the timeline (minutes): {'started': 400, 'detected': 409, 'acknowledged': 411, 'mitigated': 432, 'resolved': 470}
   time_to_detect       9 min
   time_to_acknowledge  2 min
   time_to_mitigate     32 min
   time_to_resolve      70 min
   users_hurt_minutes   32 min
   first mitigate (roll back, switch off, add capacity), THEN find the cause

═══ rootcause ═══
── the error ratio first crosses 5% at minute 400
   changes in the 30 minutes before: [(398, 'deploy results-api v42')]
   why 1? parents saw 504 on /results
   why 2? the grade service call took 1 s and timed out
   why 3? v42 removed the grade cache, so every view hit the grade service
   why 4? the load test used 3 classes, not 900
   why 5? there is no production-like load test in the release checklist
   the root cause is usually a missing guard in the PROCESS, not a person

═══ postmortem ═══
   # Postmortem: results page 504s on results day

   Blameless: we look at the system, not at a person.

   ## Impact
   6% of results views failed for 32 minutes (minutes 400–431); ~1,900 parents saw an error

   ## Timeline
   - 398 deploy v42
   - 409 burn-rate page fired
   - 411 Dipika acknowledged, took command
   - 432 rollback to v41 — errors back to normal
   - 470 resolved; grade cache restored

   ## Root cause
   v42 removed the grade cache; the release load test did not match results-day traffic

   ## Action items
   - [Katrina] restore the grade cache with a test that fails without it (by 2 days)
   - [Aishwarya] results-day load test in the release checklist (by 1 week)
   - [Dipika] canary 5% for 15 min with burn-rate auto-rollback (by 2 weeks)
── the loop: signals → alerts on the SLO → incident → root cause → postmortem → action items → better signals

✅ done — the health room is watching
🎒 धडा 01 आधी: तुम्हाला फक्त Python 3 हवे — दुसरे काही नाही. Lab म्हणजे एक निकालाचा दिवस पुन्हा चालवणाऱ्या शिकवणीसाठीच्या models चा संच आहे; खरी साधने म्हणजे Prometheus, Grafana, OpenTelemetry, CloudWatch, Datadog — कल्पना आणि गणित तेच आहे. चांगले शेजारी: Scaling (load खाली तुम्ही काय पाहता), System Design (धडा 15 त्याचे नियोजन करतो) आणि Kubernetes.
एक git branch = एक कल्पना; branch 04 मध्ये धडे 01–04 आहेत. प्रत्येक आकडा obs/ मधून येतो — cloud account लागत नाही.
1
🩺 Observability का
शाळेचा आरोग्य कक्ष — monitoring तुम्ही आधी अंदाज केलेले पाहते; observability तुम्हाला system आधीच जे सांगते त्याबद्दल नवे प्रश्न विचारू देते.lesson-01-why-observabilityधडा वाचा →आकृती पहा ↗
2
📓 Logs
दैनंदिनी — structured JSON lines, levels, प्रत्येक ओळीत एक trace id, आणि काय कधीच लिहू नये.lesson-02-logsधडा वाचा →आकृती पहा ↗
3
📊 Metrics
तपासणी तक्ता — counters, gauges, histograms, labels, आणि cardinality चा सापळा.lesson-03-metricsधडा वाचा →आकृती पहा ↗
4
⏱️ Percentiles आणि histograms
हळू म्हणजे किती हळू — buckets मधून p50, p95, p99, आणि percentiles ची सरासरी कधीच का काढता येत नाही.lesson-04-percentilesधडा वाचा →आकृती पहा ↗
🧵 भाग 2 — services च्या पलीकडे (धडे 5–8)
एका request चा अनेक services मधून पाठलाग करा, सगळे एकाच पद्धतीने गोळा करा, आणि users ना जे जाणवते त्यावर alert करा.
5
🧵 Distributed tracing
एका विद्यार्थ्याचे प्रत्येक खोलीतून जाणारे मार्ग कार्ड — spans, critical path आणि traceparent header.lesson-05-tracingधडा वाचा →आकृती पहा ↗
6
🔭 OpenTelemetry
सगळे गोळा करण्याचा एकच मार्ग — SDK, OTLP, Collector, tail sampling आणि सामायिक नावे.lesson-06-opentelemetryधडा वाचा →आकृती पहा ↗
7
📈 Prometheus आणि Grafana
Scrape करा, साठवा, विचारा, काढा — /metrics, rate(), PromQL, histogram_quantile आणि dashboards.lesson-07-prometheus-grafanaधडा वाचा →आकृती पहा ↗
8
🚨 Alerting
Users ना त्रास होत असेल तेव्हाच कुणाला उठवा — कारणे नव्हे तर लक्षणे, आणि multi-window burn-rate alerts.lesson-08-alertingधडा वाचा →आकृती पहा ↗
🎯 भाग 3 — विश्वासार्हतेचे चक्र (धडे 9–12)
Signals चे निर्णयात रूपांतर करा: budgets, incidents, मूळ कारणे आणि टिकणारे उपाय.
9
🎯 SLIs, SLOs आणि error budgets
पुरेसे चांगले म्हणजे काय ते ठरवा — SLI, SLO, SLA, आणि कधी गती कमी करायची ते सांगणारे budget.lesson-09-slosधडा वाचा →आकृती पहा ↗
10
🧯 Incident response
अग्निशमन सराव — severity, भूमिका, संवाद, आधी mitigate करा, आणि चार घड्याळे: detect, acknowledge, mitigate, resolve.lesson-10-incident-responseधडा वाचा →आकृती पहा ↗
11
🔍 Root-cause analysis
हे खरोखर का घडले — बदलांशी जुळवून पाहा, पाच का, आणि प्रक्रियेतील हरवलेले संरक्षण.lesson-11-root-causeधडा वाचा →आकृती पहा ↗
12
📝 Postmortems आणि चक्र
मालक आणि तारखांसह दोषारोपविरहित अहवाल — आणि signals पासून अधिक चांगल्या signals पर्यंतचे चक्र.lesson-12-postmortemsधडा वाचा →आकृती पहा ↗
🗣️ हे मोठ्याने समजावून सांगा — धडा 12 नंतर: (1) logs, metrics आणि traces पैकी प्रत्येक कशाचे उत्तर देतो? (2) user_id label धोकादायक का आहे? (3) दोन servers चे p99 100 ms आणि 2,000 ms आहेत — 1,050 ms चूक का आहे? (4) traceparent header काय घेऊन जातो? (5) CPU ऐवजी burn rate वर alert का करायचे? (6) 99.9% SLO महिन्याला किती मिनिटे देतो? (7) incident मध्ये तुम्ही कोणती चार घड्याळे मोजता? (8) postmortem दोषारोपविरहित का असतो?
प्रत्येक धडा एका क्रमांकित बॉक्स-आणि-बाण आकृतीत — स्वतंत्र पानावरही.
1 🩺 Observability का
शाळेचा आरोग्य कक्ष — monitoring तुम्ही आधी अंदाज केलेले पाहते; observability तुम्हाला system आधीच जे सांगते त्याबद्दल नवे प्रश्न विचारू देते.
🧒 सोप्या शब्दांत
विद्यार्थी आजारी वाटला तर शाळेचा आरोग्य कक्ष अंदाज लावत नाही. तो तक्ता तपासतो, दैनंदिनी वाचतो आणि विद्यार्थी कुठे कुठे गेला ते विचारतो. निकालाच्या दिवशी page तुटले. CPU ची घंटा 64 मिनिटे वाजली, पण पालकांना CPU कधीच जाणवत नाही. चांगल्या signals मुळे Dipika नवे प्रश्न विचारू शकते आणि खरे कारण शोधू शकते.
📖 नवे शब्दmonitoring — आधी ओळखलेल्या failures साठी dashboards, जसे CPU, disk किंवा 5xxobservability — system आधीच जे सांगते त्यातून नवे प्रश्न विचारणेsignal — system कडून मिळणारी खूण: log ओळ, metric किंवा tracethree signals — metrics सांगतात काहीतरी झाले, traces सांगतात कुठे, logs सांगतात का
⏪ आधी
Dashboards फक्त आधी ओळखलेल्या failures पाहत, त्यामुळे CPU ची घंटा 64 मिनिटे वाजली आणि पालकांना मात्र तुटलेले page दिसले.
💡 काय
Observability म्हणजे शाळेचा आरोग्य कक्ष: system आधीच देत असलेल्या signals मधून, कधी न ठरवलेले प्रश्नही विचारता येतात.
⚙️ कसे
तीन signals एकत्र काम करतात: metrics सांगतात काहीतरी चुकले आहे, traces सांगतात कुठे, आणि logs सांगतात का.
🎯 का
निकालाच्या दिवशी 11:40 ला नवा code न जोडता आणि पुन्हा बिघडण्याची वाट न पाहता, results page का तुटले ते शोधता येते.
🚀 पुढे
पुढचा धडा दैनंदिनी उघडतो: structured JSON logs, levels, आणि प्रत्येक ओळीत एक trace id.
🧪 इथे करून पाहा — CPU धोक्याची रेषा 480 मिनिटांच्या निकालाच्या दिवसावर हलवा — आणि ती पालकांबद्दल काही सांगते का ते पाहा
दैनंदिनी — structured JSON lines, levels, प्रत्येक ओळीत एक trace id, आणि काय कधीच लिहू नये.
🧒 सोप्या शब्दांत
आरोग्य कक्ष एक दैनंदिनी ठेवतो. प्रत्येक ओळीत वेळ, किती गंभीर, काय झाले आणि कोणता विद्यार्थी हे असते. Katrina ती प्रत्येक वेळी त्याच नीटनेटक्या पद्धतीने लिहिते, म्हणजे नंतर शोधता येते. ती वर्ग 3A च्या फक्त ERROR ओळी मागते आणि नेमक्या 2 मिळतात. प्रत्येक ओळीत पूर्ण मार्गाकडे नेणारा trace id असतो.
📖 नवे शब्दstructured log — प्रत्येक ओळीत एक JSON object, मोकळ्या मजकुराऐवजी नावे असलेली fieldslevel — ओळ किती गंभीर आहे: DEBUG < INFO < WARN < ERRORtrace id — प्रत्येक ओळीतला सामायिक id जो दैनंदिनीला मार्ग कार्डाशी जोडतोnever log — passwords, tokens किंवा पूर्ण वैयक्तिक माहिती दैनंदिनीत कधीच लिहू नये
⏪ आधी
प्रत्येक server एका मोठ्या file मध्ये मोकळ्या मजकुराच्या ओळी लिहायचा, आणि outage मध्ये लोक grep ने वाचून अंदाज लावत.
💡 काय
Logs म्हणजे आरोग्य कक्षाची दैनंदिनी: प्रत्येक ओळीत एक JSON object, त्यात वेळ, level, message, route, status आणि trace id.
⚙️ कसे
level=ERROR route=/results/3A ही query नेमक्या 2 ओळी देते, आणि त्यांचे trace ids थेट हळू requests पर्यंत नेतात.
🎯 का
Structured ओळी filter करता येतात आणि मोजता येतात, आणि प्रत्येक ओळीतला trace id दैनंदिनीला मार्ग कार्डाशी जोडतो.
🚀 पुढे
पुढचा धडा तपासणी तक्ता काढतो: counters, gauges, histograms, labels आणि cardinality चा सापळा.
🧪 इथे करून पाहा — field नुसार दैनंदिनीत query करा — मग त्यात तुमची स्वतःची ओळ लिहा
तपासणी तक्ता — counters, gauges, histograms, labels, आणि cardinality चा सापळा.
🧒 सोप्या शब्दांत
तपासणी तक्त्यात गोष्टी नसतात, आकडे असतात. एक मोजणी फक्त वाढते, जसे आज तपासलेले विद्यार्थी. एक वर-खाली होते, जसे आत्ता थांबलेले विद्यार्थी. एक भेटी किती वेळ लागला त्यानुसार वाटते. Labels तक्ता route आणि status नुसार विभागतात: 6 ओळी. प्रत्येक विद्यार्थ्याचे नाव जोडले तर 300,000 ओळी. खूपच जास्त!
📖 नवे शब्दcounter — फक्त वाढणारा आकडा, जसे हाताळलेल्या requestsgauge — वर-खाली होणारा आकडा, जसे 137 वरची print queuehistogram — buckets मध्ये वाटलेल्या किंमतींची मोजणी, जसे le=0.1, 0.25, 0.5cardinality — labels किती time series बनवतात: 6 ठीक, 300,000 म्हणजे मोठे bill
⏪ आधी
Teams logs शोधून गोष्टी मोजत, जे हळू आणि महाग होते, किंवा user_id label जोडून 300,000 series मिळवत.
💡 काय
Metrics म्हणजे तपासणी तक्ता: counters फक्त वाढतात, gauges वर-खाली होतात, histograms किंमती buckets मध्ये वाटतात.
⚙️ कसे
route आणि status labels सह http_requests_total मधून 6 time series बनतात; user_id जोडला तर 300,000 बनतात.
🎯 का
आकडे साठवायला स्वस्त आणि query साठी जलद असतात, म्हणून alerts आणि trends साठी उत्तम, जर labels कमी ठेवले तर.
🚀 पुढे
पुढचा धडा विचारतो हळू म्हणजे किती हळू: buckets मधून p50, p95 आणि p99, आणि percentiles ची सरासरी का खोटी ठरते.
🧪 इथे करून पाहा — requests मोजा, gauge हलवा, requests ची वेळ buckets मध्ये टाका — /metrics मजकूर बदलतो; मग labels चा गुणाकार करा
हळू म्हणजे किती हळू — buckets मधून p50, p95, p99, आणि percentiles ची सरासरी कधीच का काढता येत नाही.
🧒 सोप्या शब्दांत
बहुतेक विद्यार्थी आरोग्य कक्षातून सुमारे 100 ms मध्ये निघतात, पण एक 1200 ms थांबतो. सरासरी त्याला लपवते, म्हणून Aishwarya हळू टोक पाहते: p99. तिचे buckets रुंद आहेत, म्हणून ते 2200 ms सांगतात. आणि p99 2000 आणि 100 असलेल्या दोन खोल्यांची सरासरी 1050 होत नाही. खरा p99 2000 आहे. आधी मोजण्या एकत्र करा, मग काढा.
📖 नवे शब्दp50 — मधली वेळ: अर्ध्या भेटी यापेक्षा जलद होत्या, इथे 100 msp99 — हळू टोक: 100 पैकी फक्त 1 भेट यापेक्षा हळू, इथे 1200 msbucket — histogram मधली एक श्रेणी; percentile ची precision buckets ठरवतातaveraging percentiles — नेहमी चूक: खऱ्या 2000 ms ऐवजी 1050 ms
⏪ आधी
Teams दोन servers चे p99, 2000 आणि 100 ms, यांची सरासरी 1050 ms सांगत, पण दोघांचा खरा p99 2000 ms होता.
💡 काय
Percentiles सांगतात हळू म्हणजे किती हळू: p99 म्हणजे अशी वेळ ज्यापेक्षा 100 पैकी फक्त 1 भेट हळू असते, रांगेचे हळू टोक.
⚙️ कसे
20 requests मधून खरा p99 1200 ms आहे, पण buckets 2200 ms सांगतात, कारण precision buckets ठरवतात.
🎯 का
Percentiles ची सरासरी काढता येत नाही; histograms एकत्र करून पुन्हा मोजा, आणि महत्त्वाच्या वेळांजवळ buckets ठेवा.
🚀 पुढे
पुढचा धडा एका request मागे प्रत्येक खोलीत जातो: spans, critical path आणि traceparent header.
🧪 इथे करून पाहा — latencies आणि bucket च्या कडा बदला — खरे percentiles विरुद्ध bucket चा अंदाज; मग दोन servers एकत्र करा
एका विद्यार्थ्याचे प्रत्येक खोलीतून जाणारे मार्ग कार्ड — spans, critical path आणि traceparent header.
🧒 सोप्या शब्दांत
विद्यार्थिनी एका खोलीतून दुसऱ्या खोलीत मार्ग कार्ड घेऊन जाते. प्रत्येक खोली ती कधी आली आणि कधी गेली ते लिहिते. एका पालकाच्या request च्या कार्डावर एकूण 1040 ms दिसतात, आणि त्यातले 865 ms grade service मध्ये गेले. आता कोणी अंदाज लावत नाही. कार्डाचा नंबर header मधून पुढे जातो, म्हणून प्रत्येक खोली त्याच कार्डावर लिहिते.
📖 नवे शब्दtrace — संपूर्ण मार्ग कार्ड: spans चे झाड म्हणून एक requestspan — कार्डावरची एका खोलीची नोंद: service, सुरुवात आणि कालावधीcritical path — एकूण वेळ ठरवणारी spans ची साखळी; इथे grade servicetraceparent — एका service कडून पुढच्या service कडे trace id नेणारा header
⏪ आधी
प्रत्येक service चे स्वतःचे logs होते, त्यामुळे 5 टप्प्यांपैकी कोणत्या टप्प्याने एका पालकाला 1040 ms थांबवले ते कोणालाच दिसत नव्हते.
💡 काय
Trace म्हणजे प्रत्येक खोलीतून जाणारे विद्यार्थ्याचे मार्ग कार्ड: spans चे झाड, प्रत्येकात service, सुरुवात आणि कालावधी.
⚙️ कसे
Trace id traceparent header मधून पुढे जातो; critical path दाखवतो की 1040 पैकी 865 ms grade service call घेतो.
🎯 का
अंदाज न लावता तुम्ही तो एक हळू टप्पा दुरुस्त करता, आणि तोच trace id मार्ग कार्डाला दैनंदिनीच्या ओळींशी जोडतो.
🚀 पुढे
पुढचा धडा सगळे एकाच पद्धतीने गोळा करतो: OpenTelemetry SDK, OTLP, Collector आणि tail sampling.
🧪 इथे करून पाहा — span कधी संपतो ते बदला — waterfall, tree आणि critical path त्यामागे येतात; मग एक traceparent बनवा
सगळे गोळा करण्याचा एकच मार्ग — SDK, OTLP, Collector, tail sampling आणि सामायिक नावे.
🧒 सोप्या शब्दांत
आधी प्रत्येक खोली स्वतःच्या प्रकारचा form भरायची. आता एकच form आणि एकच संकलन पेटी आहे. पेटी error असलेले प्रत्येक कार्ड आणि प्रत्येक हळू कार्ड ठेवते, आणि कंटाळवाण्यांपैकी फक्त 10 मधले 1. 1,000 कार्डांपैकी तिने 113 ठेवली आणि 887 टाकली, पण एकही error हरवला नाही.
📖 नवे शब्दOpenTelemetry — कोणत्याही भाषेत traces, metrics आणि logs साठी एक open standard SDKOTLP — SDK Collector ला signals पाठवण्यासाठी वापरतो तो protocolCollector — signals घेतो, batch करतो, sample करतो आणि कोणत्याही backend ला export करतोtail sampling — trace संपल्यावर ठरवणे: errors आणि हळू ठेवा, बाकीचे sample करा
⏪ आधी
प्रत्येक backend चा स्वतःचा agent आणि स्वतःची field names होती, आणि प्रत्येक trace ठेवल्याने bill traffic पेक्षा जलद वाढले.
💡 काय
OpenTelemetry म्हणजे गोळा करण्याची एकच पद्धत: app मधला एक SDK OTLP ने Collector ला पाठवतो, जो कोणत्याही backend ला export करतो.
⚙️ कसे
1,000 traces वर tail sampling प्रत्येक error, 500 ms वरचा प्रत्येक trace आणि बाकीचे 10 पैकी 1 ठेवते: 113 ठेवले, 887 टाकले.
🎯 का
सगळे 4 error traces आणि सगळे 10 हळू traces टिकतात, सामायिक names सगळीकडे जुळतात, आणि backend मोकळेपणाने बदलता येतो.
🚀 पुढे
पुढचा धडा scrape, store, query आणि चित्र: /metrics, rate(), PromQL, histogram_quantile आणि Grafana.
🧪 इथे करून पाहा — धड्यातील 1,000 traces चे tail-sample करा — नियम बदला, head sampling शी तुलना करा
दर मिनिटाला एक मदतनीस प्रत्येक खोलीत जाऊन तिचे counters मोठ्या तक्त्यावर उतरवतो. त्याला scrape म्हणतात. एकदा एक खोली restart झाली आणि तिची मोजणी 150 वर आली, पण तक्त्याला reset आणि crash मधला फरक कळतो: rate सेकंदाला 8.1 च राहतो. मग Katrina एक छोटा प्रश्न टाइप करते आणि भिंतीवरचा screen उत्तर काढतो.
📖 नवे शब्दscrape — Prometheus दर 15 ते 60 s ला प्रत्येक target कडून /metrics ओढतोrate() — एका window मध्ये counter ची दर सेकंदाची वाढ; restarts सांभाळतोPromQL — query भाषा, जसे sum by (status) (rate(http_requests_total[5m]))Grafana — Prometheus series ना dashboards म्हणून काढणारा भिंतीवरचा screen
⏪ आधी
प्रत्येक server स्वतःचे graphs काढायचा, कोणालाच तुलना करता येत नव्हती, आणि restart नंतर counter reset crash सारखा दिसायचा.
💡 काय
Prometheus दर 15 ते 60 s ला /metrics ओढतो आणि series साठवतो; Grafana ते आरोग्य कक्षाच्या भिंतीवर काढतो.
⚙️ कसे
दर 60 s ला scrape केलेला counter 4 मिनिटांत 8.1 requests/s चा rate() देतो, जरी app 180 s ला restart झाले तरी.
🎯 का
rate() resets सांभाळतो, PromQL एका ओळीत नवे प्रश्न सोडवते, आणि histogram_quantile सगळ्या servers चा p99 देतो.
🚀 पुढे
पुढचा धडा वापरकर्त्यांना त्रास होतो तेव्हाच धोक्याची घंटा वाजवतो: causes नव्हे symptoms, आणि multi-window burn-rate alerts.
🧪 इथे करून पाहा — दर 60 s ला scrape होणारा counter — samples बदला (घसरण म्हणजे restart) आणि rate() काय म्हणते ते पाहा
Users ना त्रास होत असेल तेव्हाच कुणाला उठवा — कारणे नव्हे तर लक्षणे, आणि multi-window burn-rate alerts.
🧒 सोप्या शब्दांत
जुनी घंटा CPU व्यस्त झाला की वाजायची: 64 मिनिटांचा गोंगाट, आणि एकाही पालकाला जाणवले नाही. नवी घंटा त्याऐवजी पालकांचे ऐकते. हळू गळतीसाठी सकाळी पाहायचे ticket उघडते. अनेक पालकांना त्रास देणारा वाईट deploy सुरू झाल्यावर 9 मिनिटांनी मोठी धोक्याची घंटा वाजवतो. कोणालाही विनाकारण उठवले जात नाही.
📖 नवे शब्दsymptom alert — वापरकर्त्यांना जाणवणाऱ्या गोष्टीवर वाजते, जसे errors, CPU सारख्या causes वर नाहीburn rate — परवानगी असलेल्या वेगाच्या तुलनेत error budget किती जलद खर्च होतोpage — आत्ता कोणाला तरी उठवा: 1 h आणि 5 min मध्ये 14.4× burnticket — कामाच्या वेळेत दुरुस्त करा: 6 h आणि 30 min मध्ये 6× burn
⏪ आधी
CPU > 80% alerts नी 8 तासांत 64 मिनिटांचा गोंगाट केला, आणि त्यातला एकही पालकांना जाणवलेल्या त्रासाबद्दल नव्हता.
💡 काय
धोक्याची घंटा वापरकर्त्यांना त्रास होत असतानाच वाजली पाहिजे: CPU सारख्या causes वर नव्हे, errors सारख्या symptoms वर alert.
⚙️ कसे
Slow leak साठी ticket minute 266 पासून येते; वाईट deploy नंतर 9 मिनिटांनी, minute 409 ला page येतो.
🎯 का
दोन windows मुळे alerts लवकर वाजतात आणि लवकर थांबतात, म्हणून fast burn कोणाला तरी उठवतो आणि slow burn सकाळपर्यंत थांबतो.
🚀 पुढे
पुढचा धडा आकड्यांत ठरवतो पुरेसे चांगले म्हणजे काय: SLI, SLO, SLA आणि error budget (चुकांची मुभा).
🧪 इथे करून पाहा — 480 मिनिटांचा निकालाचा दिवस — SLO, burn-rate मर्यादा, windows आणि दोन घटना बदलून पाहा
पुरेसे चांगले म्हणजे काय ते ठरवा — SLI, SLO, SLA, आणि कधी गती कमी करायची ते सांगणारे budget.
🧒 सोप्या शब्दांत
कोणताही आरोग्य कक्ष परिपूर्ण नसतो, म्हणून शाळा पुरेसे चांगले ठरवते: 30 दिवसांत 99.9% भेटी नीट व्हायला हव्यात. म्हणजे महिन्याला पूर्ण बंदीची 43.2 मिनिटे खर्च करायला उरतात. निकालाच्या दिवसाने त्यातला 10.7% खर्च केला. Budget उरला असेल तर शाळा नवे प्रयोग करू शकते. संपला की आधी थांबून दुरुस्ती करते.
📖 नवे शब्दSLI — मोजमाप: चांगल्या requests भागिले सगळ्या requestsSLO — ध्येय, जसे 30 दिवसांत 99.9%SLA — वचन मोडले तर दंड असलेला करारerror budget — चुकांची मुभा: 99.9% ला महिन्याला 43.2 मिनिटे
⏪ आधी
Teams 'पुरेसे विश्वसनीय' यावर भावनेने वाद घालत, आणि 100% चे ध्येय ठेवत, त्यामुळे प्रत्येक release भांडण ठरायचे.
💡 काय
SLO म्हणजे आकड्यांत पुरेसे चांगले: SLI म्हणजे चांगल्या भागिले सगळ्या requests, आणि error budget म्हणजे खर्च करता येणाऱ्या चुका.
⚙️ कसे
30 दिवसांसाठी 99.9% SLO पूर्ण बंदीची 43.2 मिनिटे देतो; एका वाईट दिवसाने budget चा 10.7% वापरला, 89.3% उरला.
🎯 का
Budget वादाचे नियमात रूपांतर करतो: budget उरला तर जलद ship करा, budget संपला तर धोकादायक बदल थांबवा.
🚀 पुढे
पुढचा धडा अग्निशमन सराव घेतो: severity, भूमिका, updates, आधी mitigate, आणि incident ची चार घड्याळे.
🧪 इथे करून पाहा — एक SLO निवडा — outage मिनिटे, requests मधील budget, आणि आज किती वापरले ते पाहा
अग्निशमन सराव — severity, भूमिका, संवाद, आधी mitigate करा, आणि चार घड्याळे: detect, acknowledge, mitigate, resolve.
🧒 सोप्या शब्दांत
आगीची घंटा वाजली की कोणी इकडे-तिकडे धावत नाही. Dipika नेतृत्व घेते, Katrina दुरुस्तीचे काम करते आणि Aishwarya पालकांना काय चालले आहे ते सांगते. आधी rollback करून त्रास थांबवतात, आणि मगच कारण शोधतात. घड्याळे सांगतात: 9 मिनिटांत सापडले, 2 मध्ये स्वीकारले, 32 मध्ये थांबवले, 70 मध्ये पूर्ण.
📖 नवे शब्दincident commander — नेतृत्व करणारी आणि निर्णय घेणारी एक व्यक्ती; इथे Dipikaseverity — SEV1 बहुतेक पालकांना त्रास, SEV2 एक feature बंद, SEV3 छोटा गटmitigate — आधी त्रास थांबवा: rollback, बंद करा किंवा capacity वाढवाfour clocks — detect 9, acknowledge 2, mitigate 32, resolve 70 मिनिटे
⏪ आधी
Page तुटल्यावर सगळे एकाच chat मध्ये उड्या मारत, कोणीच नेतृत्व करत नसे, आणि वापरकर्ते थांबलेले असताना लोक cause शोधत.
💡 काय
Incident response म्हणजे अग्निशमन सराव: severity, स्पष्ट भूमिका, नियमित updates, आणि आधी mitigate, मग cause शोधा.
हे खरोखर का घडले — बदलांशी जुळवून पाहा, पाच का, आणि प्रक्रियेतील हरवलेले संरक्षण.
🧒 सोप्या शब्दांत
Minute 400 ला errors उसळले. Katrina त्याच्या अगदी आधी काय बदलले ते पाहते: minute 398 ला एक deploy. मग ती पाच वेळा का विचारते. Errors का? एक हळू call. हळू का? Cache काढला. पकडले का नाही? Test ने 900 नव्हे 3 वर्ग वापरले. का? Checklist मध्ये खरी load test नाही. दुरुस्ती process मध्ये आहे.
📖 नवे शब्दcorrelate — errors कधी सुरू झाले ते अगदी आधीच्या बदलांशी जुळवणेsuspect deploy — errors च्या अगदी आधीचा बदल: minute 398 ला results-api v42five whys — दुरुस्त करता येईल अशा गोष्टीपर्यंत पोहोचेपर्यंत पुन्हा पुन्हा का विचारणेroot cause — बहुधा process मधले नसलेले संरक्षण, व्यक्ती नाही
⏪ आधी
Outages 'human error' या cause ने संपत, कोणाला तरी दोष दिला जायचा, आणि पुढच्या सत्रात तेच अपयश परत यायचे.
💡 काय
Root-cause analysis विचारते हे खरोखर का घडले: errors ना अलीकडच्या बदलांशी जुळवा, मग पाच वेळा का विचारा.
⚙️ कसे
Minute 400 ला errors 5% ओलांडतात; त्याआधीचा एकच बदल म्हणजे minute 398 चा संशयित deploy, results-api v42.
🎯 का
पाच का नसलेल्या संरक्षणापर्यंत पोहोचतात: release checklist मध्ये production सारखी load test नाही, दोष process चा, व्यक्तीचा नाही.
🚀 पुढे
पुढचा धडा अहवाल लिहितो: owners आणि dates सह blameless postmortem, आणि signals कडे परत जाणारे चक्र.
🧪 इथे करून पाहा — पहिले वाईट मिनिट आणि संशयित बदल शोधा — मग पाच का चढा
मालक आणि तारखांसह दोषारोपविरहित अहवाल — आणि signals पासून अधिक चांगल्या signals पर्यंतचे चक्र.
🧒 सोप्या शब्दांत
सरावानंतर आरोग्य कक्ष अहवाल लिहितो. तो कोणालाही दोष देत नाही. काय बिघडले, किती वेळ आणि का ते सांगतो. मग तीन कामे लिहितो, प्रत्येकाला नाव आणि तारीख: Katrina cache परत आणते, Aishwarya खरी load test जोडते, Dipika छोटा आणि सावध rollout जोडते. पुढच्या निकालाच्या दिवशी signals अधिक चांगले असतात.
📖 नवे शब्दpostmortem — incident नंतरचा लेखी अहवाल: impact, timeline, cause, actionsblameless — बटण दाबणाऱ्या व्यक्तीकडे नव्हे, system कडे पाहणेaction item — एक owner आणि date असलेली दुरुस्ती, product work सारखी track केलेलीthe loop — signals → alerts → incident → root cause → अहवाल → अधिक चांगले signals
⏪ आधी
Outage नंतर लोक पुढे जात, fixes ना owner किंवा date नसे, आणि निकालाच्या दिवशीचे तेच अपयश पुढच्या वर्षी परत यायचे.
💡 काय
Postmortem म्हणजे आरोग्य कक्षाचा अहवाल: blameless, तो system कडे पाहतो, आणि प्रत्येक action item ला owner आणि date असते.
⚙️ कसे
अहवालात impact, timeline आणि root cause असतात, मग Katrina, Aishwarya आणि Dipika यांच्या नावाचे तीन action items.
🎯 का
चक्र असे चालते: signals, alerts, incident, root cause, अहवाल, fixes आणि अधिक चांगले signals, म्हणून प्रत्येक outage तुम्हाला मजबूत करते.
🚀 पुढे
पुढे कुठे: System Design school प्रत्येक box मध्ये signals ठरवते, Scaling काय पाहायचे ते दाखवते, Kubernetes ते चालवते.
🧪 इथे करून पाहा — postmortem लिहा — builder तपासतो की तो दोषारोपविरहित आहे आणि प्रत्येक कृतीला जबाबदार व्यक्ती व तारीख आहे