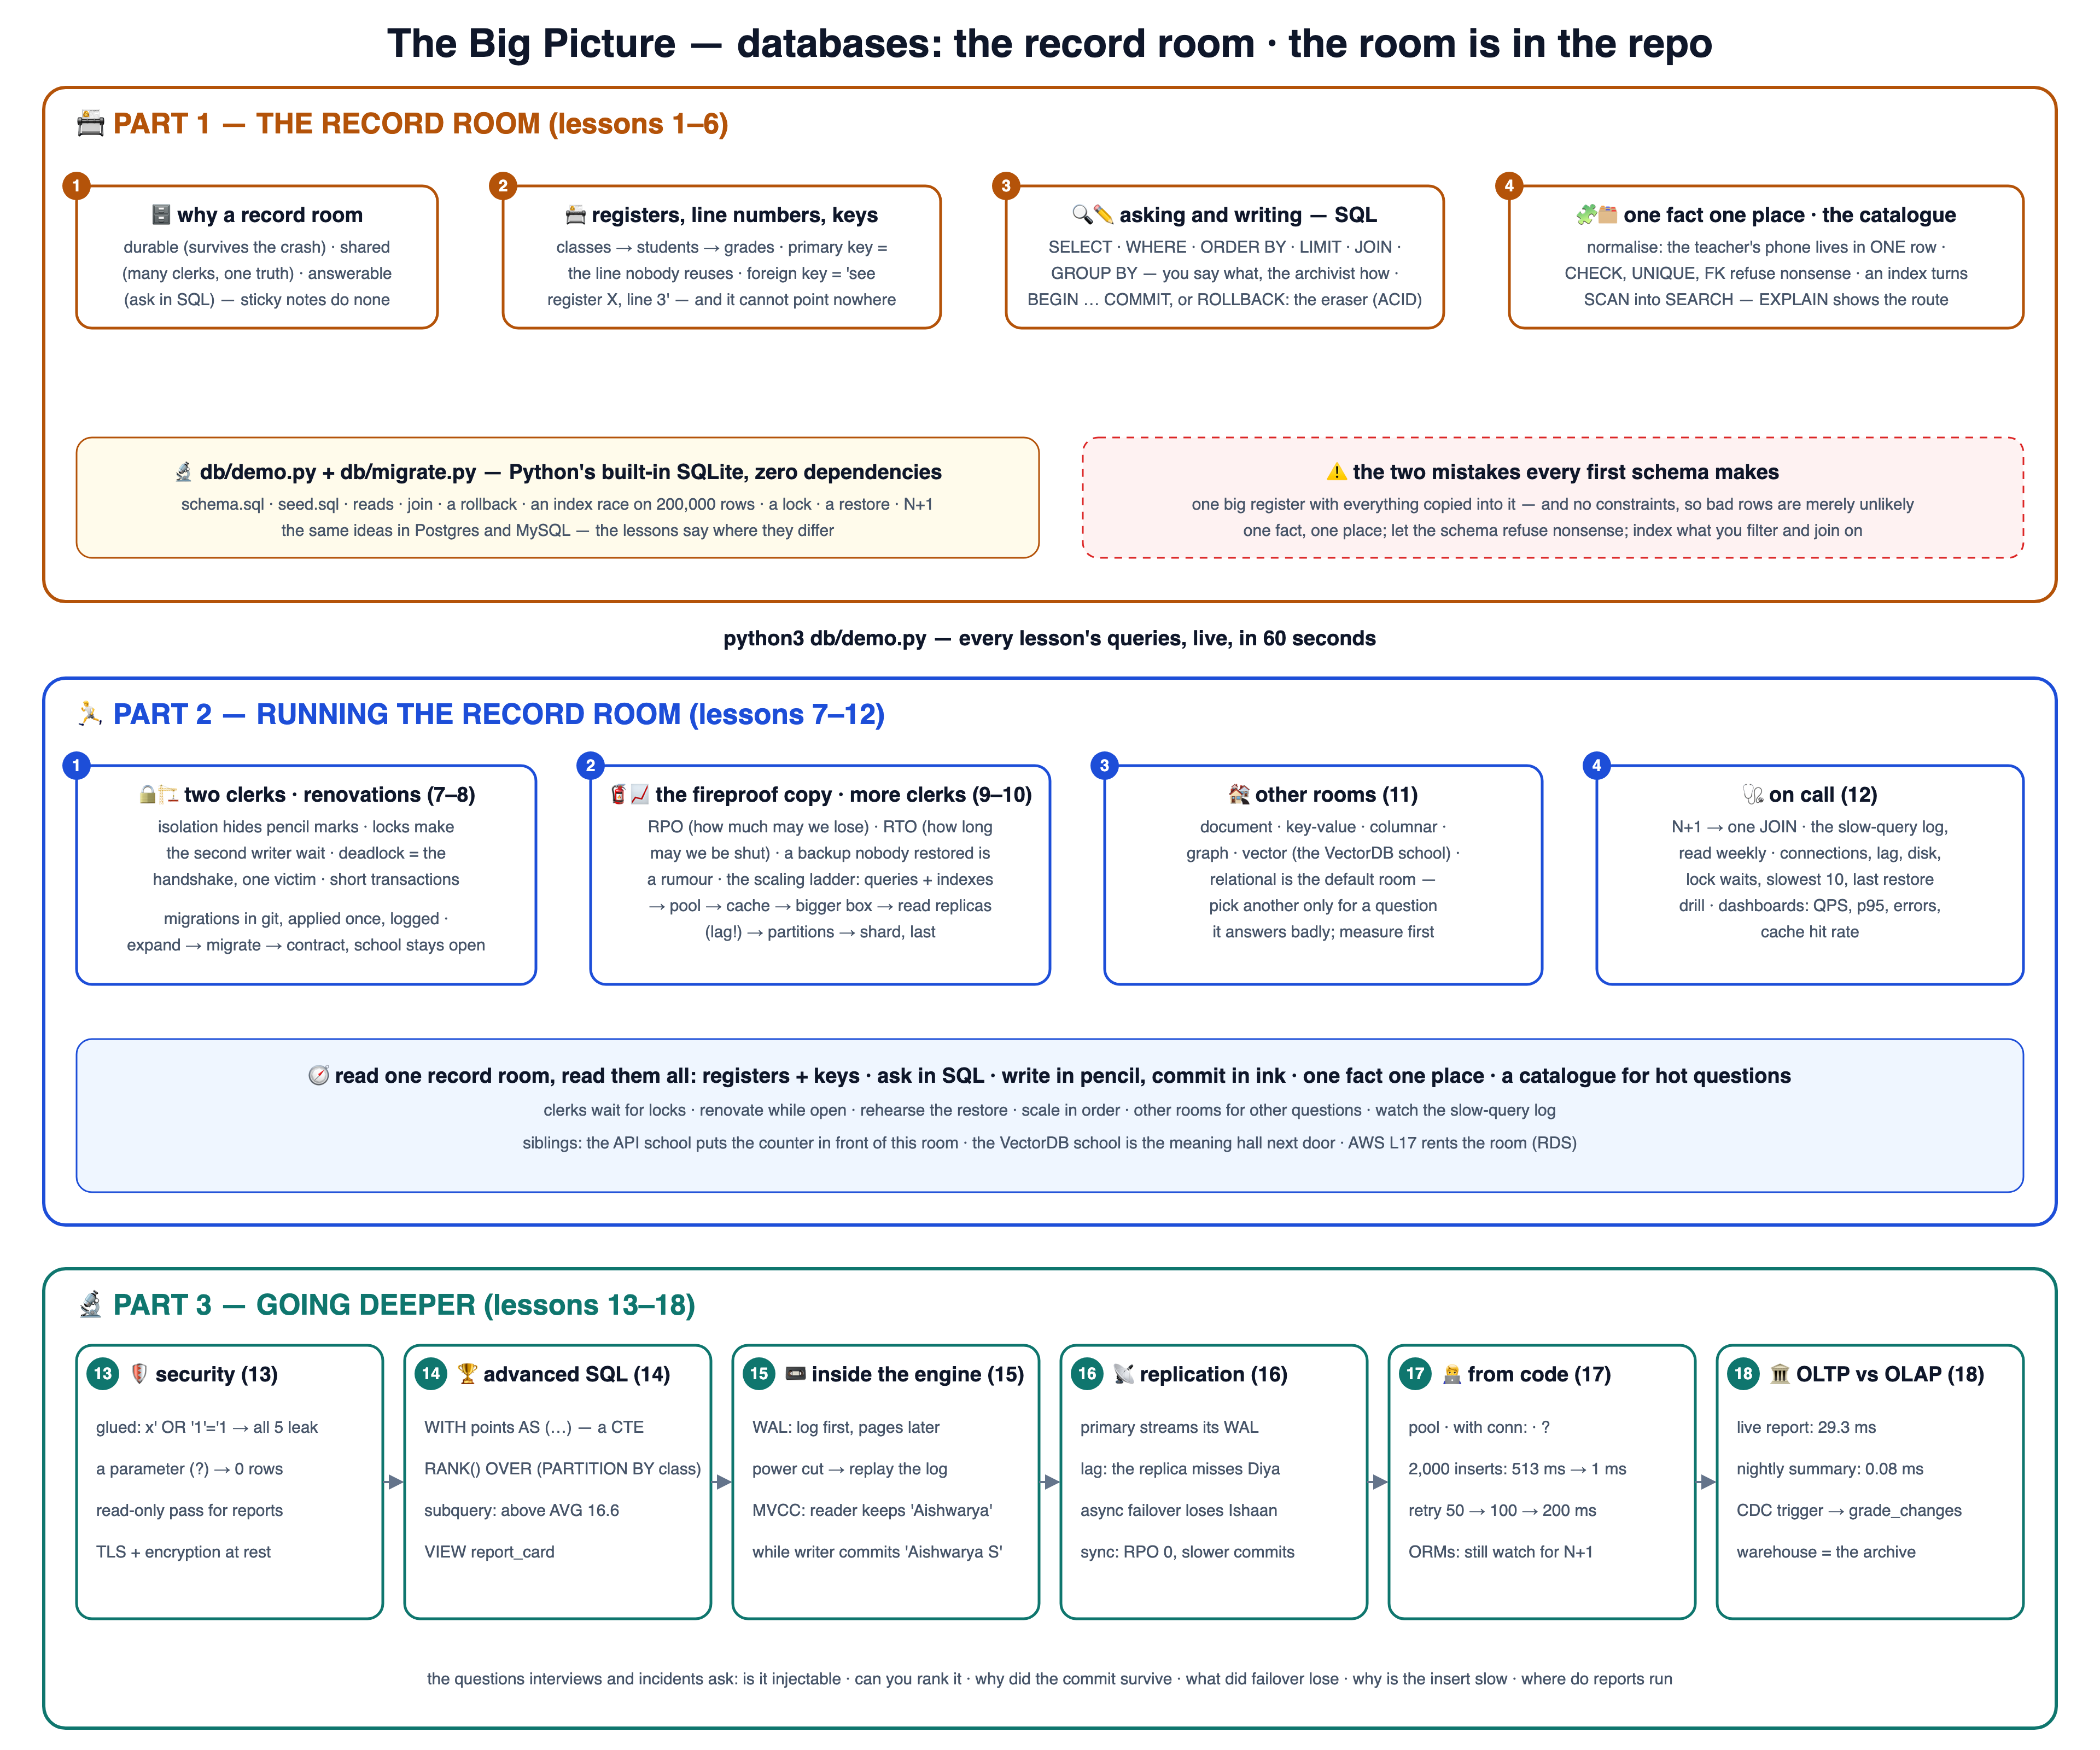
शाळा आपले सत्य कुठे ठेवते, ते रेकॉर्ड रूम च्या रूपात शिकवलेले: नोंदवह्या, ओळींचे क्रमांक, पेन्सिलने लिहिलेले खातेवही, कार्ड कॅटलॉग, आगीपासून सुरक्षित प्रत. प्रत्येक धडा म्हणजे क्रमांकित आकृती असलेली शाळेची गोष्ट — आणि रेकॉर्ड रूम रेपोच्या आतच आहे: खरा SQLite डेटाबेस (Python चे अंगभूत sqlite3, शून्य dependencies) ज्यावर प्रत्येक धडा प्रश्न विचारतो, तो मोडतो आणि दुरुस्त करतो.
# the 60-second wow — every lesson's queries, live:
git clone https://github.com/BaluRaut/learn-database-school.git && cd learn-database-school
python3 db/demo.py                 # builds school.db and runs reads, joins, a rollback, an index race, a lock, a restore…
python3 db/migrate.py              # renovates the room: three migrations, once each
तुम्हाला काय दिसायला हवे (छाटलेले — यश असे दिसते):
🗄️  school.db built from schema.sql + seed.sql

═══ reads ═══
── SELECT … WHERE … ORDER BY … LIMIT
    ('Aishwarya', '3A-01')
    ('Dipika', '3A-03')

═══ join ═══
── JOIN — cross-referencing three registers
    ('Aishwarya', '3A', 'maths', 'A')
    ('Meera', '3B', 'maths', 'A')
    ('Katrina', '3A', 'maths', 'A+')
    ('Rohan', '3B', 'maths', 'B')
    ('Dipika', '3A', 'maths', 'B+')

── GROUP BY — one row per class
    ('3A', 3)
    ('3B', 2)

═══ joins ═══
── INNER JOIN — only pupils WITH a card (matches on both sides)
    ('Aishwarya', 101)
    ('Katrina', 102)
    ('Meera', 103)

── LEFT JOIN — every pupil; no card → NULL
    ('Aishwarya', 101)
    ('Katrina', 102)
    ('Dipika', None)
    ('Meera', 103)
    ('Rohan', None)

── RIGHT JOIN — every card; a card with no pupil → NULL name
    ('Aishwarya', 101)
    ('Katrina', 102)
    ('Meera', 103)
    (None, 104)

── FULL OUTER JOIN — everyone from both sides
    ('Aishwarya', 101)
    ('Katrina', 102)
    ('Dipika', None)
    ('Meera', 103)
    ('Rohan', None)
    (None, 104)

── anti-join (LEFT JOIN … WHERE card IS NULL) — pupils with NO card
    ('Dipika',)
    ('Rohan',)

── CROSS JOIN — every class × every subject (the timetable grid)
    ('3A', 'maths')
    ('3A', 'science')
    ('3B', 'maths')
    ('3B', 'science')

── self join — two pupils in the same class (study buddies)
    ('Aishwarya', 'Katrina')
    ('Aishwarya', 'Dipika')
    ('Katrina', 'Dipika')
    ('Meera', 'Rohan')

═══ txn ═══
── before the transfer
    ('Aishwarya', 1)
    ('Meera', 2)

   💥 second update failed: FOREIGN KEY constraint failed → ROLLBACK

── after — the pencil was erased, BOTH changes gone
    ('Aishwarya', 1)
    ('Meera', 2)

═══ model ═══
── one fact, one place — the class name lives in ONE row
    (1, '3A')
    (2, '3B')

   💥 duplicate roll_no refused by the schema: UNIQUE constraint failed: students.roll_no

   💥 impossible grade refused by CHECK: CHECK constraint failed: grade IN ('A+','A','B+','B','C')

═══ index ═══
── without an index: SCAN attendance → 48 rows in 2.5 ms
── with the card catalogue: SEARCH attendance USING COVERING INDEX idx_attendance_student (student_id=?) → 48 rows in 0.0 ms

═══ locks ═══
── clerk 1 reads while clerk 2's change is uncommitted (isolation)
    (2, 'Katrina')

   ⏳ clerk 1 waited, then: database is locked — the lock protects the register

═══ backup ═══
── after the accident — Rohan is gone
    (1, 'Aishwarya')
    (2, 'Katrina')
    (3, 'Dipika')
    (4, 'Meera')

── after the restore — from the copy we tested
    (1, 'Aishwarya')
    (2, 'Katrina')
    (3, 'Dipika')
    (4, 'Meera')
    (5, 'Rohan')

═══ nplus1 ═══
── N+1: 6 queries, 0.11 ms · one JOIN: 1 query, 0.04 ms — same answer [('Aishwarya', 2), ('Katrina', 2)]…

═══ inject ═══
── the glued query the database actually received:
    SELECT name FROM students WHERE roll_no = 'x' OR '1'='1'
── ❌ string-glued login — every student leaks
    ('Aishwarya',)
    ('Katrina',)
    ('Dipika',)
    ('Meera',)
    ('Rohan',)

── ✅ parameterised (?) — the input is only ever a value
    (no rows)

── the reporting app's read-only connection reads: 5 students
   🔒 …and cannot write: attempt to write a readonly database

═══ window ═══
── CTE + window: RANK() and a running total inside each class
    ('3A', 'Katrina', 20, 1, 20)
    ('3A', 'Aishwarya', 17, 2, 37)
    ('3A', 'Dipika', 15, 3, 52)
    ('3B', 'Meera', 18, 1, 18)
    ('3B', 'Rohan', 13, 2, 31)

── subquery: above the school average (16.6)
    ('Katrina', 20)
    ('Meera', 18)
    ('Aishwarya', 17)

── VIEW report_card — a saved question, used like a table
    ('Katrina', 2, 20)
    ('Meera', 2, 18)
    ('Aishwarya', 2, 17)

═══ procs ═══
── SQLite has no stored procedures (it runs inside your app); db/postgres/procedures.sql is the Postgres version.
   The closest SQLite pieces: a function the SQL can call, and a rule the room enforces for every app.

── points(grade) — a function used inside SQL (Postgres: CREATE FUNCTION points)
    ('Katrina', 20)
    ('Meera', 18)
    ('Aishwarya', 17)

   ⛔ Meera → 3A: class is full (3 pupils) — refused by the room itself, whichever app asked
   ✅ Aishwarya → 3B: moved

═══ wal ═══
── journal mode before: delete → after: wal
   ✍️  writer committed 'Aishwarya S' while the reader was mid-transaction — no 'database is locked'
   👀 reader, same transaction, still sees its snapshot: 'Aishwarya' (was 'Aishwarya')
   👀 reader, new transaction: 'Aishwarya S'
   📼 school.db-wal holds the new pages first: 4,152 bytes
   🧹 checkpoint copies them into school.db: -wal now 0 bytes
── journal mode back to: delete

═══ replica ═══
── (simulated: school.db is the primary, an in-memory copy is the replica, a Python list is the shipped log)
── primary: 6 students · replica, before the log arrives: 5 — replication lag
   ↳ a parent who just enrolled Diya and reloads from the replica sees NO Diya: read your own writes from the primary
── log shipped → replica: 6 students
   💥 the primary dies before shipping Ishaan's line → promote the replica (failover)
── new primary has 6 students: Ishaan is LOST — async replication can lose the last writes (RPO > 0);
   synchronous replication waits for the replica's 'got it' before COMMIT returns, so nothing is lost — each commit pays a round trip

═══ appcode ═══
── 2,000 inserts: commit per row 459 ms · one transaction 1 ms — every COMMIT is a trip to the disk
   ⏳ attempt 1: database is locked → retry in 50 ms (backoff)
   ⏳ attempt 2: database is locked → retry in 100 ms (backoff)
   ✅ attempt 3: done

═══ olap ═══
── report on the live 200,000-line table: 43.6 ms · on the nightly summary (12 rows): 0.04 ms
   same answer: True → [('2026-01', 49.7), ('2026-02', 50.0), ('2026-03', 50.5)]
── CDC: a trigger records every grade change for the warehouse to pick up
    (9, 'B', 'A')

✅ done — the record room survived every lesson
🎒 धडा 01 आधी: तुम्हाला Python 3 लागतो — त्याचे अंगभूत sqlite3 हीच संपूर्ण रेकॉर्ड रूम; server नाही, Docker नाही, क्लाउड नाही. चांगले शेजारी: API शाळा (या खोलीसमोरचे काउंटर), AWS शाळेचा RDS धडा (खोली भाड्याने) आणि VectorDB शाळा (शेजारचा अर्थाचा हॉल). हे काय नाही: Postgres प्रशासनाचे पुस्तक — कल्पना Postgres, MySQL आणि SQLite मध्ये सारख्याच; कुठे फरक आहे ते धडे सांगतात.
एक git ब्रँच = एक कल्पना; ब्रँच 04 मध्ये धडे 01–04 आहेत. लॅब साध्या Python 3 वर चालतात — डेटाबेस server स्थापायची गरज नाही.
1
🗄️ डेटाबेस का
रेकॉर्ड रूम विरुद्ध चिकट चिठ्ठ्या — टिकाऊ, सामायिक, आणि प्रश्नाला उत्तर देणारी.lesson-01-why-databasesधडा वाचा →आकृती पहा ↗
2
📇 Tables, rows & keys
क्रमांकित ओळी असलेल्या नोंदवह्या — primary keys, foreign keys, वर्ग → विद्यार्थी → श्रेणी हा आकार.lesson-02-tables-rows-keysधडा वाचा →आकृती पहा ↗
3
🔍 SQL वाचन
दप्तरदाराला विचारणे — SELECT, WHERE, ORDER BY, LIMIT, आणि प्रत्येक JOIN: inner, left, right, full outer, anti, cross आणि self.lesson-03-sql-readsधडा वाचा →आकृती पहा ↗
4
✏️ लिहिणे & transactions
पेन्सिलचे खातेवही — INSERT, UPDATE, DELETE, आणि ACID खरे करणारा खोडरबर (ROLLBACK).lesson-04-transactionsधडा वाचा →आकृती पहा ↗
5
🧩 Data modelling
एक तथ्य, एक जागा — normalisation, constraints, आणि हा नियम मुद्दाम कधी मोडायचा.lesson-05-data-modellingधडा वाचा →आकृती पहा ↗
6
🗂️ Indexes
कार्ड कॅटलॉग — B-trees, EXPLAIN, आणि कॅटलॉग तुम्हाला कधी हळू करतो.lesson-06-indexesधडा वाचा →आकृती पहा ↗
🏃 भाग 2 — रेकॉर्ड रूम खऱ्या जगात चालवणे (धडे 7–12)
production डेटाबेसला लागणारे सगळे, प्रत्येक गोष्ट त्याच छोट्या शाळेच्या डेटाबेसवर दाखवलेली.
7
🔒 Concurrency & isolation
दोन कारकून, एक नोंदवही — locks, isolation levels, आणि deadlock चा हस्तांदोलन.lesson-07-concurrencyधडा वाचा →आकृती पहा ↗
8
🏗️ Migrations
शाळा चालू असतानाच खोलीचे नूतनीकरण — आवृत्ती असलेल्या scripts, आधी expand मग contract.lesson-08-migrationsधडा वाचा →आकृती पहा ↗
9
🧯 Backups & recovery
आगीपासून सुरक्षित प्रत — RPO, RTO, point-in-time, आणि तुम्ही खरोखर करता ती restore ची रंगीत तालीम.lesson-09-backups-recoveryधडा वाचा →आकृती पहा ↗
10
📈 Scaling
अधिक कारकून, अधिक खोल्या — pools, replicas, caches, partitions, आणि shard कधी करू नये.lesson-10-scalingधडा वाचा →आकृती पहा ↗
11
🏘️ NoSQL & इतर खोल्या
Document, key-value, columnar, graph, vector — प्रश्नासाठी योग्य खोली निवडणे.lesson-11-nosql-other-roomsधडा वाचा →आकृती पहा ↗
12
🩺 Performance & operations
हळू queries ची तपासणी, N+1, observability — रेकॉर्ड रूम on call जाण्याआधीची चेकलिस्ट.lesson-12-performance-opsधडा वाचा →आकृती पहा ↗
🔬 भाग 3 — अधिक खोलात (धडे 13–18)
interviews आणि incidents मध्ये विचारले जाणारे विषय: सुरक्षा, advanced SQL, log आणि MVCC, replication आणि failover, app ची बाजू, आणि analytics — प्रत्येक school.db वर प्रत्यक्ष चालवलेला.
13
🛡️ सुरक्षा
कुलूपबंद रजिस्टर — SQL injection, parameters, least privilege, आणि transit मध्ये व at rest encryption.lesson-13-securityधडा वाचा →आकृती पहा ↗
14
🏆 Advanced SQL
एकही row न गमावता क्रम — subqueries, CTEs, window functions, views, आणि room मध्ये राहणारा code: functions आणि stored procedures.lesson-14-advanced-sqlधडा वाचा →आकृती पहा ↗
15
📼 engine च्या आत
log आधी येतो — WAL, crash recovery, MVCC snapshots आणि vacuum.lesson-15-inside-the-engineधडा वाचा →आकृती पहा ↗
16
📡 Replication आणि failover
खोलीच्या प्रती — log चा प्रवाह, lag, sync विरुद्ध async, failover आणि CAP trade-off.lesson-16-replication-failoverधडा वाचा →आकृती पहा ↗
17
🧑💻 code मधून database
app ची बाजू — pools, transactions, parameters, batching, backoff सह retries, आणि ORMs.lesson-17-app-codeधडा वाचा →आकृती पहा ↗
18
🏛️ OLTP विरुद्ध OLAP
कार्यालय आणि संग्रहालय — warehouses, रात्रीचा ETL, columnar storage, आणि trigger वापरून CDC.lesson-18-oltp-olapधडा वाचा →आकृती पहा ↗
🗣️ हे मोठ्याने समजावा — धडा 18 नंतर: (0) हाताने quotes escape केल्याने SQL injection थांबत नाही पण parameter ने का थांबते, आणि WAL मुळे commit झालेली row वीज गेल्यावरही का टिकते? मग: (1) foreign key मुळे वाईट row फक्त कमी शक्य न राहता अशक्यच का होते? (2) एक transaction दोन rows update करतो आणि दुसरा अपयशी होतो — नंतर disk वर काय असते, आणि का? (3) index जोडल्याने system कधी हळू होते? (4) दोन कारकून, एक row: isolation काय लपवते, आणि deadlock कसा दिसतो? (5) downtime शिवाय column चे नाव बदला — चार पायऱ्या सांगा. (6) RPO आणि RTO प्रत्येकी एका वाक्यात, आणि तुमच्या शेवटच्या restore सरावाची तारीख.
प्रत्येक धडा एका क्रमांकित बॉक्स-आणि-बाण आकृतीत — स्वतंत्र पानावरही.
1 🗄️ डेटाबेस का
रेकॉर्ड रूम विरुद्ध चिकट चिठ्ठ्या — टिकाऊ, सामायिक, आणि प्रश्नाला उत्तर देणारी.
🧒 सोप्या शब्दांत
तीन शिक्षकांनी आपापली grades ची spreadsheet ठेवली, तर लवकरच copies जुळत नाहीत, शेवटचा save जिंकतो, आणि laptop बंद पडला की सगळे हरवते. शाळेचे record room हे सोडवते: नोंदींचा एकच संच, disk वर सुरक्षित, अनेक clerks एकाच वेळी वापरतात, आणि '3A मधील A मिळालेली सगळी मुले' असे प्रश्न विचारता येतात. computer साठी database म्हणजे हेच record room.
📖 नवे शब्दdatabase — अनेक लोक आणि apps वापरतात असा नोंदींचा एकच व्यवस्थित साठाdurable — एकदा save झाले की crash किंवा वीज गेली तरी टिकतेshared — अनेक clerks एकमेकांचे काम न पुसता एकाच नोंदींवर काम करतातSQL — record room ला प्रश्न विचारण्याची भाषा
⏪ आधी
sticky notes आणि spreadsheets मध्ये grades.xlsx च्या तीन copies असतात, शेवटचा save जिंकतो, आणि laptop बंद पडला की सगळे जाते.
💡 काय
database म्हणजे record room: एकच सत्य, जे टिकाऊ आहे, अनेक clerks मध्ये shared आहे, आणि प्रश्न विचारून उत्तर देते.
⚙️ कसे
school.db disk वर लिहिले जाते, locks आणि transactions अनेक clerks ना ते share करू देतात, आणि SELECT name FROM students सारखा SQL प्रश्न विचारतो.
🎯 का
ते crash मधून वाचते, दुसऱ्याच्या save मुळे काम हरवत नाही, आणि 3A मधील A मिळालेली सर्व मुले सारख्या प्रश्नांची उत्तरे देते.
🚀 पुढे
पुढे तुम्ही registers स्वतः बनवाल: tables, rows, आणि classes, students व grades जोडणाऱ्या keys.
🧪 Try it here — चिकट चिठ्ठ्यांना विचारा, मग रेकॉर्ड रूमला विचारा
क्रमांकित ओळी असलेल्या नोंदवह्या — primary keys, foreign keys, वर्ग → विद्यार्थी → श्रेणी हा आकार.
🧒 सोप्या शब्दांत
शाळा तीन registers ठेवते: वर्ग, विद्यार्थी आणि grades. प्रत्येक ओळीला एक क्रमांक असतो जो पुन्हा कधी वापरला जात नाही, म्हणून student 4 म्हणजे नेहमी Meera. Meera च्या वर्गाचे नाव पुन्हा लिहिण्याऐवजी तिची ओळ फक्त सांगते 'वर्ग register, ओळ 2 पाहा'. ओळ क्रमांकाकडे बोट दाखवल्याने प्रत्येक माहिती एकाच ठिकाणी राहते, म्हणून typo मुळे एका वर्गाचे दोन वर्ग होत नाहीत.
📖 नवे शब्दtable — एक register: एकाच प्रकारच्या गोष्टींच्या rowsrow — register मधील एक ओळ, उदा. एक विद्यार्थीcolumn — प्रत्येक ओळीत असणारे एक field, उदा. name किंवा class_idprimary key — दुसऱ्या कोणत्याही ओळीला न मिळणारा आणि पुन्हा न वापरला जाणारा ओळ क्रमांकforeign key — दुसऱ्या register मधील ओळीकडे बोट दाखवणारी नोंद
⏪ आधी
keys शिवाय मुलाचा वर्ग प्रत्येक ओळीवर मोकळ्या text मध्ये लिहिला जातो, आणि कोणता grade कोणाचा हे काहीच सांगत नाही.
💡 काय
table म्हणजे क्रमांक असलेल्या ओळींचे register: primary key हा कोणी पुन्हा न वापरणारा ओळ क्रमांक, foreign key दुसरीकडे बोट दाखवते.
⚙️ कसे
students.class_id → classes.id Aishwarya ला class 1 (3A) मध्ये ठेवते, आणि grades.student_id → students.id सांगते grade 7 Meera चा आहे.
🎯 का
प्रत्येक fact एकदाच साठवला जातो आणि keys ने जोडला जातो, म्हणून data वाढला तरी class → student → grade आकार बरोबर राहतो.
🚀 पुढे
जोडलेले registers तयार झाल्यावर पुढचा lesson SELECT आणि JOIN ने त्यांना प्रश्न विचारतो.
🧪 Try it here — कुठेच न दाखवणारी ओळ, किंवा आधीच असलेला क्रमांक लिहून पहा
दप्तरदाराला विचारणे — SELECT, WHERE, ORDER BY, LIMIT, आणि प्रत्येक JOIN: inner, left, right, full outer, anti, cross आणि self.
🧒 सोप्या शब्दांत
तुम्ही archivist ला एक चिठ्ठी देता: 'वर्ग 3A मधील नावे, क्रमाने, फक्त पहिली 2'. तुम्ही काय हवे ते सांगता; ते कसे शोधायचे ते archivist ठरवतो. बऱ्याचदा उत्तर अनेक registers मध्ये विखुरलेले असते, म्हणून JOIN क्रमांक जुळवून त्यांना शेजारी लावतो. जुळणी नसेल तेव्हा कोण राहणार हे प्रत्येक प्रकारचा JOIN ठरवतो: फक्त जुळलेल्या जोड्या, एका बाजूचे सगळे, किंवा दोन्ही बाजूंचे सगळे.
📖 नवे शब्दSELECT … WHERE — कोणते columns दाखवायचे आणि कोणत्या rows ठेवायच्या ते निवडाORDER BY / LIMIT — उत्तर क्रमाने लावा, मग फक्त पहिल्या काही rows ठेवाINNER JOIN — दोन्ही बाजूंना जुळणी असलेल्या rows च ठेवतोLEFT JOIN — डाव्या बाजूची प्रत्येक row ठेवतो; उजवीकडे जुळणी नसेल तिथे रिकामेanti join — जुळणी नसलेल्या rows शोधतो, उदा. अजून grade नसलेली मुले
⏪ आधी
SQL शिवाय एका उत्तरासाठी प्रत्येक register हाताने scroll करावे लागेल आणि तीन tables मधून जुळणाऱ्या ओळी copy कराव्या लागतील.
💡 काय
SELECT म्हणजे archivist ला दिलेली चिठ्ठी: ती तुम्हाला काय हवे ते सांगते, आणि planner ते कसे आणायचे ते ठरवतो.
⚙️ कसे
WHERE class_id = 1 पाचपैकी 3 rows ठेवतो, ORDER BY name LIMIT 2 Aishwarya आणि Dipika देतो, आणि JOIN ... ON grades ला students शी जोडतो.
🎯 का
INNER फक्त जुळणारे ठेवतो, LEFT प्रत्येक विद्यार्थी ठेवतो (Dipika → NULL), FULL दोन्ही बाजू ठेवतो — report वर कोण ते join ठरवतो.
🚀 पुढे
वाचणे सुरक्षित आहे; पुढे तुम्ही transactions मध्ये INSERT, UPDATE आणि DELETE ने data बदलाल.
🧪 Try it here — चिठ्ठी बांधा आणि ओळी कमी होताना पहा
🧪 Try it here — JOIN निवडा — डावीकडे विद्यार्थी, उजवीकडे library cards; कोणत्या rows टिकतात ते पाहा
पेन्सिलचे खातेवही — INSERT, UPDATE, DELETE, आणि ACID खरे करणारा खोडरबर (ROLLBACK).
🧒 सोप्या शब्दांत
दोन मुलांना नव्या वर्गात हलवायला दोन बदल लागतात. आधी ते pencil ने लिहा: वर्ग 99 नसल्यामुळे दुसरा बदल fail झाला, तर खोडरबर दोन्ही पुसते, म्हणून register मध्ये कधीच अर्धवट बदल दिसत नाही. सगळे ठीक असेल तर COMMIT pencil चे एकदम शाईत रूपांतर करतो, आणि वीज गेली तरी ते पुसले जात नाही. सगळे, किंवा काहीच नाही.
📖 नवे शब्दINSERT / UPDATE / DELETE — ओळ जोडा, ओळ बदला, ओळ काढाtransaction — एकत्र होणारे अनेक बदल: सगळे किंवा काहीच नाहीROLLBACK — खोडरबर: BEGIN पासूनच्या सगळ्या pencil खुणा पुसाCOMMIT — pencil चे शाईत रूपांतर, disk वर सुरक्षित saveACID — चार वचने: सगळे-किंवा-काहीच नाही, योग्य, इतरांपासून वेगळे, कायमचे
⏪ आधी
transactions शिवाय एखादे transfer अर्ध्यावर थांबू शकते, एक मूल हलवलेले आणि दुसरा बदल तुटलेला राहतो.
💡 काय
transaction म्हणजे pencil ने लिहिलेले ledger: BEGIN, बदल करा, मग COMMIT करून शाईने पक्के करा किंवा ROLLBACK ने सगळे खोडा.
⚙️ कसे
python3 db/demo.py txn मध्ये class 99 चा update FK वर fail होतो, म्हणून ROLLBACK पहिला update सुद्धा खोडतो.
🎯 का
ledger कधीच अर्धे transfer दाखवत नाही: सगळे किंवा काहीच नाही, आणि COMMIT झालेला बदल power cut नंतरही टिकतो.
🚀 पुढे
सुरक्षित writes ला लिहिण्यासाठी चांगला आकार लागतो, तो पुढचा data modelling चा lesson देतो.
🧪 Try it here — दोन पेन्सिलीच्या खुणा करा, मग खोडरबर की शाई ते निवडा
एक तथ्य, एक जागा — normalisation, constraints, आणि हा नियम मुद्दाम कधी मोडायचा.
🧒 सोप्या शब्दांत
Ms Rao चा phone नंबर एका मोठ्या register च्या तीसही rows वर लिहिला असेल, तर नवा नंबर आला की तीस rows दुरुस्त कराव्या लागतात, आणि कोणीतरी काही विसरतोच. चांगली रचना प्रत्येक माहिती नेमकी एकाच ठिकाणी लिहिते: शिक्षक एका register मध्ये, वर्ग दुसऱ्यात, क्रमांकाने जोडलेले. constraints नावाचे नियम दारावर पहारा देतात म्हणून चुकीचा data आत येत नाही. कधी कधी वेगासाठी माहिती मुद्दाम copy करतात, पण फक्त जाणीवपूर्वक.
📖 नवे शब्दnormalisation — प्रत्येक माहिती एकदाच साठवणे, आणि keys ने तिच्याशी जोडणेanomaly — एकच माहिती अनेक rows मध्ये असल्यामुळे होणारी चूकconstraint — database पाळायला लावतो असा नियम, उदा. 'grade रिकामा नको'denormalise — वाचणे जलद व्हावे म्हणून माहिती मुद्दाम copy करणे
⏪ आधी
एका मोठ्या register मध्ये Ms Rao चा phone तीस rows वर लिहिलेला असतो, म्हणून एक बदल केला की त्यातील 29 चुकीचे राहतात.
💡 काय
normalisation म्हणजे एक fact एकाच ठिकाणी: classes, teachers, students आणि grades वेगळ्या tables मध्ये, keys ने जोडलेले.
⚙️ कसे
teacher चा phone teachers मध्ये एकदाच राहतो, classes key ने त्याकडे बोट दाखवतात, आणि constraints नियम मोडणाऱ्या rows नाकारतात.
🎯 का
हे update, insert आणि delete anomalies दूर करते, आणि नियम फक्त जाणूनबुजून, स्पष्ट कारणासाठीच मोडला जातो.
🚀 पुढे
स्वच्छ model सुद्धा शोधायला हळू असू शकते, म्हणून पुढचा lesson indexes, म्हणजे card catalogue, जोडतो.
🧪 Try it here — एका मोठ्या नोंदवहीत शिक्षकाचा फोन बदला, मग normalised खोलीत
कार्ड कॅटलॉग — B-trees, EXPLAIN, आणि कॅटलॉग तुम्हाला कधी हळू करतो.
🧒 सोप्या शब्दांत
catalogue नसलेल्या library मध्ये एक पुस्तक शोधायला प्रत्येक कपाटासमोरून जावे लागते. 200,000 हजेरीच्या ओळींमध्ये student 4242 शोधणे असेच आहे: सगळ्या ओळी वाचा. index म्हणजे card catalogue, ड्रॉवरच्या आत ड्रॉवर असे क्रमाने लावलेले, म्हणून database साधारण 3 पायऱ्यांत तिथे पोहोचतो. किंमत: प्रत्येक नवी ओळ catalogue मध्येही नोंदवावी लागते, म्हणून खूप जास्त indexes लिहिणे हळू करतात.
📖 नवे शब्दindex — थेट योग्य rows कडे नेणारा क्रमाने लावलेला cataloguescan — जुळणारी row शोधायला प्रत्येक row एकेक करून वाचणेB-tree — पटकन शोध कमी करण्यासाठी index वापरतो तो ड्रॉवरच्या-आत-ड्रॉवर आकारEXPLAIN — database ला विचारा की तो उत्तर कसे शोधणार आहे
⏪ आधी
index शिवाय student 4242 शोधण्यासाठी सर्व 200,000 attendance ओळी वाचाव्या लागतात, प्रत्येक lookup ला 2.4 ms.
💡 काय
index म्हणजे card catalogue, एक B-tree जो keys drawers मध्ये लावतो म्हणजे तुम्ही थेट योग्य row वर पोहोचता.
⚙️ कसे
CREATE INDEX नंतर EXPLAIN SEARCH … USING INDEX दाखवतो: 200,000 ऐवजी 3 steps, O(n) ऐवजी O(log n).
🎯 का
scan table सोबत दुप्पट होतो, तर index वेगवान राहतो, आणि तो तुम्हाला पहाटे 3 वाजताच्या page पासून वाचवू शकतो.
🚀 पुढे
प्रत्येक index writes हळू करतो सुद्धा, आणि अनेक clerks एकाच वेळी लिहितात म्हणून पुढचा विषय concurrency आणि locks.
🧪 Try it here — attendance table वाढवा आणि बोटाची catalogue शी तुलना करा
दोन कारकून, एक नोंदवही — locks, isolation levels, आणि deadlock चा हस्तांदोलन.
🧒 सोप्या शब्दांत
दोन clerks एकाच register वर काम करतात. clerk 2 Katrina चे नाव pencil ने बदलत असताना clerk 1 ला जुनेच नाव दिसते; pencil खुणांमध्ये डोकावणे नाही. clerk 1 ला तीच ओळ बदलायची असेल, तर clerk 2 commit करेपर्यंत तो lock साठी थांबतो. ही गोपनीयता किती कडक हे isolation levels ठरवतात. दोन clerks कायम एकमेकांची वाट पाहत बसले, तर तो deadlock, आणि एकाला माघार घ्यावी लागते.
📖 नवे शब्दlock — row वरची 'काम चालू' पाटी, म्हणजे एका वेळी एकच clerk बदल करतोisolation level — इतर clerks चे अपूर्ण काम तुम्हाला किती दिसू शकतेdirty read — commit होण्याआधीच कोणाची pencil खूण वाचणेdeadlock — दोन clerks एकमेकांची वाट पाहतात; database एकाला रद्द करतो
⏪ आधी
isolation शिवाय एकाच row वर एकाच वेळी काम करणारे दोन clerks अर्धवट pencil खुणा वाचू शकतात किंवा एकमेकांचे काम पुसू शकतात.
💡 काय
locks आणि isolation levels ठरवतात की एक transaction pencil मध्ये असताना दुसरे काय पाहू आणि बदलू शकते.
⚙️ कसे
Katrina चे नाव बदलण्यासाठी clerk 2 row 2 lock करतो; clerk 1 ला जुने नावच दिसते, आणि त्याचा update COMMIT lock सोडेपर्यंत थांबतो.
🎯 का
pencil खुणा खाजगी राहतात, म्हणून वाचणाऱ्यांना फक्त शाई दिसते, आणि deadlock दोन्ही clerks ना कायम अडकवण्याऐवजी पकडला जातो.
🚀 पुढे
clerks काम करत असतानाच खऱ्या खोल्यांचा आकारही बदलतो, हे पुढचा lesson migrations ने हाताळतो.
🧪 Try it here — दोन्ही कारकून खेळा आणि पेन्सिल खासगी राहताना पहा
शाळा चालू असतानाच खोलीचे नूतनीकरण — आवृत्ती असलेल्या scripts, आधी expand मग contract.
🧒 सोप्या शब्दांत
शाळेला वर्ग चालू असतानाच register मध्ये 'house' column जोडायचा आहे, आणि त्यासाठी शाळा बंद ठेवता येत नाही. म्हणून प्रत्येक बदल git मध्ये ठेवलेली क्रमांक असलेली script असते, आणि database मधली एक logbook कोणत्या scripts आधीच चालल्या ते नोंदवते, म्हणजे प्रत्येक script क्रमाने, एकदाच चालते. मोठे बदल टप्प्याटप्प्याने: आधी नवा भाग जोडा, code ला दोन्ही वापरू द्या, जुन्या rows भरा, आणि मगच जुना भाग काढा.
📖 नवे शब्दmigration — database चा आकार बदलणारी क्रमांक असलेली scriptschema — database चा आराखडा: कोणते tables आणि columns आहेतexpand / contract — आधी नवा भाग जोडा; जुना भाग कोणी वापरत नसेल तेव्हाच काढाbackfill — जुन्या rows साठी नवा column भरणे, एका वेळी एक batch
⏪ आधी
migrations शिवाय schema बदल production मध्ये हाताने टाइप होतात, आणि कोणत्या database मध्ये कोणते columns आहेत हे कोणाला कळत नाही.
💡 काय
migration म्हणजे git मधील versioned SQL script, जसे 002_add_house.sql, आणि एक logbook table कोणत्या चालल्या ते नोंदवते.
⚙️ कसे
db/migrate.py schema_migrations मध्ये नसलेली प्रत्येक script क्रमाने एकदाच चालवते, म्हणून दोनदा चालवले तरी काही होत नाही.
🎯 का
expand, migrate, मग contract केल्याने शाळा चालू असतानाच, downtime शिवाय, columns rename किंवा add करता येतात.
🚀 पुढे
काळजीपूर्वक केलेले बदलही चुकू शकतात, म्हणून पुढचा lesson backups आणि recovery ने fireproof copy बनवतो.
🧪 Try it here — scripts एकेक लावा — आणि साधन पुन्हा चालवून ते काहीच करत नाही ते पहा
आगीपासून सुरक्षित प्रत — RPO, RTO, point-in-time, आणि तुम्ही खरोखर करता ती restore ची रंगीत तालीम.
🧒 सोप्या शब्दांत
शाळा महत्त्वाच्या कागदांच्या copies दुसऱ्या इमारतीत fireproof पेटीत ठेवते. database backup म्हणजे ती copy, आणि त्यानंतर झालेल्या प्रत्येक बदलाची डायरी. 10:14 ला कोणी चुकून Rohan ला delete केले, तर कालच्या रात्रीची copy restore करा, डायरी 10:13 पर्यंत पुन्हा चालवा, आणि Rohan परत येतो. restore करून पाहिल्यावरच backup खरा ठरतो.
📖 नवे शब्दbackup — data ची सुरक्षित copy, दुसरीकडे ठेवलेलीpoint-in-time recovery — copy restore करा, मग निवडलेल्या मिनिटापर्यंत बदल पुन्हा चालवाRPO — अलीकडचे किती काम हरवले तरी चालेलRTO — restore करताना किती वेळ बंद राहिले तरी चालेलrestore drill — backup चालतो हे सिद्ध करण्यासाठी restore चा प्रत्यक्ष सराव
⏪ आधी
backup शिवाय एक DELETE किंवा इमारतीतील आग data आणि disk दोन्ही कायमचे घेऊन जाते.
💡 काय
backup म्हणजे दुसऱ्या इमारतीतील fireproof copy: रोज रात्रीची पूर्ण copy आणि प्रत्येक बदलाचा सतत चालणारा log (WAL).
⚙️ कसे
10:14 ला Rohan delete होतो; restore 02:00 चा backup परत copy करतो, log 10:13 पर्यंत replay करतो, आणि तो परत येतो.
🎯 का
point-in-time recovery गमावलेल्या कामाचे तास मिनिटांत बदलते, आणि RPO व RTO सांगतात किती नुकसान व downtime चालेल.
🚀 पुढे
तुम्ही खरोखर केलेल्या restore drill नंतरच backup मोजला जातो; पुढे scaling ने record room वाढतो.
🧪 Try it here — शाळेचे दोन आकडे ठरवा, मग आगीची तालीम चालवा
अधिक कारकून, अधिक खोल्या — pools, replicas, caches, partitions, आणि shard कधी करू नये.
🧒 सोप्या शब्दांत
office ची रांग लांब झाली की तुम्ही आधी दुसरी शाळा बांधत नाही. सर्वात स्वस्त उपाय क्रमाने करून पाहता: हळू प्रश्न index ने जलद करा, connections वाटून वापरा, नेहमीची उत्तरे cache मध्ये जवळ ठेवा, मोठे machine घ्या, वाचण्यासाठी copy rooms जोडा. नोंदी अनेक वेगळ्या खोल्यांमध्ये वाटणे, म्हणजे sharding, सगळ्यात शेवटी येते, आणि बहुतेक शाळांना त्याची गरजच पडत नाही.
📖 नवे शब्दconnection pool — काही उघडी connections, जी अनेक requests आळीपाळीने वापरतातcache — नेहमीच्या उत्तराची जलद copy, कदाचित थोडी जुनीread replica — फक्त वाचण्यासाठी वापरली जाणारी database ची copy, थोडी मागेpartition — एका मोठ्या table चे भाग करणे, उदा. प्रत्येक वर्षासाठी एक खोलीshard — data वेगवेगळ्या database servers मध्ये वाटणे; शेवटचा उपाय
⏪ आधी
योजनेशिवाय teams थेट sharding कडे उडी घेतात, जेव्हा हळू query ला फक्त index हवा होता, आणि कायम complexity ची किंमत भरतात.
💡 काय
scaling म्हणजे क्रमाने क्षमता वाढवणे, स्वस्त आधी: queries सुधारा, pool, cache, मोठे machine, replicas, partitions, shards.
⚙️ कसे
एक primary सर्व writes घेतो तर read replicas थोडे मागे राहून readers ना सेवा देतात, आणि pgbouncer connections pool करतो.
🎯 का
index ने सुधारलेली हळू query उजवीकडील प्रत्येक box पेक्षा चांगली आहे, आणि बहुतेक शाळांना shards कधीच लागत नाहीत.
🚀 पुढे
काही प्रश्न rows मध्ये बसतच नाहीत, म्हणून पुढचा lesson NoSQL आणि इतर खोल्यांना भेट देतो.
🧪 Try it here — लक्षण निवडा — शिडी सांगते पुढची पायरी कोणती
Document, key-value, columnar, graph, vector — प्रश्नासाठी योग्य खोली निवडणे.
🧒 सोप्या शब्दांत
ओळी आणि columns असलेले register शाळेच्या बहुतेक प्रश्नांना चालते, पण सगळ्यांना नाही. पानांच्या आत पाने असलेली मुलाची पूर्ण file folder मध्ये बसते; 'locker 42 मध्ये काय आहे?' key box मध्ये; अब्जावधी rows ची बेरीज column store मध्ये; 'मित्रांचे मित्र' graph मध्ये; 'सारखा अर्थ असलेल्या गोष्टी' vector store मध्ये. नेहमी register वापरा, आणि दुसरी खोली फक्त तिच्या खास प्रश्नासाठी निवडा.
📖 नवे शब्दrelational — keys, JOINs आणि transactions असलेले tables; नेहमीची निवडdocument store — प्रत्येक record एका आत-आत असलेल्या file सारखा ठेवतो, उदा. मुलाचा folderkey-value — एका key ला एक उत्तर, खूप जलद, उदा. sessions साठीgraph — कोण कोणाशी जोडलेला ते साठवतो, मित्रांचे मित्र सारख्या उड्यांसाठीvector — अर्थाने सर्वात जवळच्या गोष्टी शोधतो
⏪ आधी
प्रत्येक प्रश्न rows मध्ये कोंबल्याने nested records, microsecond lookups आणि अब्जावधी rows चे analytics हळू किंवा अवघड होतात.
💡 काय
NoSQL म्हणजे प्रत्येकी एका प्रश्नासाठी घडवलेल्या इतर खोल्या: document, key-value, columnar, graph आणि vector stores.
⚙️ कसे
MongoDB nested records ठेवतो, Redis एका key चे उत्तर µs मध्ये देतो, BigQuery अब्ज rows जोडतो, Neo4j friends of friends शोधतो.
🎯 का
constraints, JOINs आणि transactions साठी relational हीच default खोली राहते; ती वाईट उत्तर देते त्या प्रश्नासाठीच दुसरी निवडा.
🚀 पुढे
vector खोली VectorDB school कडे नेते, आणि पुढे तुम्ही कोणतीही खोली operations मध्ये वेगवान कशी ठेवायची ते शिकाल.
हळू queries ची तपासणी, N+1, observability — रेकॉर्ड रूम on call जाण्याआधीची चेकलिस्ट.
🧒 सोप्या शब्दांत
कल्पना करा, एक शिक्षक वर्गाच्या यादीसाठी एकदा office मध्ये जातात, मग प्रत्येक मुलाच्या grades साठी पुन्हा एकदा: 5 मुलांसाठी 6 फेऱ्या, 500 साठी 501. JOIN ने एकदाच विचारले की सगळे एका फेरीत मिळते. database एक slow-query log सुद्धा ठेवू शकतो, म्हणजे खूप वेळ घेतलेल्या प्रत्येक प्रश्नाची यादी. ती दर आठवड्याला वाचा, सर्वात हळू दहा दुरुस्त करा, आणि मग रात्री अडचणी क्वचितच उठवतात.
📖 नवे शब्दN+1 — यादीसाठी एक query, मग प्रत्येक item साठी आणखी एक: अनेक हळू फेऱ्याslow-query log — ठरलेल्या वेळेपेक्षा जास्त वेळ घेतलेल्या प्रत्येक query ची यादीquery plan — database निवडतो तो मार्ग: सगळे वाचणे, की index वापरणेobservability — database आत्ता कसा चालला आहे ते दाखवणारे मीटर आणि logs
⏪ आधी
triage शिवाय app गुपचूप 500 मुलांसाठी 501 trips करते, आणि database कोसळेपर्यंत हळू query लपून राहते.
💡 काय
operations म्हणजे slow-query log आणि plans पाहणे, आणि record room on call जाण्याआधी N+1 सुधारणे.
⚙️ कसे
WHERE lower(name) = 'katrina' 812 ms मध्ये scan करतो; WHERE name = 'Katrina' आणि CREATE INDEX ON students(name) ला 0.3 ms लागतात.
🎯 का
एक JOIN सहा round trips ची जागा घेतो, आणि दर आठवड्याला सर्वात हळू 10 queries सुधारणे हेच बहुतेक काम आहे.
🚀 पुढे
खऱ्या teams on call असताना हीच checklist वापरतात, आणि slow-query log व metrics रोज पाहिले जातात.
🧪 Try it here — शाळा वाढते तशा फेऱ्या मोजा — मग दुरुस्त करा
कुलूपबंद रजिस्टर — SQL injection, parameters, least privilege, आणि transit मध्ये व at rest encryption.
🧒 सोप्या शब्दांत
login box तुमचा roll number विचारतो. तुम्ही टाइप केलेले app थेट आपल्या SQL मध्ये चिकटवत असेल, तर एखादा लबाड x' OR '1'='1 टाइप करतो, database त्याला command समजून पाळतो आणि सगळ्या मुलांची माहिती देतो. Parameters टाइप केलेला मजकूर बंद पाकिटात पाठवतात: नेहमी फक्त value, कधीच command नाही. प्रत्येक app ला फक्त गरजेच्या चाव्या मिळतात, आणि data प्रवासात व साठवताना कुलूपबंद असतो.
📖 नवे शब्दSQL injection — टाइप केलेला मजकूर SQL म्हणून चालवायला app ला फसवणेparameter (?) — जागा राखणारे चिन्ह; टाइप केलेली value वेगळी जाते, कधीच code म्हणून नाहीleast privilege — प्रत्येक app ला फक्त गरजेच्या permissions, जास्त काहीच नाहीencryption — data गुंडाळून टाकणे म्हणजे फक्त key असणारेच वाचू शकतात, प्रवासात आणि साठवताना
⏪ आधी
Apps टाइप केलेला मजकूर SQL string मध्ये जोडायचे, त्यामुळे login box मधूनच पूर्ण tables वाचता किंवा delete करता यायचे.
💡 काय
Database security: parameters SQL injection थांबवतात, प्रत्येक app ला फक्त गरजेचा pass मिळतो, आणि data encrypt असतो.
⚙️ कसे
Input ? ने पाठवा, string मध्ये जोडू नका; reports app ला read-only pass द्या; TLS आणि encryption at rest वापरा.
🎯 का
Demo मध्ये जोडलेल्या login ने सर्व 5 विद्यार्थी उघड केले आणि parameter ने एकही नाही — एका सवयीने पूर्ण हल्ला बंद.
🚀 पुढे
पुढे advanced SQL — आणि आता लिहिलेली प्रत्येक query parameters वापरते, app code मध्येही (L17).
🧪 Try it here — roll number ने login करा — मग त्याऐवजी SQL टाइप करा आणि प्रत्येक query काय करते ते पहा
एकही row न गमावता क्रम — subqueries, CTEs, window functions, views, आणि room मध्ये राहणारा code: functions आणि stored procedures.
🧒 सोप्या शब्दांत
शिक्षकांना प्रत्येक वर्गात क्रमवारी हवी आहे: 3A मध्ये Katrina पहिली, 3B मध्ये Meera पहिली. GROUP BY प्रत्येक वर्ग दाबून एका ओळीत करेल, पण window function प्रत्येक row ठेवून प्रत्येक मुलाला क्रमांक देते, आणि प्रत्येक वर्गासाठी पुन्हा 1 पासून सुरू करते. CTE म्हणजे नाव दिलेले कच्चे काम, जे आधी करून मग वापरता. Functions आणि stored procedures म्हणजे record room मध्येच साठवलेल्या कृती.
📖 नवे शब्दsubquery — मोठ्या प्रश्नाच्या आत एक छोटा प्रश्नCTE (WITH) — नाव दिलेला कच्च्या कामाचा निकाल, आधी बनवून मग त्यावर querywindow function — rows एकत्र न करता त्यांच्यावर क्रमांक किंवा चालू बेरीज देतेview — साठवलेला प्रश्न, ज्यावर table सारखी query करता येतेstored procedure — database मध्येच साठवलेला SQL steps चा संच, नावाने चालवतात
⏪ आधी
वर्गानुसार विद्यार्थ्यांचा क्रम लावायला rows code मध्ये आणून loop करावे लागायचे, किंवा GROUP BY जे rows दाबून टाकते.
💡 काय
Advanced SQL: subqueries, CTEs (WITH), RANK() आणि running totals सारखी window functions, आणि जतन केलेले प्रश्न (views).
⚙️ कसे
RANK() OVER (PARTITION BY class ORDER BY pts DESC) rank चा column जोडतो आणि प्रत्येक वर्गासाठी पुन्हा सुरू करतो, सर्व rows ठेवून.
🎯 का
Reports, leaderboards आणि 'सरासरीपेक्षा जास्त' याद्या code च्या loops ऐवजी room मधली एक query बनतात.
🚀 पुढे
पुढची पायरी: room मध्ये राहणारा code — SQL मधले function, आणि CALL केली जाणारी stored procedure, जेणेकरून प्रत्येक app एकच नियम पाळतो.
🧪 Try it here — एक window function आणि partition निवडा — अतिरिक्त column दिसताना पहा, प्रत्येक row कायम
🧪 Try it here — विद्यार्थ्याला हलवा — "एका वर्गात जास्तीत जास्त 3" हा नियम कुठे राहतो आणि कोण बोलावतो ते ठरवा
log आधी येतो — WAL, crash recovery, MVCC snapshots आणि vacuum.
🧒 सोप्या शब्दांत
काळजीपूर्वक काम करणारा clerk प्रत्येक बदल आधी डायरीत लिहितो, आणि मोठे register नंतर बदलतो. दिवे गेले तर शेवटच्या checkpoint पासून डायरी पुन्हा वाचली जाते, म्हणून ज्याला 'OK' सांगितले ते काहीच हरवत नाही. वाचणाऱ्यांना ते सुरू झाले तेव्हाचा register चा फोटो मिळतो, म्हणून लिहिणाऱ्यांना त्यांची वाट पाहावी लागत नाही. जुन्या आवृत्त्या फाडलेल्या पानांसारख्या साचतात, आणि vacuum त्या झाडून टाकतो.
📖 नवे शब्दWAL — write-ahead log: 'OK' सांगण्याआधी बदल डायरीत जातोcheckpoint — साठवलेली pages डायरीच्या बरोबरीला येतात तो क्षणMVCC — अनेक आवृत्त्या ठेवणे, म्हणजे प्रत्येक वाचणाऱ्याला स्थिर snapshot दिसतोvacuum — आता कोणालाच न लागणाऱ्या जुन्या row आवृत्त्या साफ करणे
⏪ आधी
Log नसताना लिहिताना वीज गेली तर pages अर्धवट बदललेली राहू शकत, आणि प्रत्येक reader ला प्रत्येक writer ची वाट पाहावी लागे.
💡 काय
Engine च्या आत: write-ahead log (WAL) commits टिकाऊ करतो, आणि MVCC प्रत्येक reader ला स्थिर snapshot देतो.
⚙️ कसे
Commit आधी WAL मध्ये जोडला जाऊन disk वर flush होतो, मगच OK; pages नंतर checkpoint ला data file मध्ये जातात.
🎯 का
WAL mode मध्ये writer ने 'Aishwarya S' commit केले तेव्हा reader ला अजून 'Aishwarya' दिसत होते — या वेळी 'database is locked' नाही.
🚀 पुढे
हाच log L16 मध्ये replicas stream करतात आणि L18 मध्ये CDC tools वाचतात — WAL म्हणजे room ची डायरी.
🧪 Try it here — एक वाचणारा, एक लिहिणारा — दोन्ही journal modes मध्ये करून पहा
खोलीच्या प्रती — log चा प्रवाह, lag, sync विरुद्ध async, failover आणि CAP trade-off.
🧒 सोप्या शब्दांत
मुख्य record room आपली बदलांची डायरी copy rooms ना पाठवते; त्या अद्ययावत राहतात पण थोड्या मागे, उदा. 0.2 किंवा 3 seconds. पालकांनी Diya चे नाव नोंदवून मागे पडलेल्या copy मधून वाचले, तर Diya गायब वाटते. मुख्य room बंद पडली तर एक copy काम हाती घेते. async मध्ये शेवटचे काही बदल हरवू शकतात; sync मध्ये प्रत्येक commit copy च्या 'मिळाले' ची वाट पाहतो, म्हणून काही हरवत नाही पण writes हळू होतात.
📖 नवे शब्दprimary — सगळे writes स्वीकारणारी एकमेव roomreplica — बदलांचा log मिळवणारी आणि वाचण्यासाठी वापरली जाणारी copylag — replica किती seconds मागे आहेfailover — primary बंद पडल्यावर replica ला नवा primary बनवणेsync vs async — OK सांगण्याआधी copy ची वाट पाहा, की आधी OK सांगा (जलद, थोडे हरवू शकते)
⏪ आधी
एकमेव standby म्हणजे कालच्या रात्रीचा backup, त्यामुळे server गेला की तासन्तास बंद आणि एक दिवसाचे writes गमावले.
💡 काय
Replication primary चा log replicas कडे stream करते; primary मेला की failover एका replica ला primary बनवतो.
⚙️ कसे
Async: COMMIT लगेच परत येतो आणि log मागून जातो; sync: COMMIT replica च्या 'मिळाले' ची वाट पाहतो.
🎯 का
Demo मध्ये async failover मध्ये Ishaan चे admission हरवले, आणि replica वर Diya दिसली नाही — lag आणि RPO प्रत्यक्ष.
🚀 पुढे
Managed databases (AWS L17) हे तुमच्यासाठी चालवतात; तरी sync की async ते तुम्ही ठरवता आणि स्वतःचे writes primary वरून वाचता.
🧪 Try it here — एका विद्यार्थ्याची नोंदणी करा, replica मधून वाचा, मग primary मारा
app ची बाजू — pools, transactions, parameters, batching, backoff सह retries, आणि ORMs.
🧒 सोप्या शब्दांत
एका वर्गात काही pens वाटून वापरतात: प्रत्येक विद्यार्थी एक घेतो, लिहितो, आणि परत देतो. app database connections असेच वाटून वापरते: प्रत्येक request pool मधून एक घेते, एक छोटा transaction करते, आणि परत देते. 2,000 rows एकेक करून save करायला 513 ms लागले; एका transaction मध्ये 1 ms, कारण प्रत्येक commit म्हणजे disk ची एक फेरी. database 'locked' म्हणाला तर थोडे थांबा, पुन्हा प्रयत्न करा, आणि प्रत्येक वेळी जास्त थांबा.
📖 नवे शब्दconnection pool — सगळ्या requests मध्ये वाटलेली काही उघडी connections, घेऊन परत दिली जाणारीbatching — प्रत्येक row ला वेगळा commit न करता अनेक rows एका transaction मध्ये save करणेretry with backoff — थोडे थांबून पुन्हा प्रयत्न, प्रत्येक वेळी जास्त थांबणेORM — तुमच्या code मधील objects वरून तुमच्यासाठी SQL लिहिणारी library
⏪ आधी
Apps प्रत्येक request ला नवे connection उघडायचे, प्रत्येक row commit करायचे, input SQL मध्ये जोडायचे आणि पहिल्या lock ला कोसळायचे.
💡 काय
App ची बाजू: pool मधून connection घ्या, प्रत्येक request ला एक छोटा transaction, parameters, batch writes आणि सुरक्षित retries.
⚙️ कसे
with conn: BEGIN आणि COMMIT गुंडाळतो, executemany rows एकत्र पाठवतो, आणि locked write 50, 100, 200 ms नंतर पुन्हा प्रयत्न करतो.
🎯 का
2,000 inserts ला प्रत्येक row commit केल्यावर 513 ms आणि एका transaction मध्ये 1 ms लागले — प्रत्येक COMMIT disk ची वाट पाहतो.
🚀 पुढे
ORM हे SQL तुमच्यासाठी लिहितो — तरी N+1 (L12) साठी queries ची संख्या आणि transaction च्या सीमा पाहत राहा.
🧪 Try it here — writes batch करा, मग retries वापरून locked खोलीतून तगून रहा
कार्यालय आणि संग्रहालय — warehouses, रात्रीचा ETL, columnar storage, आणि trigger वापरून CDC.
🧒 सोप्या शब्दांत
शाळेचे office दिवसभर अनेक छोटी कामे करते: Katrina ची हजेरी लावा, Rohan चे grades दाखवा. तिथे कोणी 'महिन्यानुसार हजेरी' असा मोठा report चालवला, तर सगळ्यांना थांबावे लागते. म्हणून दर रात्री नोंदी मोठ्या प्रश्नांसाठी बनवलेल्या archive मध्ये copy होतात; तिथे प्रत्येक column एकत्र साठवलेला असतो आणि उत्तर क्षणात मिळते. CDC म्हणजे office लिहिते ती बदलांची डायरी, म्हणजे archive प्रत्येक बदलाबरोबर राहू शकतो.
📖 नवे शब्दOLTP — चालू system: अनेक छोटे, जलद reads आणि writesOLAP — विश्लेषणाची system: अनेक rows वर काही मोठे प्रश्नETL — data बाहेर काढा, आकार बदला, आणि warehouse मध्ये भरा, उदा. दर रात्रीcolumnar — प्रत्येक column एकत्र साठवणे, एका column वरच्या बेरजेसाठी जलदCDC — प्रत्येक बदल होताक्षणी टिपणे, म्हणजे दुसरी system मागोमाग राहू शकते
⏪ आधी
महिनाअखेरचे reports live database वर चालायचे, आणि कोणी dashboard उघडला की कार्यालय अडकायचे.
💡 काय
OLTP म्हणजे छोट्या reads आणि writes चे गजबजलेले कार्यालय; OLAP म्हणजे मोठ्या प्रश्नांसाठी बांधलेले archive, बहुतेक columnar.
⚙️ कसे
रात्रीचा ETL summary tables बनवतो, आणि trigger (CDC) प्रत्येक grade बदल warehouse साठी डायरीत लिहितो.
🎯 का
Attendance report ला 200,000 live ओळींवर 29.3 ms आणि 12 ओळींच्या summary वर 0.08 ms लागले — उत्तर तेच.
🚀 पुढे
खरे warehouses (BigQuery, Redshift, ClickHouse) आणि CDC tools (Debezium, DMS) WAL वाचून हेच मोठ्या प्रमाणावर करतात.
🧪 Try it here — report चालू खोलीवर चालवा, मग warehouse करतो तसा