🤖 ArgoCD शाळेच्या पद्धतीने शिका — GitOps सह & शिवाय
Learn Kubernetes School चा भावंड-कोर्स: तो शिकवतो तुमचे ॲप काय चालवते — हा शिकवतो ते काय deploy करते आणि प्रामाणिक ठेवते. तुम्ही तेच डेमो ॲप तीन प्रकारे deploy करता — हाताने, CI/CD push pipeline ने, आणि ArgoCD ने — आणि प्रत्येक पुढची पायरी का आहे हे नेमके अनुभवता.
🚪 भाग 1 — ArgoCD शिवाय
- हाताने deploy करा — आणि काय deploy केले ते विसरा
- configuration drift ला भेटा, मूक मारेकरी
- push pipeline ने automate करा (कुरिअर रोबोट 📮)
- …आणि push जे अजूनही दुरुस्त करू शकत नाही ते शोधा
📖 भाग 2 — ArgoCD सह
- git सत्याचा एकमेव स्रोत बनतो
- केअरटेकर रोबोट 🤖 cluster च्या आत राहतो
- drift परत फिरवला जातो; deploy = commits
- rollback =
git revert· इतिहास = git + ArgoCD sync history
🗺️ संपूर्ण चित्र — एक आकृती, दोन्ही जगे
संपूर्ण कोर्स एका कॅनव्हासवर: PUSH जग (लाल, धडे 1–4) त्याच्या चार त्रुटींसह, आणि PULL जग (हिरवे, धडे 5–12) त्याच्या सहा विजयांसह. 4K आवृत्तीसाठी क्लिक करा — wallpaper-आकाराच्या संदर्भासाठी उत्तम.
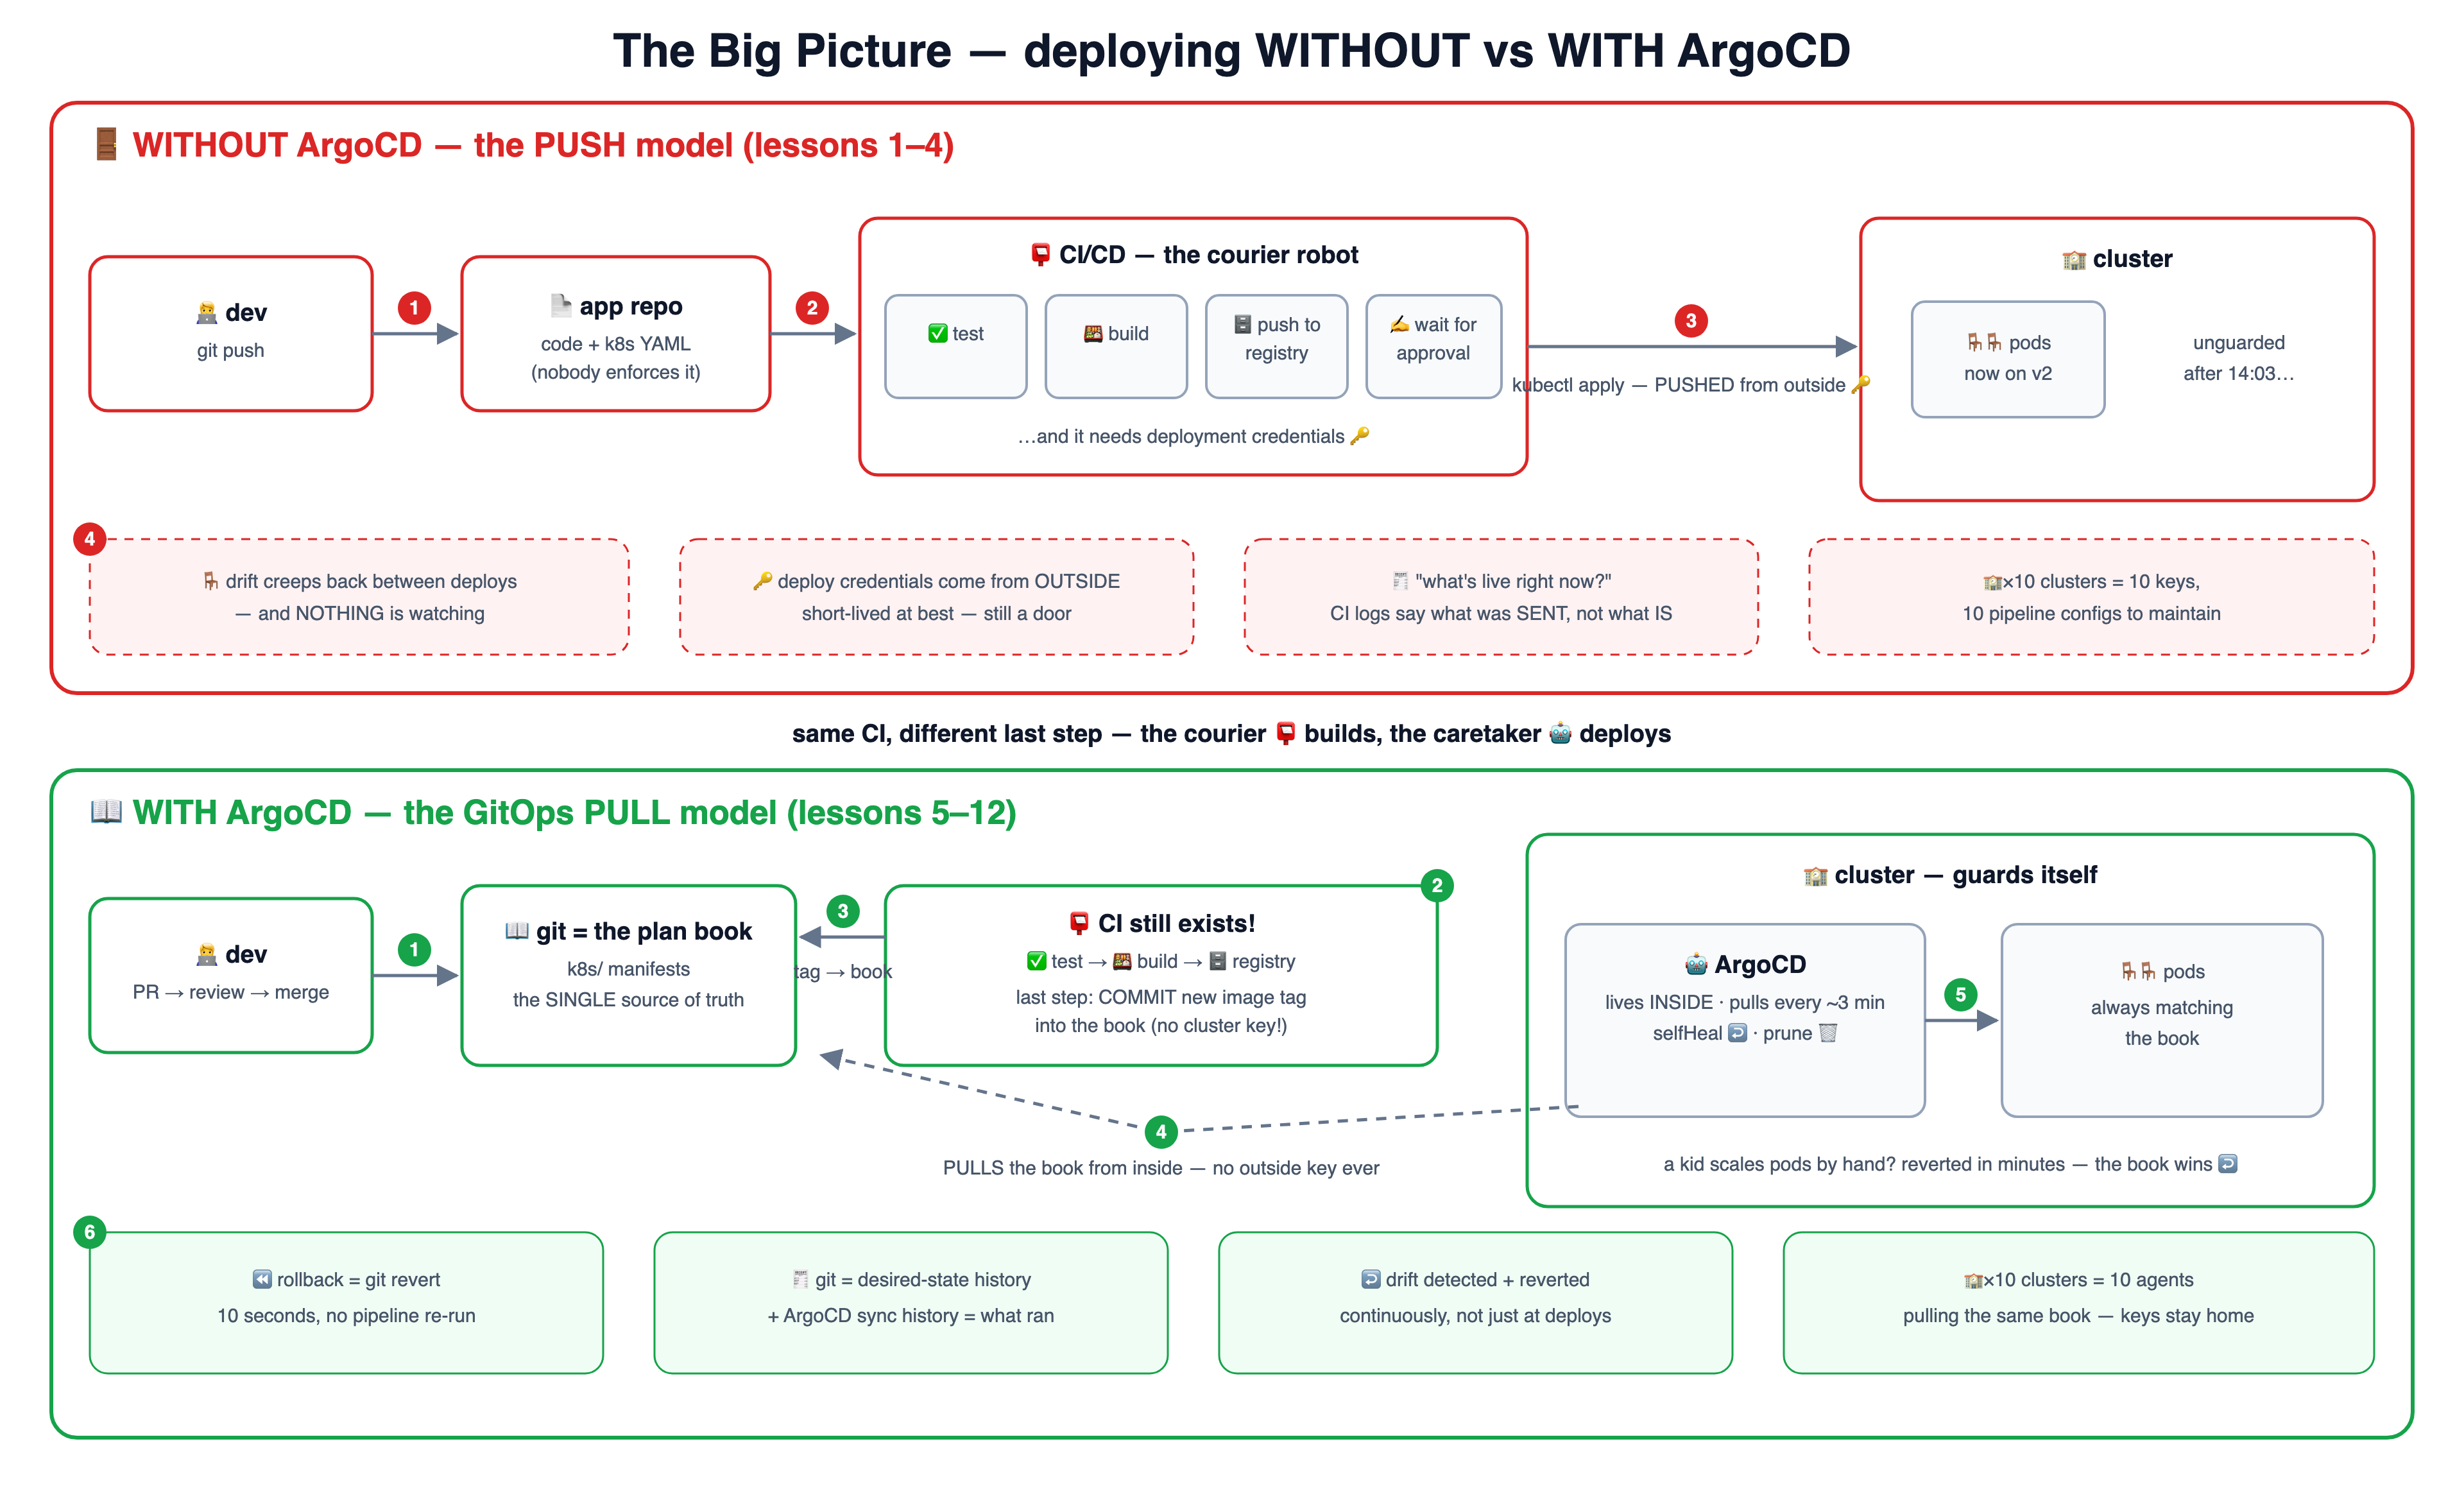
bash scripts/check-setup.sh (kubectl context, nodes Ready, namespace तयार करण्याची परवानगी, ऐच्छिक argocd CLI). AWS / Docker / Kubernetes शाळांतून येताय? 🗺️ उपमांचा नकाशा उघडा ठेवा. CI/CD शाळा हा कुरिअर रोबोटचा स्वतःचा कोर्स — इथले धडे 03–04 त्याच्या OIDC धड्याचा संदर्भ देतात.🚪 भाग 1 — ArgoCD शिवाय (धडे 1–4)
आधी वेदना अनुभवा: हाताने deploy, अदृश्य drift, मग कुरिअर रोबोट (CI/CD push) — आणि तो कधीच बुजवू न शकणाऱ्या चार त्रुटी. एक git ब्रँच = एक कल्पना; ब्रँच 07 मध्ये धडे 01–07 आहेत.
🎒 हाताने deploy
lesson-01-deploy-by-handधडा वाचा →आकृती पहा ↗🪑 drift ची समस्या
lesson-02-drift-problemधडा वाचा →आकृती पहा ↗📮 CI/CD push pipeline
lesson-03-cicd-pushधडा वाचा →आकृती पहा ↗🚪 push च्या मर्यादा
lesson-04-limits-of-pushधडा वाचा →आकृती पहा ↗🚪 Push चे चार खड्डे — आणि भाग 2 प्रत्येक कुठे बुजवतो
धडा 04 हा कोर्सचा बिजागर आहे. चार आकडे लक्षात ठेवा; भाग 2 चा प्रत्येक धडा एक खड्डा बुजवतो.
| # | खड्डा | कसे जाणवते | बुजवला जातो |
|---|---|---|---|
| 1 | Deploy मधल्या काळातला drift अदृश्य असतो | कुरिअर 14:03 ला पोहोचवतो आणि निघून जातो; एक मूल 15:00 ला खुर्च्या हलवते; पुढच्या push पर्यंत कोणालाच कळत नाही | धडा 09 — selfHeal |
| 2 | Deployment credentials बाहेरून मिळवावी लागतात | कुरिअरला आत जायचा मार्ग लागतो — वाईटात वाईट साठवलेला kubeconfig, उत्तम म्हणजे अल्पायुषी OIDC बॅज, पण दोन्ही प्रकारे रस्त्यावरून उघडणारे दार | धडा 07 — रोबोट आतून खेचतो |
| 3 | प्रत्येक जादा cluster किल्ल्या आणि pipelines दुप्पट करतो | दहा शाळा, व्हॅनमध्ये दहा किल्ल्या, फिरवायचे दहा pipeline configs | धडा 11 — एक वही, प्रत्येक cluster ला एक रोबोट, app-of-apps |
| 4 | डिलिव्हरीची नोंद म्हणजे प्रत्यक्ष सत्य नव्हे | CI इतिहास सांगतो काय पाठवले, आत्ता काय चालू आहे ते नाही | धडा 10 — Synced = खोली पानाशी जुळते; sync history सांगते कधी |
📊 गुणपत्रक — हाताने · CI/CD push · ArgoCD pull
छोटी आवृत्ती, म्हणजे शिकताना गुण मोजता येतील. पूर्ण आवृत्ती टिप्पण्यांसह धडा 12 मध्ये — आणि आठवण: प्रौढ रचनेत दोन्ही रोबोट असतात: CI अजूनही तपासतो आणि बांधतो, ArgoCD deploy करतो.
| 🎒 हाताने | 📮 CI/CD push | 🤖 GitOps pull (ArgoCD) | |
|---|---|---|---|
| पुन्हा-पुन्हा तसेच deploy | ❌ तुमची स्मरणशक्ती | ✅ pipeline | ✅ reconcile लूप |
| Deploy मधल्या काळातला drift | 😱 अदृश्य | ❌ अदृश्य | ✅ ओळखला, मिनिटांत परत फिरवला |
| Deployment credentials | 🔑 प्रत्येक लॅपटॉप | ⚠️ बाहेरून मिळवलेली (OIDC सह अल्पायुषी) | ✅ cluster बाहेर कधीच जात नाहीत |
| "आत्ता काय चालू आहे?" | 🤷 | ⚠️ CI ने जे पाठवले ते | ✅ वही — Synced म्हणजे जुळते |
| Rollback | आठवणीतून पुन्हा रंगवा | ⚠️ जुनी pipeline पुन्हा चालवा | ✅ git revert |
| इतिहास | shell history | ⚠️ CI logs | ✅ git (इच्छित) + ArgoCD sync history (प्रत्यक्ष) |
| 10 clusters | ❌ 10× त्रास | ❌ CI मध्ये 10 credentials | ✅ 10 रोबोट, तीच वही |
📖 भाग 2 — ArgoCD सह (धडे 5–12)
उपाय: git मुख्य प्लॅन-वही बनते, आणि ArgoCD — cluster च्या आत राहणारा केअरटेकर रोबोट — वास्तव तिच्याशी कायम जुळते ठेवतो.
📖 GitOps ची कल्पना
lesson-05-gitops-ideaधडा वाचा →आकृती पहा ↗🤖 ArgoCD install करा
lesson-06-install-argocdधडा वाचा →आकृती पहा ↗📄 पहिले Application
lesson-07-first-applicationधडा वाचा →आकृती पहा ↗📏 Sync policies
lesson-08-sync-policiesधडा वाचा →आकृती पहा ↗🪑↩️ Self-heal & drift
lesson-09-self-heal-driftधडा वाचा →आकृती पहा ↗⏪ Rollback & इतिहास
lesson-10-rollback-historyधडा वाचा →आकृती पहा ↗📚 Helm, Kustomize & envs
lesson-11-helm-kustomize-envsधडा वाचा →आकृती पहा ↗🔑 Secrets + गुणपत्रक
lesson-12-secrets-and-compareधडा वाचा →आकृती पहा ↗kubectl scale --replicas=10 चालवतो. selfHeal चालू असताना काय होते? आणि बंद असताना? (2) एक चुकीचा image tag git मार्गे prod मध्ये पोहोचला. शुद्ध GitOps रचनेत तो परत फिरवा — आणि UI चे Rollback बटण टिकाऊ उपाय का नाही? (3) CI ला आता cluster मध्ये जायचा मार्ग अजिबात का लागत नाही — आणि CI अजूनही काय करतो? (4) Push विरुद्ध pull, प्रत्येकी एक वाक्य — आणि चार खड्ड्यांपैकी कोणता प्रत्येकजण उघडा ठेवतो? (5) git मधून एक resource हटवला पण अजून चालू आहे. कोणते dial बंद आहे, आणि ते चालू करण्याचा धोका काय? (6) Git इतिहास विरुद्ध ArgoCD sync history — "आत्ता काय चालू आहे?" कोण सांगते आणि "कोणी मागितले?" कोण?# take the course locally (any local cluster — Docker Desktop, minikube, kind):
git clone https://github.com/BaluRaut/learn-argocd-school.git
cd learn-argocd-school
git checkout lesson-01-deploy-by-hand # then open lessons/01-deploy-by-hand/README.md📐 धड्यांच्या आकृत्या — क्रमांक अनुसरा
प्रत्येक धडा एका क्रमांकित बॉक्स-आणि-बाण आकृतीत, एकामागून एक — इथेच वाचता येईल (लाल = ArgoCD शिवाय, हिरवे = सह). स्वतंत्र पानावरही, उडी-मारण्याच्या दुव्यांसह.
1 🎒 हाताने deploy — तुम्हीच deploy प्रणाली आहात
तुमच्या लॅपटॉपवरून kubectl apply चालते… आणि गुपचूप तुम्हाला single point of failure बनवते.
कल्पना करा, शाळेच्या सूचना-फलकाची किल्ली फक्त तुमच्याकडे आहे आणि तुम्ही कोणतीही नोंद न ठेवता आठवणीने सूचना लावता. आज ते चालते, पण तुम्ही सुट्टीवर गेलात की फलकावर काय आहे किंवा ते कसे परत करायचे हे कोणालाच कळत नाही. Laptop वरून kubectl apply चालवणे तसेच आहे: live काय आहे याची एकमेव नोंद तुमची terminal history, आणि production च्या keys तुमच्या laptop वर.
कोणत्याही automation आधी तुम्ही स्वतःच्या laptop वरून kubectl apply -f k8s/ चालवायचा आणि ते आज तरी चालायचे.
हाताने deploy करणे म्हणजे तुम्हीच deploy system आहात: production च्या keys तुमच्या laptop कडे असतात.
kubectl ~/.kube/config वाचतो आणि YAML apply करतो; काय live आहे याची एकमेव नोंद म्हणजे तुमची terminal history.
आठवड्यानंतर कोणीच सांगू शकत नाही की कोणते version live आहे, ते कोणी बदलले, किंवा मंगळवारच्या स्थितीत परत कसे जायचे.
पुढे यातून निर्माण होणारा छुपा धोका पाहाल: drift, जेव्हा cluster git मधील files शी जुळणे थांबवतो.
2 🪑 Drift — जेव्हा वास्तव फाइल्सशी जुळेनासे होते
git मध्ये परत न जाणारा प्रत्येक हाताने केलेला बदल एक मूक, धोकादायक दरी रुंदावतो.
बैठक-वहीत खोलीत 2 खुर्च्या असे लिहिले आहे, पण शुक्रवारी कोणीतरी आणखी 3 आणल्या आणि वही कधी बदलली नाही. आता वही आणि खोली जुळत नाहीत, आणि मंगळवारी कोणी वहीप्रमाणे खोली लावली की जास्तीच्या खुर्च्या नाहीशा होतात. ही तफावत म्हणजे drift: git म्हणते replicas: 2, cluster मध्ये 5 चालतात, कारण हाताने केलेला बदल git मध्ये परत लिहिलाच नाही.
शुक्रवारी 18:00 वाजता कोणी "फक्त एकदाच" हाताने hotfix करतो, आणि कोणीच ते परत git मध्ये लिहीत नाही.
Drift म्हणजे पुस्तक आणि वर्गखोल्या यांतील फरक: git म्हणते replicas: 2, cluster प्रत्यक्षात 5 चालवतो.
kubectl diff -f k8s/ हा फरक ओळीओळीने दाखवतो, जसे replicas 5 विरुद्ध 2 आणि hotfix image tag.
मंगळवारी git मधून केलेला "clean" deploy शांतपणे hotfix पुसून टाकतो, कारण प्रत्येक हाताने केलेला बदल फरक वाढवतो.
लोक आधी जो उपाय वापरतात तो म्हणजे प्रत्येक push वर तुमच्यासाठी deploy करणारा CI/CD robot; तो पुढे आहे.
3 📮 CI/CD push — कुरिअर रोबोट तुमच्यासाठी deploy करतो
प्रत्येक push तपासला, बांधला आणि पोहोचवला जातो — माणूस लूपच्या बाहेर (बहुतेक).
तुम्ही स्वतः फलकाकडे जाण्याऐवजी, प्रत्येक नवी सूचना लिहिली की courier robot फेरी मारतो: तो ती तपासतो, copy करतो आणि फलकावर लावतो. हे आहे CI/CD push: प्रत्येक git push test होतो, build होतो आणि kubectl apply ने deploy होतो, दर वेळी त्याच पद्धतीने. आता कोणत्याही laptop वर keys नाहीत, पण त्या robot कडे आहेत, आणि तो शाळेबाहेर राहतो.
हाताने deploy करताना चुका सहज व्हायच्या: कोणी tests विसरतो, किंवा laptop वरील जुन्या copy मधून deploy करतो.
CI/CD push म्हणजे cluster बाहेरचा courier robot, जो test, build, image push आणि deploy करतो.
git push वर तो test, build, push image आणि kubectl apply चालवतो, cluster credentials घेऊन आत जातो.
प्रत्येक deploy तपासलेला आणि पुन्हा करता येणारा असतो, कोणता commit deploy झाला ते git सांगते, आणि laptop कडे keys नसतात.
तरीही प्रश्न उरतात: दोन push च्या मध्ये कोण लक्ष ठेवते, आणि pipeline कडे production keys का असाव्यात?
4 🚪 push च्या मर्यादा — कुरिअर पोहोचवतो आणि निघून जातो
push pipeline क्षण deploy करते; मधल्या काळात स्थितीवर कोणी पहारा देत नाही.
Courier सूचना लावतो आणि निघून जातो. दोन फेऱ्यांमध्ये फलकावर कोणाचेच लक्ष नसते, म्हणून शुक्रवारी कोणी हाताने सूचना बदलली तर ती पुढच्या delivery पर्यंत चुकीचीच राहते. आणि courier कडे प्रत्येक शाळेच्या keys असल्याने courier कडून चोरी करणे मोठे बक्षीस ठरते. दहा शाळा म्हणजे दहा keys घेतलेले दहा couriers. उपाय: शाळेतच राहणारा पहारेकरी.
Courier ने 14:03 ला deploy केले आणि निघून गेला; शुक्रवारपर्यंत kubectl edit ने cluster बदलला आणि कोणाच्या लक्षात आले नाही.
Push ची मर्यादा: pipeline फक्त क्षणी deploy करते, आणि मधल्या काळात स्थितीवर कोणीच पहारा देत नाही.
CI बाहेरून keys घेऊन आत पोहोचते, आणि दहा clusters साठी दहा pipelines लागतात, प्रत्येकीची स्वतःची key आणि YAML.
CI production बदलू शकते म्हणून CI स्वतःच attackers चे लक्ष्य बनते, आणि drift न दिसता वाढत राहतो.
उपाय चांगला courier नाही, तर शाळेच्या आतच राहणारा पहारेकरी आहे, आणि इथून Part 2 सुरू होतो.
5 📖 GitOps ची कल्पना — वास्तव वहीशी जुळलेच पाहिजे
इच्छित स्थिती git मध्ये जाहीर करा; cluster च्या आतला एजंट वास्तव तिच्याकडे नेतो, कायम.
शाळेत एक अधिकृत वही असते जी प्रत्येक खुर्ची कुठे हवी ते सांगते, आणि शाळेतच राहणारा काळजीवाहक दर काही मिनिटांनी खोल्या तपासून जागा सोडलेले सगळे परत लावतो. हे आहे GitOps: git म्हणजे तुम्हाला काय हवे त्याची वही, आणि cluster मधला agent खरा cluster त्याच्याशी जुळवत राहतो, कायम. तो आतून git वाचायला बाहेर जातो, म्हणून cluster च्या keys कधीच बाहेर जात नाहीत.
Push मध्ये cluster फक्त deploy च्या क्षणी git शी जुळायचा, आणि keys CI कडे बाहेर द्याव्या लागायच्या.
GitOps म्हणजे git हे अपेक्षित स्थितीचे पुस्तक आहे, आणि cluster मधील agent वास्तव त्याच्याशी जुळवतो.
Agent सतत फिरत राहतो: पुस्तक वाचा, खोल्या पाहा, कोणताही फरक दुरुस्त करा, सुमारे 3 min थांबा, कायम.
तो आतूनच git मधून pull करतो, म्हणून cluster keys बाहेर जात नाहीत, आणि फक्त review झालेले PRs चालणारे बदलतात.
हा Kubernetes सारखाच reconcile loop आहे, एक पातळी वर; पुढे तो चालवण्यासाठी ArgoCD install कराल.
6 🤖 ArgoCD install करा — रोबोट शाळेत राहायला येतो
एक kubectl apply संपूर्ण रोबोट install करते; UI म्हणजे त्याच्या डोक्यात डोकावण्याची खिडकी.
काळजीवाहक काम सुरू करण्याआधी त्याला शाळेत एक खोली हवी. एका kubectl apply ने ArgoCD त्याच्या स्वतःच्या namespace मध्ये, argocd मध्ये, install होतो: git वाचणारा भाग, तपासणीचा loop चालवणारा भाग, आणि web page असलेला server. Port-forward ने ते web page उघडता आणि admin म्हणून login करून robot च्या डोक्यात डोकावता.
GitOps कल्पनेला cluster मध्ये राहणारा खरा agent लागतो, आणि आतापर्यंत तसा कोणी नव्हता.
ArgoCD हाच robot आहे: तो स्वतःच्या खोलीत, argocd namespace मध्ये राहायला येतो आणि तुमच्या apps वर लक्ष ठेवतो.
kubectl apply -n argocd -f install.yaml argocd-server, repo-server आणि application-controller सुरू करते.
port-forward svc/argocd-server 8080:443 करून admin म्हणून login करा आणि UI मध्ये robot च्या डोक्यात पाहा.
Install झालेला robot plan book च्या पहिल्या पानाची वाट पाहतो: Application, जे पुढे आहे.
7 📄 पहिले Application — प्लॅन-वहीचे एक पान
Application सांगते: हा रेपो, हा फोल्डर, हे लक्ष्य. बाकी रोबोट करतो.
काळजीवाहकाला सूचनांचे पान हवे: कोणती वही, कोणता धडा, कोणती खोली. Application हे तेच पान आहे: हा git repo, हा folder (k8s/), हा namespace. ArgoCD तो folder वाचून लागू करतो. तेव्हापासून तुम्ही ॲपसाठी कधीच kubectl apply चालवत नाही; तुम्ही pull request merge करता, आणि बाकी robot करतो. Cluster git शी जुळला की UI मध्ये Synced दिसते.
ArgoCD install असूनही ॲप cluster मध्ये टाकण्यासाठी तुम्ही अजून स्वतः kubectl apply चालवत होता.
Application म्हणजे plan book चे एक पान: हीच repo, हाच folder, हेच destination.
repoURL, path: k8s/ आणि targetRevision: main source सांगतात; ArgoCD ते render करून gitops-school namespace मध्ये लावतो.
आतापासून तुम्ही PR merge करता आणि robot तो apply करतो, तर UI Synced किंवा OutOfSync आणि Healthy दाखवते.
पुढे robot पुस्तक किती काटेकोरपणे पाळतो ते ठरवाल: manual, automated, prune आणि selfHeal.
8 📏 Sync policies — रोबोट वही किती काटेकोर पाळतो
Manual = आधी विचारतो. Automated = कृती करतो. Prune आणि selfHeal काटेकोरपणा वाढवतात.
काही काळजीवाहक काहीही हलवण्याआधी विचारतात; काही थेट दुरुस्त करतात. Sync policy ArgoCD किती कडक असावा ते ठरवते. Manual: तो OutOfSync दाखवतो आणि तुम्ही Sync click करेपर्यंत थांबतो. Automated: तो git मधले बदल स्वतः लागू करतो. selfHeal हाताने केलेले बदलही उलटवतो, आणि prune git मधून काढलेल्या गोष्टीही delete करतो. Prune default ला बंद असतो, कारण तो कोणी हाताने बनवलेल्या गोष्टीही delete करेल.
Policy शिवाय robot आधी विचारेल की थेट करेल, किंवा delete केलेल्या गोष्टी कशा हाताळेल हे निवडता येत नव्हते.
Sync policy म्हणजे काटेकोरपणाचा dial: manual, मग automated, मग selfHeal, मग prune.
Manual तुम्ही Sync click करेपर्यंत थांबते; automated स्वतः करते; prune git मधून गेलेले delete करते; selfHeal हाताचे बदल उलटवते.
Prune default ने बंद असते कारण ते कोणी हाताने बनवलेल्या गोष्टीही काढते, म्हणून ते विचारपूर्वक चालू करा.
शिकताना manual ने सुरुवात करा; पुढे कोणी खोली बदलली की selfHeal खुर्च्या परत कशा लावतो ते पाहाल.
9 🪑↩️ Self-heal — खुर्च्या वही सांगते तिथे परत जातात
हाताने केलेला drift सेकंद टिकतो, महिने नाही. खोली नव्हे, वही बदला.
एखाद्या विद्यार्थ्याने खोलीत जास्तीच्या खुर्च्या आणल्या, तर काळजीवाहकाला काही सेकंदांत कळते आणि तो त्या वहीत लिहिल्याप्रमाणे परत लावतो. selfHeal सोबत ArgoCD तेच करतो: कोणी हाताने 5 पर्यंत scale केले, तर सुमारे 25 सेकंदांत ते परत 2 होते. खरोखर 5 हवे असतील, तर वही बदला: YAML edit करा, review घ्या, merge करा, आणि robot आनंदाने scale up करतो.
हाताने केलेला kubectl scale --replicas=5 cluster मध्ये महिनोन्महिने कोणाच्या लक्षात न येता राहू शकायचा.
Self-heal म्हणजे कोणी खुर्च्या हलवल्या की robot त्या पुस्तकात लिहिल्याप्रमाणे परत लावतो.
10:01 ला कोणी 5 पर्यंत scale करतो, 10:01:20 ला ArgoCD OutOfSync दाखवतो, आणि 10:01:25 ला पुस्तक पुन्हा apply करतो.
हाताने केलेला drift महिने नाही, काही सेकंदच टिकतो, आणि खरा बदल git मधून जातो: reviewed, recorded, reversible.
खरोखर 5 replicas हवे? PR मधून पुस्तक बदला; पुढे पाहाल की git वाईट deploys ही उलटवते.
10 ⏪ Rollback — वही कालच्या पानावर उलटा
GitOps मध्ये git इतिहास हाच deploy इतिहास — म्हणून commit मागे घेणे म्हणजे deploy मागे घेणे.
आजच्या सूचनेत चूक असेल, तर वहीचे पान कालच्या पानावर उलटवा. GitOps मध्ये git history म्हणजेच deploy history: वाईट version एका commit मधून आले, म्हणून git revert ते उलटवणारा नवा commit बनवतो. तुम्ही push करता, ArgoCD सुमारे 3 मिनिटांत, किंवा Sync click केल्यास लगेच, sync करतो, आणि cluster परत जुन्या version वर येतो.
Rollback म्हणजे जुना pipeline run शोधणे किंवा आधी कोणते version live होते ते आठवणे असायचे.
GitOps मध्ये git history हीच deploy history आहे, म्हणून rollback म्हणजे पुस्तक कालच्या पानावर उलटवणे.
git revert B && git push image v1 सह commit C बनवते; ArgoCD ते सुमारे 3 min मध्ये sync करतो, किंवा Sync click करा.
वाईट version commit मधून आले, म्हणून commit उलटवला की deploy उलटतो, आणि git हेच सत्य राहते.
पुढे हे एका app वरून अनेक खोल्यांपर्यंत वाढवाल: Helm किंवा Kustomize ने एकाच recipe मधून dev, staging आणि prod.
11 📚 Helm, Kustomize & environments — एक पाककृती, अनेक वर्ग
Templates + प्रत्येक environment ची values; प्रत्येक खोलीसाठी एक Application, आणि सगळ्यांची यादी करणारे एक मुख्य पान.
शिक्षक एकच पाठ-योजना लिहितात आणि प्रत्येक वर्गासाठी फक्त आकडे बदलतात: इथे 20 बाक, तिथे 40. Helm आणि Kustomize तसेच चालतात: ॲपसाठी एकच recipe, आणि प्रत्येक environment साठी छोट्या value files, उदा. dev मध्ये 1 replica, staging मध्ये 2, prod मध्ये 5. प्रत्येक खोलीला स्वतःचे Application मिळते, आणि एक root Application, म्हणजे app of apps, त्या सगळ्यांची यादी ठेवते.
dev, staging आणि prod साठी YAML copy केल्याने प्रत्येक copy हळूहळू आकारात वेगळी होत जायची.
Helm किंवा Kustomize म्हणजे प्रत्येक environment च्या values सह एक recipe, आणि app of apps प्रत्येक Application ची यादी करते.
values-dev.yaml replicas: 1 ठेवते, staging 2, prod 5 + HPA; path: apps/ वरचे root Application तिन्ही सूचीबद्ध करते.
Recipe एकदाच लिहिली जाते आणि फक्त values वेगळ्या असतात, म्हणून environments आकारात कधीच वेगळ्या होत नाहीत.
एक गोष्ट अजूनही git मध्ये plain text म्हणून ठेवता येत नाही: secrets, ज्यांचा उपाय शेवटच्या धड्यात आहे.
12 🔑 GitOps मधील Secrets + अंतिम गुणपत्रक
सगळे git मध्ये राहते… plaintext secrets सोडून. ते encrypt करून आत ठेवा, किंवा बाहेरचा संदर्भ द्या.
Locker चा combination तुम्ही वर्गाच्या हजेरी-पटात कधीच लिहिणार नाही, कारण तो पट उघडणाऱ्या प्रत्येकाला तो कायमचा दिसतो. Git तसेच आहे: git मधला साधा password त्याच्या history मध्ये कायमचा उघड राहतो. म्हणून एकतर आत टाकण्याआधी तो बंद करा (Sealed Secrets: फक्त cluster तो उघडू शकतो), किंवा फक्त तो कुठे ठेवला आहे ते लिहा (External Secrets: vault कडे निर्देश).
DB_PASSWORD: hunter2 git मध्ये टाकले म्हणजे ते कायमचे leak झाले, कारण git history ते जपून ठेवते.
Plaintext secrets सोडून सगळे git मध्ये राहते: त्यांना encrypt करून आत ठेवा, किंवा बाहेरून reference करा.
Sealed Secrets फक्त cluster उघडू शकेल असा encryptedData ठेवतात; External Secrets AWS SM कडे remoteRef ठेवतात.
Scorecard: pull दर ~3 मिनिटांनी drift तपासतो, keys आतच ठेवतो, आणि git log लाच deploy log बनवतो.
परिपक्व setup दोन्ही robots वापरतो: CI image build करून ठेवते, आणि ArgoCD cluster ला git शी जुळलेला ठेवतो.