🗺️ व्हेक्टर डेटाबेस शाळेच्या पद्धतीने शिका
अर्थानुसार लावलेले ग्रंथालय — semantic search, RAG आणि एजंट स्मरणाखालचे यंत्र. शाळेच्या पद्धतीने शिकवलेले: रेपोमध्ये खरा मिनी व्हेक्टर DB (~70 ओळी, शुद्ध Python, शून्य अवलंबित्व) जो तुम्ही पूर्ण वाचता — एका प्रामाणिक, मुद्दाम केलेल्या अपयशासह जे शिकलेली embeddings का असतात हे स्पष्ट करते.
💡 भाग 1 — कल्पना (1–4)
- keywords strings जुळवतात; अर्थाला जागा लागतात 🗺️
- मजकूर → निर्देशांक: खेळण्याचा मार्ग आणि खरा मार्ग
- साम्य = दिशा (normalize करा, मग dot) 🧭
- लाखो जागा: मैत्रीचा नकाशा (HNSW) 🏃
🔧 भाग 2 — खऱ्या जगात (5–8)
- डेटाबेस संपूर्ण वाचा: 70 प्रामाणिक ओळी 🔬
- कात्री & स्टिकर: chunking हा दर्जाचा लीव्हर ✂️
- RAG सुरुवातीपासून शेवटपर्यंत, तुमच्या पान-शोधकासह 📖
- pgvector → Pinecone: bake-off शिवाय निवड 🏬
# the 60-second wow — search by meaning, filters, and one honest failure:
git clone https://github.com/BaluRaut/learn-vectordb-school.git && cd learn-vectordb-school
python3 vectordb/demo.py
🗺️ संपूर्ण चित्र — एक आकृती, दोन्ही जगे
4K आवृत्तीसाठी क्लिक करा.
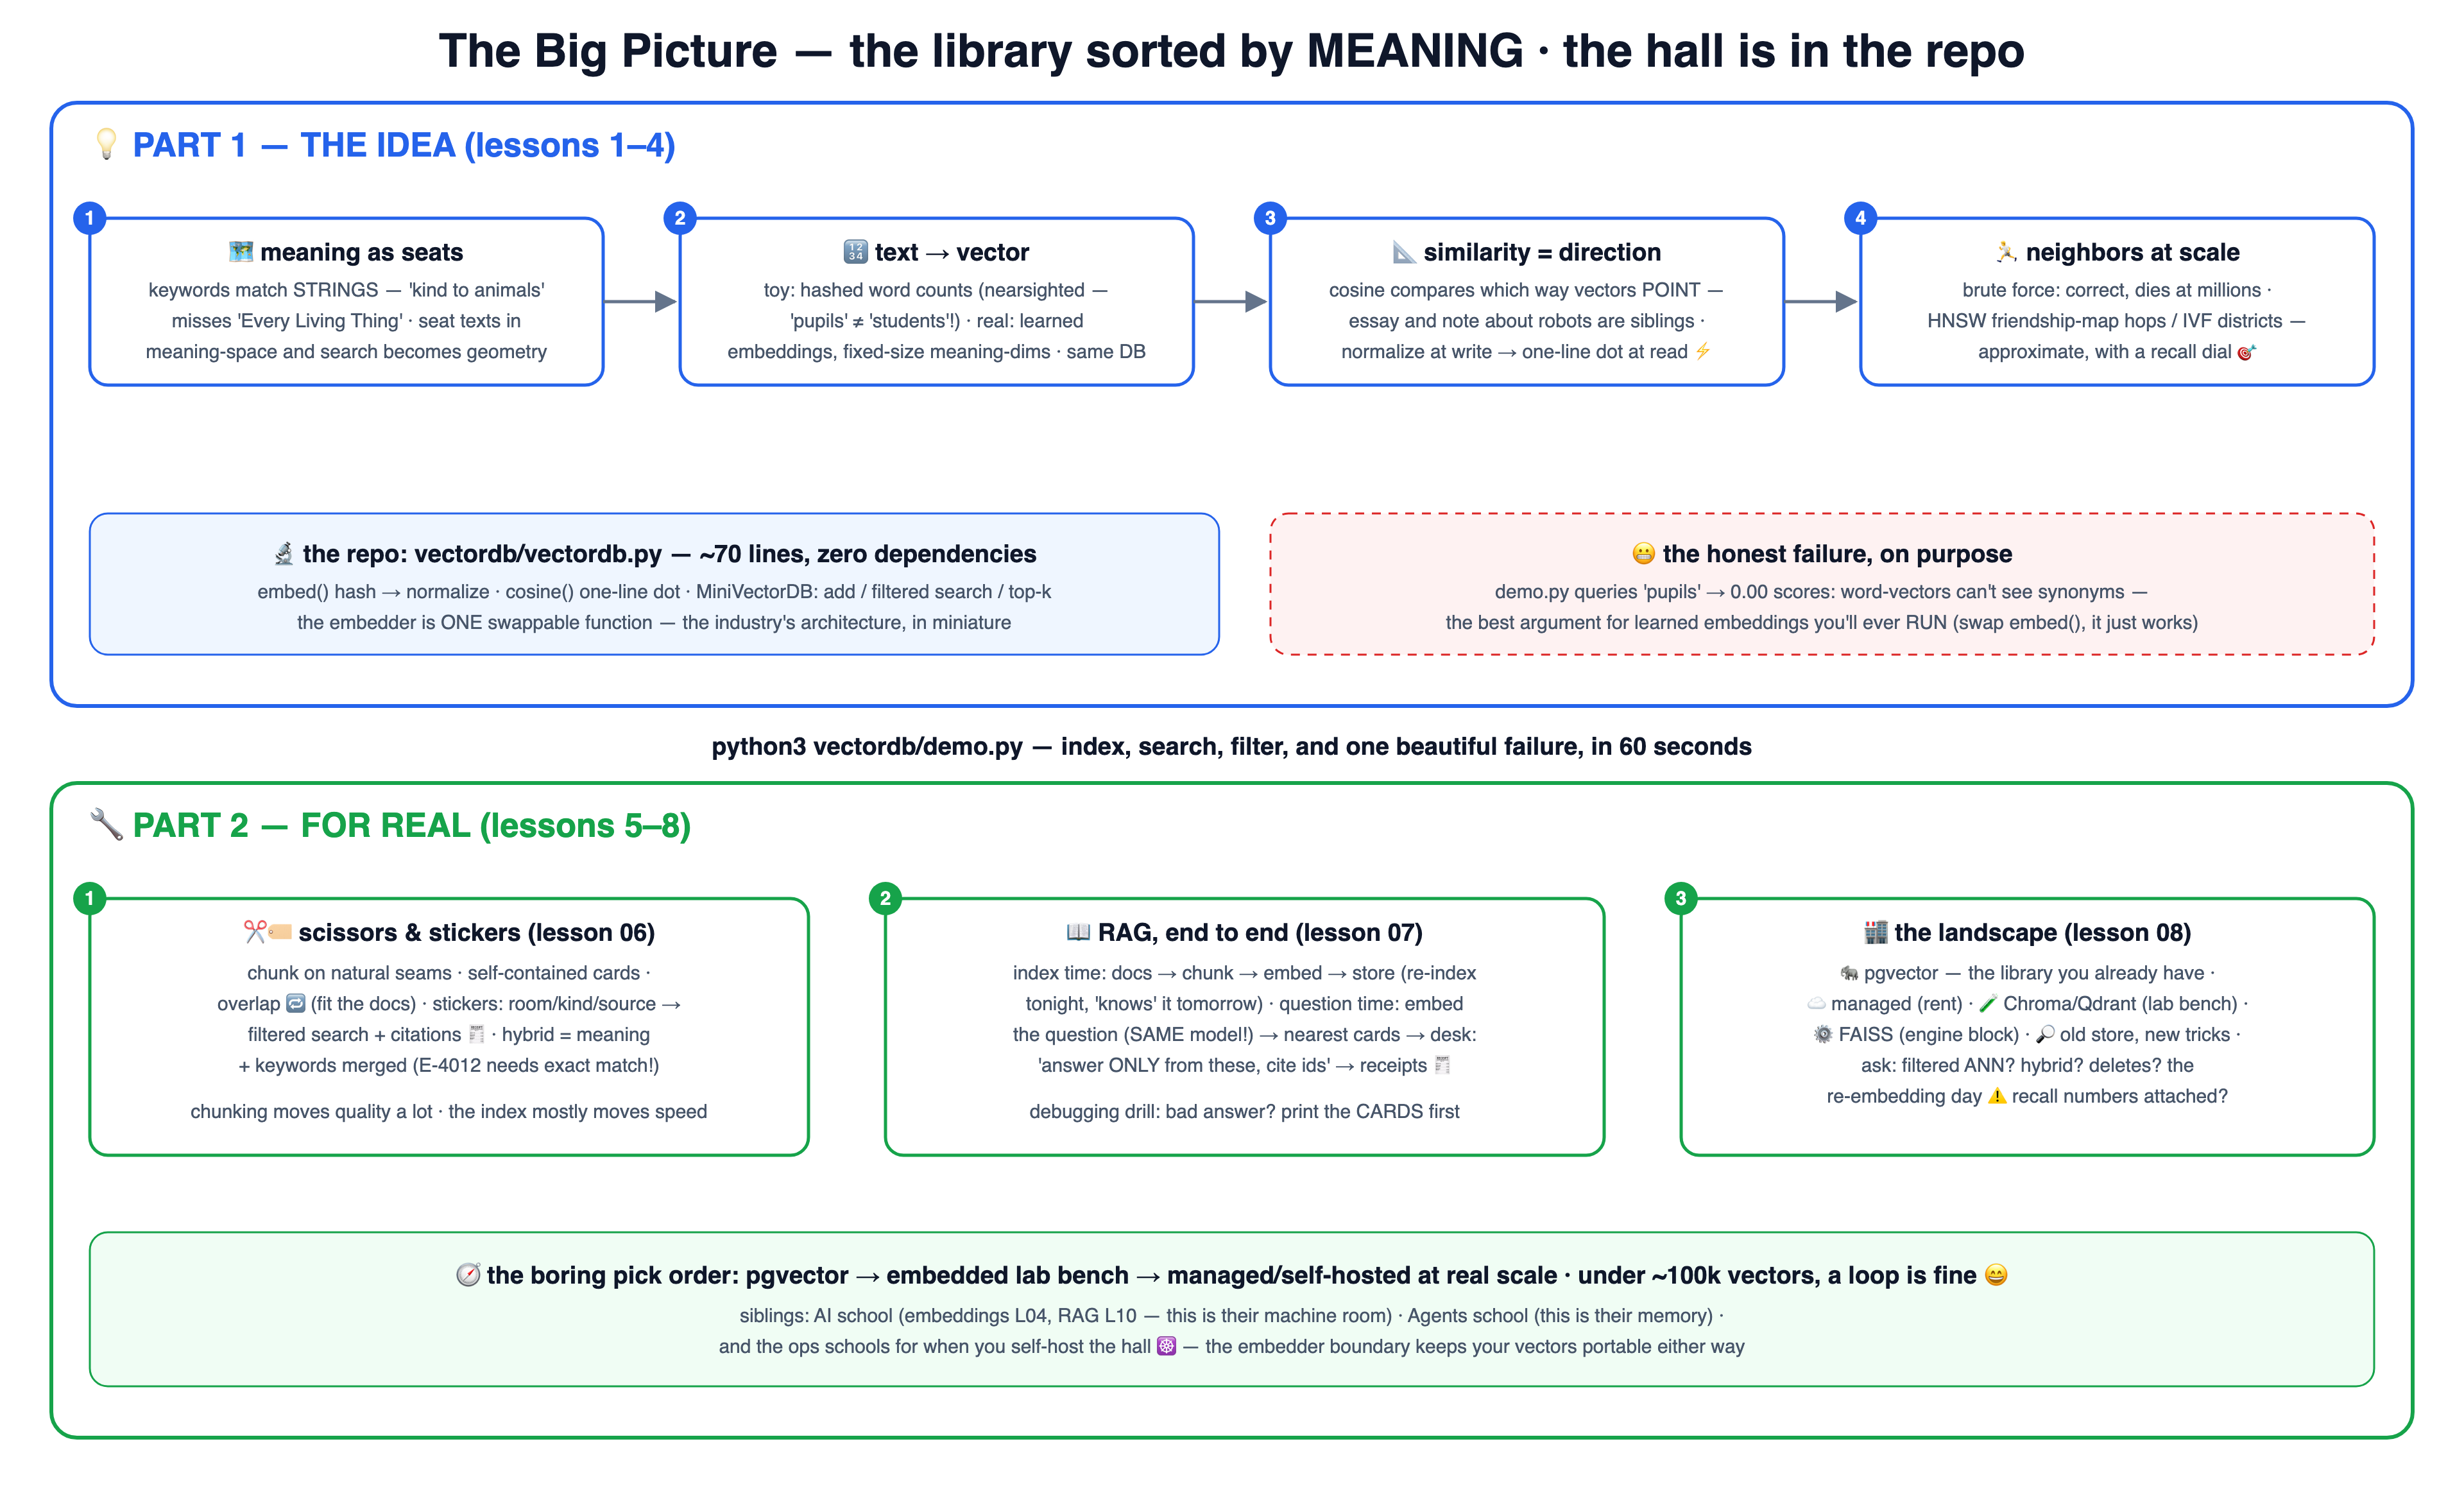
🎓 8 धडे
एक git ब्रँच = एक कल्पना; ब्रँच 05 मध्ये धडे 01–05 आहेत. AI कोर्सच्या embeddings (L04) आणि RAG (L10) धड्यांनंतरचा नैसर्गिक खोल अभ्यास — आणि एजंट्स शाळेचा स्मरण-थर.
🗺️ व्हेक्टर DB का
lesson-01-why-vector-dbधडा वाचा →आकृती पहा ↗🔢 मजकुराचे व्हेक्टर
lesson-02-text-to-vectorsधडा वाचा →आकृती पहा ↗📐 साम्य
lesson-03-similarityधडा वाचा →आकृती पहा ↗🏃 जवळचे शेजारी
lesson-04-nearest-neighborsधडा वाचा →आकृती पहा ↗🔬 व्हेक्टर DB बांधा
lesson-05-build-a-vector-dbधडा वाचा →आकृती पहा ↗✂️ Chunking & metadata
lesson-06-chunking-metadataधडा वाचा →आकृती पहा ↗📖 RAG जोडणी
lesson-07-rag-wiringधडा वाचा →आकृती पहा ↗🏬 लँडस्केप
lesson-08-landscapeधडा वाचा →आकृती पहा ↗📐 धड्यांच्या आकृत्या — क्रमांक अनुसरा
निळा = कल्पना, हिरवा = खऱ्या जगात. स्वतंत्र पानावरही.
1 🗺️ व्हेक्टर DB का
अर्थानुसार लावलेले ग्रंथालय — keywords strings जुळवतात, कल्पना नव्हे.
साध्या ग्रंथालयात "kind to animals" शोधले तर तीच अक्षरे असलेली पुस्तकेच सापडतात: राजकारणावरची कादंबरी Animal Farm सुद्धा येते, आणि Every Living Thing सुटते. आता अशा hall ची कल्पना करा जिथे प्रत्येक पुस्तक त्याच विषयाच्या पुस्तकांशेजारी बसते. Vector DB म्हणजे तो hall: तुमच्या प्रश्नाला जागा मिळते, आणि सर्वात जवळची पुस्तके हेच उत्तर, एकही शब्द जुळत नसला तरी.
Keyword search अक्षरे जुळवत असे, म्हणून "kind to animals" ला Animal Farm मिळाले आणि Every Living Thing पूर्ण सुटले.
Vector DB म्हणजे असे library hall जिथे प्रत्येक text शब्दांनुसार नाही तर अर्थानुसार ठरलेल्या जागेवर बसतो.
तो तुमचा प्रश्न embed करून त्याला जागा देतो, जवळच्या k जागा पटकन शोधतो आणि stickers (metadata) ने filter करू शकतो.
प्रश्नाशी एकही शब्द जुळत नसला तरी योग्य पान सापडते, जे keywords कधीच करू शकत नाहीत.
पुढे आपण शिकू की text ला मुळात जागा कशी मिळते: शब्दांचे vectors मध्ये रूपांतर (L02).
2 🔢 मजकुराचे व्हेक्टर
प्रत्येक मजकुराला जागा देणे — आपले प्रामाणिक खेळणे विरुद्ध शिकलेली embeddings.
वाक्याला अर्थाच्या hall मध्ये बसवायला त्याचा पत्ता आकड्यांत लिहावा लागतो. आपला toy प्रत्येक शब्द 256 पैकी एका खोक्यात टाकतो, म्हणून त्याला फक्त सामायिक शब्द दिसतात आणि "pupils" व "students" यांचा काहीच संबंध नाही असे वाटते (0.00). खऱ्या embedding model ने खूप text मधून शिकलेले असते, म्हणून एकच अर्थ असलेल्या शब्दांना जवळचे आकडे मिळतात (0.91).
Computer ला दोन वाक्यांचा अर्थ तुलना करता येत नाही; त्याला फक्त अक्षरांच्या साध्या strings दिसतात.
Embedding कोणत्याही text चे आकड्यांच्या यादीत (vector) रूपांतर करते, म्हणजेच अर्थाच्या hall मधली त्याची जागा.
आपला toy प्रत्येक शब्द 256 पैकी एका bucket मध्ये hash करून normalise करतो; खरे model 768–3072 dense आकडे देते.
शिकलेल्या model ला "pupils" आणि "students" एकच आहेत हे कळते (0.91), तर toy ला फक्त सामायिक शब्द दिसतात (0.00).
तुम्ही कोणता embedder वापरता याची database ला पर्वा नसते; पुढे आपण दोन vectors किती जवळ आहेत ते मोजू (L03).
3 📐 साम्य
दिशा अंतराला हरवते — आणि normalize-मग-dot ची युक्ती.
एकाच दिशेला रोखलेले दोन बाण एकच गोष्ट सांगतात, एक लांब आणि एक आखूड असला तरी. 10 पानांचा robot निबंध आणि एका ओळीची robot टीप एकाच दिशेला रोखलेली असतात, म्हणून cosine त्यांना 0.95 देतो, तर साधे अंतर लांबीमुळे फसते. म्हणून साठवताना आपण प्रत्येक बाणाची लांबी 1 करतो; मग तुलना म्हणजे प्रत्येक आकड्याला एक झटपट गुणाकार-बेरीज.
साधे अंतर मोजल्यावर लांबीमुळे फसगत होत असे: एका ओळीची टीप स्वतःच्या निबंधापेक्षा समुद्राच्या कवितेजवळ दिसत असे.
Cosine similarity दोन vectors ची दिशा तुलना करते, कारण अर्थ म्हणजे दिशा आणि लांबी म्हणजे फक्त आवाज.
लिहिताना प्रत्येक vector ची लांबी 1 करा (normalise), मग वाचताना cosine म्हणजे साधा dot product होतो.
Text साठी योग्य निर्णय मिळतो (निबंध आणि टीप 0.95) आणि प्रत्येक dimension ला फक्त एक गुणाकार-बेरीज लागते.
तुलना स्वस्त आहे, पण लाखो vectors शी तुलना नाही; पुढे आपण जवळचे शेजारी पटकन शोधू (L04).
4 🏃 जवळचे शेजारी
सगळ्यांना विचारणे विरुद्ध मैत्रीचा नकाशा (HNSW) — recall चा नॉब.
तुमच्या सर्वात जवळ कोण राहतो ते शोधायला तुम्ही सर्व 7 million लोकांना विचारू शकता: अचूक, पण खूपच हळू. किंवा जवळ असलेल्या मित्राला विचारा, मग त्याच्या आणखी जवळच्या मित्राला, आणि काही उड्यांत पोहोचा. HNSW म्हणजे तो मैत्रीचा नकाशा. कधी कधी तो खरा शेजारी चुकवू शकतो, म्हणून एक बटण असते: जास्त मेहनत करून जास्त शोधा, किंवा वेगाने थोडे कमी.
Brute force दर वेळी सर्व N vectors ना विचारतो: 7k साठी ठीक, पण 7 million साठी खूपच हळू.
HNSW आणि IVF सारखे approximate nearest neighbour indexes बहुतेक vectors वगळतात तरी जवळजवळ सर्व खरे शेजारी शोधतात.
HNSW मैत्रीच्या नकाशावर चालतो, नेहमी प्रश्नाजवळच्या मित्राकडे उडी मारतो; IVF फक्त जवळचे districts शोधतो.
तुमच्या हातात recall चे बटण असते: ef=64 ने 0.9 ms मध्ये 93% recall, तर brute force ने 40 ms मध्ये 100%.
Embed, cosine आणि search समजल्यावर, पुढे आपण स्वतः एक छोटा पूर्ण vector DB बनवू (L05).
5 🔬 व्हेक्टर DB बांधा
70 प्रामाणिक ओळी: embed, cosine, store, filter, top-k.
खरे यंत्र कसे चालते ते पाहायचा सर्वात चांगला मार्ग म्हणजे स्वतः toy बनवणे. आपला MiniVectorDB फक्त 70 ओळींचा आहे: embed text चे आकडे बनवतो, cosine दोघे किती जवळ आहेत ते गुण देतो, आणि search आधी योग्य sticker (room 3A) असलेली cards ठेवतो, मग गुण देऊन, क्रम लावून top k परत देतो. प्रत्येक खरा vector DB याच पायऱ्या करतो, फक्त जास्त वेगाने.
Vector DB एखाद्या जादूच्या बंद डब्यासारखा वाटत असे; निकाल चुकीचे आल्यावर त्यावर विश्वास ठेवणे किंवा debug करणे कठीण.
MiniVectorDB म्हणजे vectordb/vectordb.py मधल्या 70 प्रामाणिक ओळी: embed, cosine, store, filter आणि top-k.
search("rules about pets", k=2, where={"room": "3A"}) आधी sticker ने filter करतो, मग score, sort करून top-2 ठेवतो.
एकदा स्वतः बनवला की प्रत्येक खरा vector DB म्हणजे याच पायऱ्या, फक्त जास्त वेगाने आणि सुरक्षितपणे.
Persistence, deletes आणि ANN index मुद्दाम नाहीत; पुढे चांगली cards आणि stickers सर्वात महत्त्वाची (L06).
6 ✂️ Chunking & metadata
कार्डे आणि रंगीत स्टिकर — कोणत्याही index पेक्षा मोठा दर्जाचा लीव्हर.
400 पानांचे handbook कोणी एका गठ्ठ्यात शिकत नाही, म्हणून आपण त्याचे छोटे cards करतो, प्रत्येक एका कल्पनेबद्दल. शेजारच्या cards मध्ये एक वाक्य पुन्हा येते, म्हणजे कोणतीही कल्पना अर्धवट कापली जात नाही. प्रत्येक card ला room:3A आणि page 12 सारखे stickers मिळतात, म्हणजे फक्त योग्य room ठेवता येते आणि उत्तर कोणत्या पानावरून आले ते दाखवता येते.
एका मोठ्या chunk मध्ये पाच विषय मिसळले म्हणून त्याची जागा कोणाच्याच जवळ नव्हती, आणि छोट्या chunks चा विषयच हरवला.
Chunking पुस्तकाचे स्वतंत्र cards मध्ये तुकडे करते, आणि metadata stickers प्रत्येक card वर room, kind आणि page लिहितात.
Headings सारख्या नैसर्गिक ठिकाणी कापा, एक वाक्य overlap ठेवा म्हणजे कल्पना अर्धवट तुटणार नाही, आणि प्रत्येक card ला stickers लावा.
Chunking उत्तराचा दर्जा कोणत्याही index निवडीपेक्षा जास्त बदलते, आणि stickers मुळे filter करता येते व page सांगता येते.
चांगली cards हा RAG चा कच्चा माल आहे, जिथे search model ला उघडे पुस्तक देते (L07).
7 📖 RAG जोडणी
पुस्तक उघडून परीक्षा, सुरुवातीपासून शेवटपर्यंत — आपल्या पान-शोधकासह.
Open-book परीक्षेत आधी योग्य पाने शोधायची, मग फक्त त्यांच्यावरूनच उत्तर लिहायचे. RAG हेच AI साठी करते: प्रश्नाचे आकडे बनतात, vector DB सर्वोत्तम cards शोधतो, आणि ती cards "फक्त यांच्यावरून उत्तर दे आणि त्यांचा उल्लेख कर" या नियमासह model च्या बाकावर ठेवली जातात. म्हणून उत्तर पावतीसह येते, जसे "Yes, with a feeding rota [c3]".
Language model फक्त स्मरणातून उत्तर देत असे, तुमच्या handbook बद्दल अंदाज बांधत, तपासायला कोणतीही पावती न देता.
RAG म्हणजे open-book परीक्षा: योग्य cards शोधा, बाकावर ठेवा, आणि फक्त त्यांच्यावरूनच उत्तर द्या.
प्रश्न त्याच model ने embed करा, room=3A सह k=4 शोधा, मग prompt द्या: फक्त या cards वरून उत्तर द्या, ids सांगा.
उत्तरे पुराव्यासह येतात, जसे "Yes, with a feeding rota [c3]", आणि चुकीचे उत्तर debug करणे सोपे होते.
AI school (L08–L10) तुमचा स्वतःचा page-finder आत ठेवून हेच पुढे नेते; पुढे खरा vector DB निवडा (L08).
8 🏬 लँडस्केप
pgvector, Pinecone, Chroma, FAISS — bake-off शिवाय निवड.
Vector store निवडणे म्हणजे अभ्यासाची जागा निवडण्यासारखे: आधीच वापरता ते ग्रंथालय, घरचे टेबल, किंवा दुसरे कोणी सांभाळते तो भाड्याचा hall. तुमच्याकडे आधीच Postgres आणि सुमारे 10 million पेक्षा कमी vectors असतील तर pgvector ही सोपी निवड. Laptop वरच्या prototype ला Chroma, servers चालवायला कोणी नसलेल्या team ला Pinecone सारखी managed service, आणि research ला FAISS.
एकही vector साठवण्याआधी teams pgvector, Pinecone, Chroma आणि FAISS मध्ये लांबलचक स्पर्धा घेत असत.
हा नकाशा vector stores दाखवतो: तुम्ही स्वतः चालवता ती low-level engines ते दुसरे कोणी चालवते ते managed halls.
आधीच Postgres आणि ~10M पेक्षा कमी vectors: pgvector; ops team नाही: managed; laptop prototype: Chroma; research: FAISS.
SQL आणि vectors एकाच backup मध्ये ठेवणे सहसा आधी जिंकते, आणि चालवायला व सुरक्षित ठेवायला नवी system लागत नाही.
आधी तुमच्याकडे असलेल्या store पासून सुरुवात करा, आणि scale किंवा operations ची खरी गरज आल्यावरच बदला.