🧠 AI शाळेच्या पद्धतीने शिका
मॉडेल खरोखर कसे चालतात (टोकन → embeddings → attention → RLHF & LoRA), मग ते नीट कसे वापरायचे (prompting, RAG, एजंट, diffusion) — प्रत्येक संकल्पना शाळेची गोष्ट, प्रत्येक धडा क्रमांकित आकृती आणि प्रत्यक्ष प्रयोगासह. प्रयोग शून्य-अवलंबित्व Python: GPU नाही, API key नाही, pip install नाही.
🎬 सोबतचा व्हिडिओ: 9 AI Concepts Explained in 7 minutes (ByteByteAI) — हवाई दृश्य; हा कोर्स म्हणजे तो नाव घेतो त्या प्रत्येक संकल्पनेचा जमिनीवरचा संथ फेरफटका.
🔬 भाग 1 — मॉडेलच्या आत
- नियम लिहिले नव्हे, उदाहरणांतून वाढवले जातात 📖
- मजकूर कोड्याचे तुकडे बनतो 🧩 अर्थानुसार बसवलेले 🗺️
- एकच खेळ: पुढचा तुकडा ओळखा 🎲 — नजर टाकत 👀
- finishing school: शिष्टाचार, सोनेरी तारे, चिकट चिठ्ठ्या ⭐
🧰 भाग 2 — खऱ्या जगात वापरणे
- ग्रंथपालाला नीट विचारा; छोट्या टेबलाचे भान ठेवा 🗣️🪑
- आत्मविश्वासू मूल गोष्टी बनवते — बचाव 🙋
- पुस्तक उघडून परीक्षा (RAG) 📖 आणि हॉल पास (एजंट्स) 📋
- static साफ करा: diffusion & multimodal 📺
🗺️ संपूर्ण चित्र — एक आकृती, दोन्ही जगे
संपूर्ण कोर्स एका कॅनव्हासवर. 4K आवृत्तीसाठी क्लिक करा.
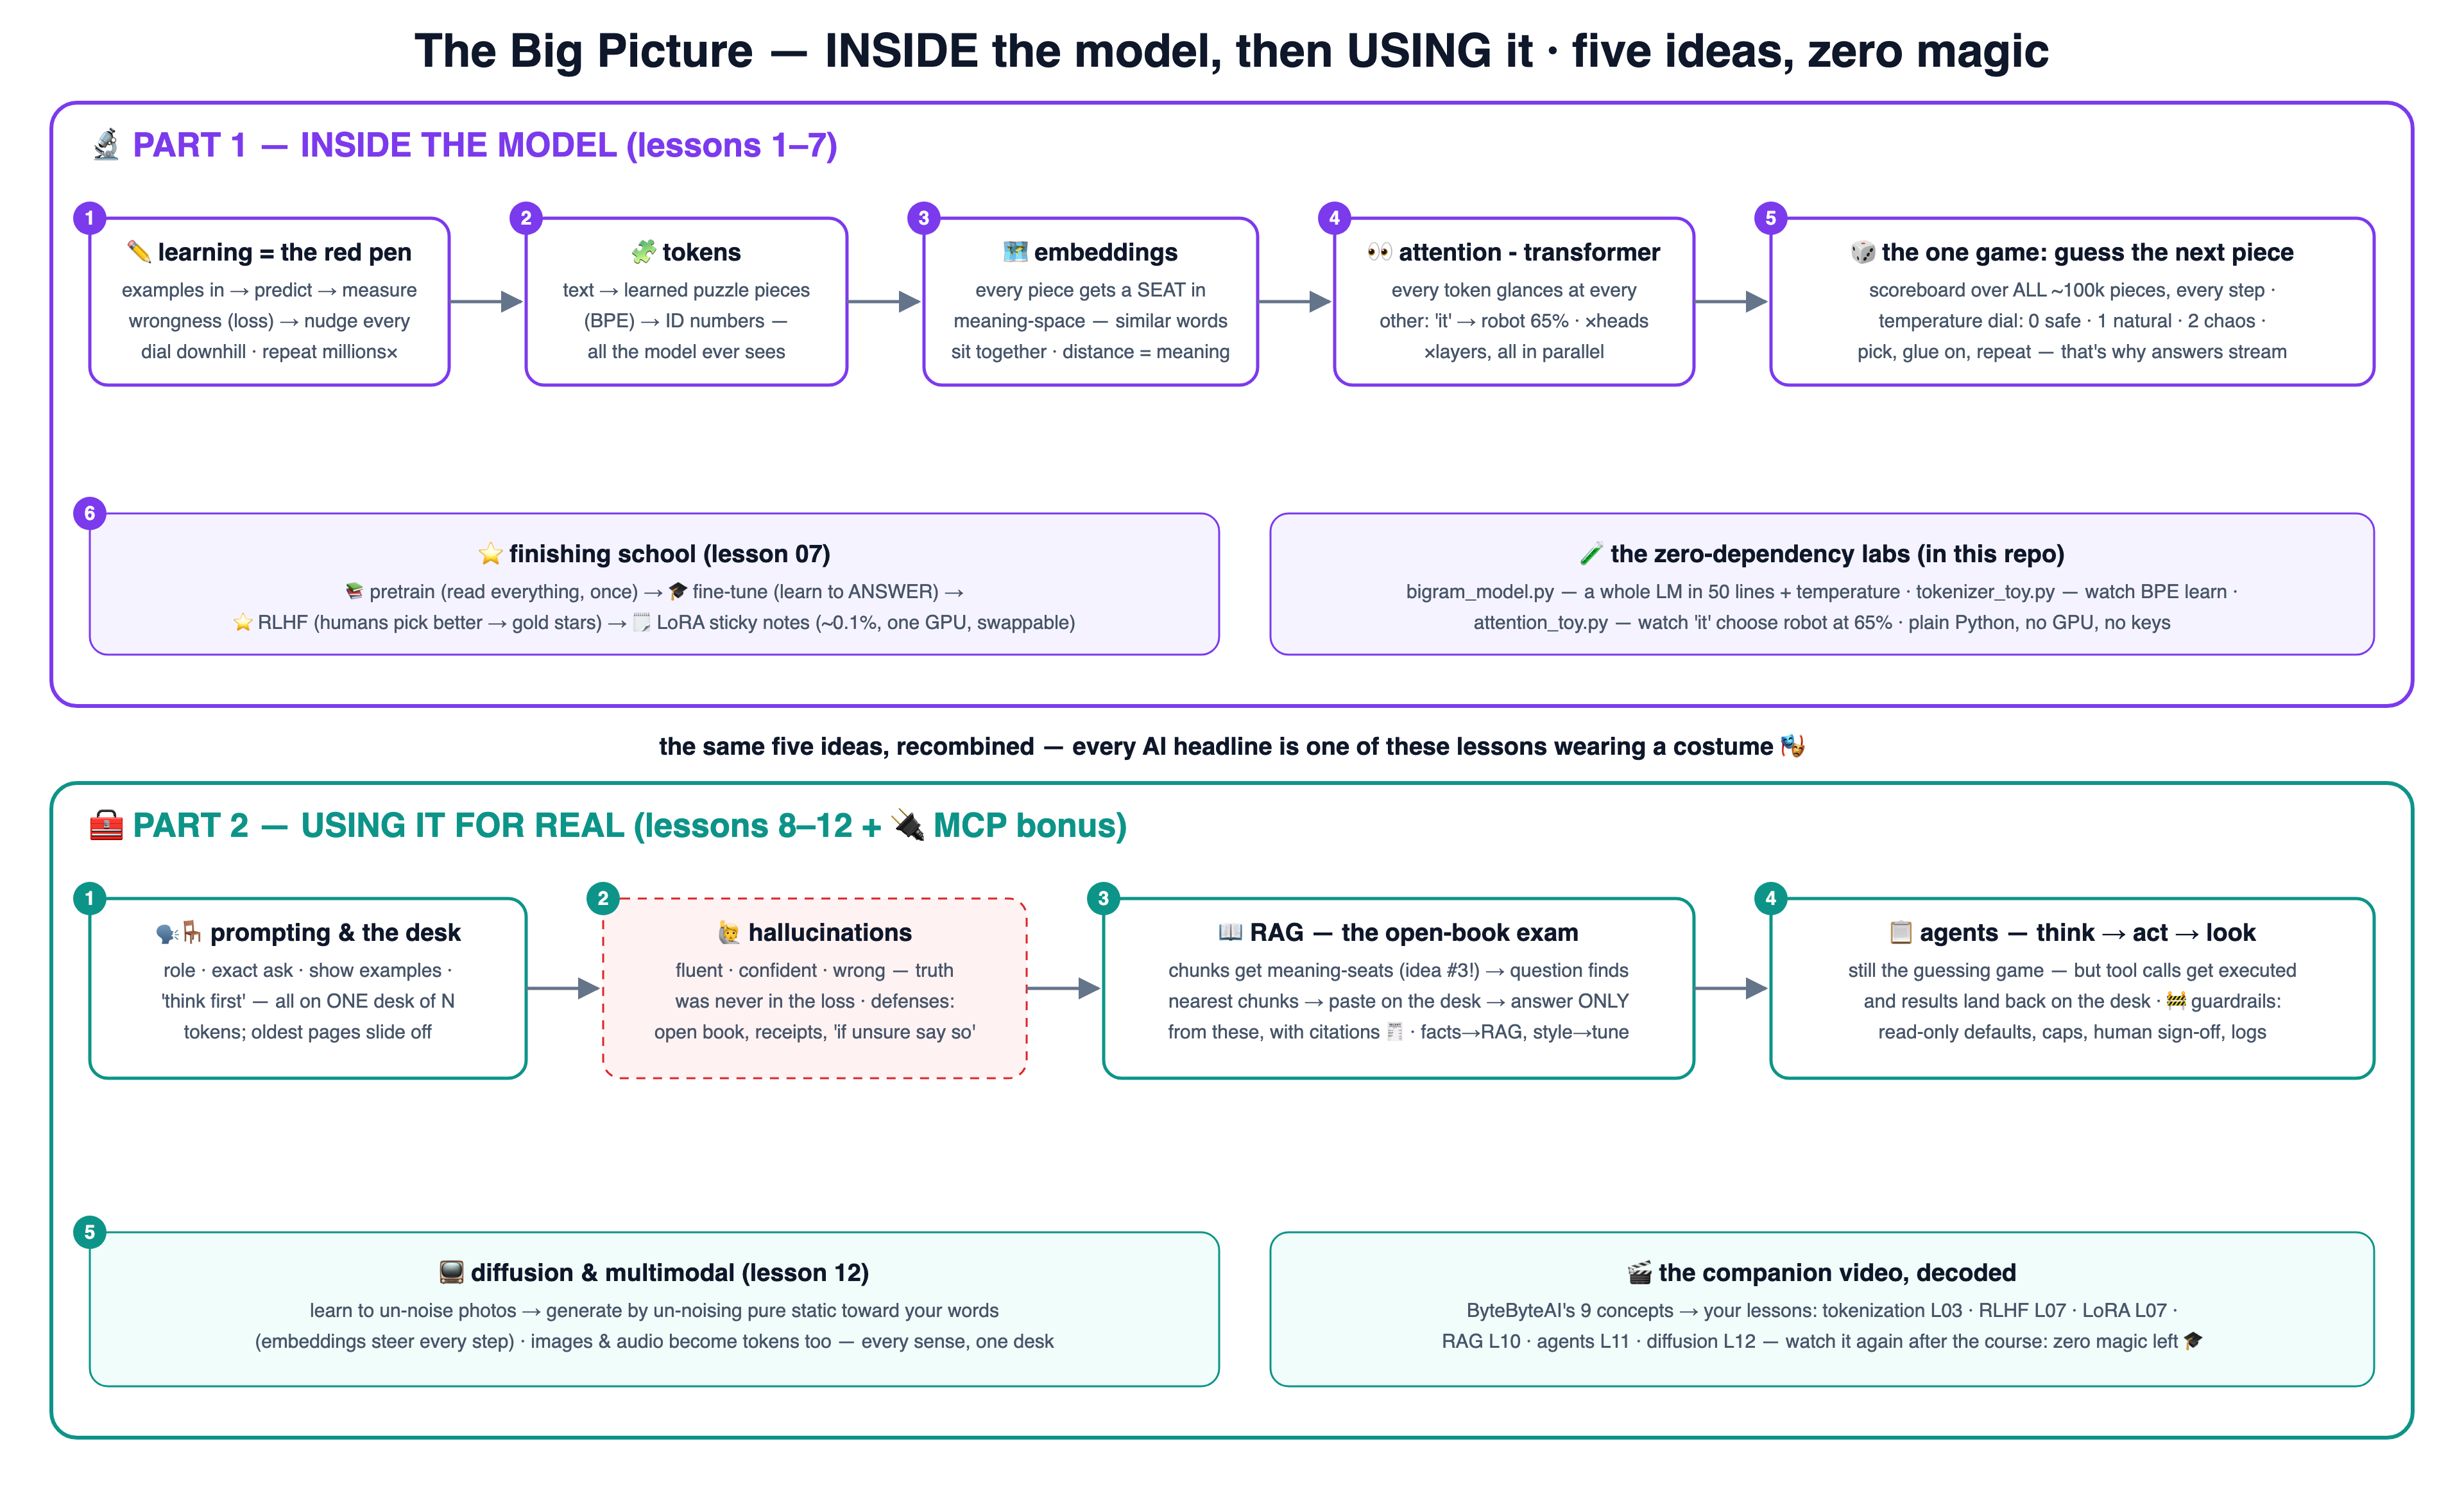
🔬 भाग 1 — मॉडेलच्या आत (धडे 1–7)
एक git ब्रँच = एक कल्पना; ब्रँच 05 मध्ये धडे 01–05 आहेत. प्रयोग साध्या Python 3 वर चालतात.
📖 AI म्हणजे काय
lesson-01-what-is-aiधडा वाचा →आकृती पहा ↗✏️ Training
lesson-02-trainingधडा वाचा →आकृती पहा ↗🧩 टोकन
lesson-03-tokensधडा वाचा →आकृती पहा ↗🗺️ Embeddings
lesson-04-embeddingsधडा वाचा →आकृती पहा ↗🎲 पुढच्या टोकनचा अंदाज
lesson-05-next-tokenधडा वाचा →आकृती पहा ↗👀 Attention
lesson-06-attentionधडा वाचा →आकृती पहा ↗⭐ RLHF & LoRA
lesson-07-rlhf-loraधडा वाचा →आकृती पहा ↗🧰 भाग 2 — खऱ्या जगात वापरणे (धडे 8–12 + बोनस 13)
इथेही install नाही — प्रयोग तुमच्याकडे आधीच असलेला कोणताही chatbot, कागद आणि प्रामाणिकपणा वापरतात.
🗣️ Prompting & context
lesson-08-prompting-contextधडा वाचा →आकृती पहा ↗🙋 Hallucinations
lesson-09-hallucinationsधडा वाचा →आकृती पहा ↗📺 Diffusion & multimodal
lesson-12-diffusionधडा वाचा →आकृती पहा ↗# take the course locally:
git clone https://github.com/BaluRaut/learn-ai-school.git
cd learn-ai-school
python3 demo/bigram_model.py # a language model in 60 seconds
git checkout lesson-01-what-is-ai # then lesson by lesson📐 धड्यांच्या आकृत्या — क्रमांक अनुसरा
प्रत्येक धडा एका क्रमांकित बॉक्स-आणि-बाण आकृतीत (जांभळा = मॉडेलच्या आत, हिरवट-निळा = वापरणे) — स्वतंत्र पानावरही.
1 📖 AI म्हणजे काय
नियमपुस्तके विरुद्ध उदाहरणांतून शिकणे — नियम लिहिले नव्हे, वाढवले जातात.
'मांजर म्हणजे काय' याचे नियम लिहून पाहा: कान, मिशा, शेपूट… मग शेपूट नसलेली cartoon मांजर तुमचे नियम मोडते. त्याऐवजी computer ला मांजर किंवा कुत्रा असे लेबल लावलेले 10,000 फोटो दाखवा आणि नियम त्यालाच शोधू द्या. हेच आजचे AI: हाताने लिहिलेले नव्हे, तर उदाहरणांतून उगवलेले नियम. chat assistants म्हणजे LLMs, deep learning चा एक प्रकार, जो machine learning च्या आत, आणि ते AI च्या आत.
नियमपुस्तिकेच्या मार्गात प्रत्येक नव्या प्रकारासाठी हाताने नवा नियम लागतो, आणि फर नसलेली कार्टून मांजर मांजर नाही ठरते.
इथे AI म्हणजे असा model ज्याचे नियम हाताने लिहिण्याऐवजी लेबल लावलेल्या उदाहरणांतून उगवतात.
10,000 लेबल लावलेल्या फोटोंवर train केल्यावर कोणीही न लिहिलेला मांजर-शोधक मिळतो, जो नव्या कार्टून मांजरीला मांजर म्हणतो.
जग लिहून ठेवण्याइतके सोपे नाही, म्हणून उदाहरणांतून शिकणे असे प्रकार हाताळते ज्यांची नियम लिहिणाऱ्याने कल्पनाही केली नव्हती.
एकात एक बाहुल्यांप्रमाणे हा कोर्स AI पासून machine learning, deep learning आणि LLMs कडे आत जातो, training पासून सुरुवात.
2 ✏️ Training
सराव परीक्षा + लाल पेन — loss आणि उताराकडे छोटे धक्के.
हे सराव परीक्षेसारखे आहे. model 'The cat sat on the ___' मधला गाळलेला शब्द ओळखतो, लाल पेन तो किती चुकला ते दाखवतो, आणि त्याचे लाखो dials बरोबर उत्तराकडे थोडे थोडे फिरवले जातात. हे लाखो वेळा. model ने कधीच सराव न केलेली वेगळी परीक्षा दाखवते की तो कधी शिकण्याऐवजी पाठ करू लागला, आणि तेव्हाच थांबायचे.
training शिवाय model चे लाखो dials random असतात, म्हणून पुढच्या शब्दाचा त्याचा अंदाज नशिबापेक्षा चांगला नसतो.
training म्हणजे लाल पेन असलेली सराव परीक्षा: अंदाज करा, loss ने किती चूक ते मोजा, आणि dials उताराकडे ढकला.
"The cat sat on the ___" साठी तो table 40%, mat 12% म्हणतो; "mat" वरचा loss प्रत्येक dial थोडा हलवतो, लाखो वेळा.
न पाहिलेल्या प्रश्नांचा validation set दाखवतो की training loss कमी होत असताना validation loss कधी वाढतो, म्हणून पाठांतराआधी थांबता.
models तुकड्यांत कापलेल्या text वर शिकतात, म्हणून पुढचा lesson ते तुकडे दाखवतो: tokens.
3 🧩 टोकन
मजकूर कोड्याच्या तुकड्यांत कापणे — 'strawberry' अवघड का.
model काहीही वाचण्याआधी text चे tokens नावाचे puzzle चे तुकडे केले जातात. 'the' सारखे नेहमीचे भाग एक तुकडा बनतात; कमी वापरले जाणारे शब्द अनेक तुकड्यांनी बनतात. मग model ला प्रत्येक तुकड्याचा फक्त क्रमांक दिसतो, एकेक अक्षर कधीच नाही. म्हणूनच 'strawberry मध्ये r किती वेळा आहे?' हा प्रश्न अवघड आहे: अक्षरे अशा तुकड्यांमध्ये लपलेली असतात ज्यांच्या आत model कधी पाहत नाही.
tokens शिवाय model ला प्रत्येक शक्य शब्दासाठी एक नोंद लागली असती, आणि teaches सारखे नवे शब्द अनोळखी राहिले असते.
tokens म्हणजे text कापून केलेले puzzle चे तुकडे, आणि model ला त्यांचे IDs दिसतात, अक्षरे कधीच नाहीत.
BPE सगळ्यात वारंवार येणारी जोडी चिकटवतो, e + a चे ea, पुन्हा पुन्हा, म्हणून teaches चे tea · c · he · s होते.
strawberry मधील R मोजणे का अवघड आहे आणि किंमत व limits tokens मध्ये का मोजल्या जातात, हे यातून कळते.
खरे tokenizers सुमारे 100,000 तुकडे शिकतात, आणि पुढे प्रत्येक तुकड्याला अर्थाची जागा मिळते: embeddings.
4 🗺️ Embeddings
अर्थांचा बैठक-तक्ता — सारखे शब्द एकत्र बसतात.
एका मोठ्या सभागृहाची कल्पना करा जिथे प्रत्येक शब्दाला एक जागा मिळते. 'cat' हा 'kitten' आणि 'dog' जवळ बसतो, तर 'stapler' खूप दूर. प्रत्येक जागा म्हणजे आकड्यांची यादी, शेकडो आकडे, training मध्ये शिकलेले. जवळच्या जागा म्हणजे सारखा अर्थ, म्हणून शब्द वेगळे असले तरी सारखा अर्थ असलेल्या गोष्टी computer शोधू शकतो. दिशांनाही अर्थ असतो: king − man + woman हे queen जवळ पोहोचते.
फक्त IDs असताना cat आणि kitten हे cat आणि stapler इतकेच असंबंधित दिसतात, म्हणून अर्थ जवळचे आहेत हे model ला कळत नाही.
embedding म्हणजे अर्थांच्या सभागृहातील एक जागा: आकड्यांची यादी जिथे सारखे शब्द जवळ जवळ बसतात.
प्रत्येक token ला training मध्ये शिकलेले 768 किंवा अधिक coordinates मिळतात, आणि दिशांना अर्थ असतो: king − man + woman ≈ queen.
अंतर म्हणजेच साम्य बनते, आणि त्यावर semantic search चालतो जो फक्त जुळणारे शब्द नव्हे तर अर्थ शोधतो.
या जागाच lesson 10 मधील RAG चालवतात, आणि संपूर्ण VectorDB school याच कल्पनेवर उभी आहे.
5 🎲 पुढच्या टोकनचा अंदाज
वाक्य-पूर्ण-करण्याचा खेळ, temperature च्या नॉबसह.
हा वाक्य पूर्ण करण्याचा खेळ आहे. 'The dog chased the ___' साठी model प्रत्येक शक्य तुकड्याला एक शक्यता देतो: cat 24%, ball 17%, car 9%. तो एक निवडतो, जोडतो, आणि पुढच्या तुकड्यासाठी पुन्हा खेळतो; म्हणूनच उत्तरे शब्दामागून शब्द दिसतात. temperature dial निवड किती धाडसी हे ठरवतो: कमी असेल तर सर्वात सुरक्षित शब्द, जास्त असेल तर अनपेक्षित शब्द.
chatbot साठवलेली उत्तरे शोधतो असे वाटणे सोपे आहे, आणि त्यामुळे तो खरोखर एकेक तुकडा कसा लिहितो ते लपते.
next-token prediction म्हणजे वाक्य पूर्ण करण्याचा खेळ: प्रत्येक step ला प्रत्येक तुकड्यासाठी एक probability.
"The dog chased the ___" साठी तो cat 24% आणि ball 17% गुण देतो, एक निवडतो, जोडतो, आणि पुन्हा विचारतो.
temperature dial प्रत्येक निवड किती धाडसी असेल ते ठरवतो, आणि step-by-step loop मुळेच उत्तरे हळूहळू stream होतात.
चांगले गुण देण्यासाठी model ला आधीचे कोणते शब्द महत्त्वाचे ते कळले पाहिजे; ते attention चे काम आहे, पुढे.
6 👀 Attention
वर्गात इकडे-तिकडे पाहणारी मुले — 'ते' कोणाला म्हणते?
'the robot dropped the ball because it was heavy' मध्ये 'it' कोण? सुगावा शोधत वर्गात इकडे तिकडे पाहणाऱ्या मुलासारखा 'it' हा शब्द बाकी प्रत्येक शब्दाकडे पाहतो आणि उपयोगी शब्द मिसळून घेतो: 69% ball, 16% heavy. 'heavy' ऐवजी 'tired' लिहा आणि नजर robot कडे वळते. transformer हे प्रत्येक शब्दासाठी एकाच वेळी करतो, अनेक layers मध्ये पुन्हा पुन्हा.
attention शिवाय वाक्यातील it शब्दाला तो ball आहे की robot हे कळण्याचा काहीच मार्ग नसतो.
attention म्हणजे प्रत्येक शब्दाने वर्गात इकडे तिकडे पाहणे आणि त्याच्यासाठी सर्वात महत्त्वाचे शब्द मिसळून घेणे.
"the robot dropped the ball because it was heavy" मध्ये it 69% ball, 16% heavy आणि 6% robot मिसळतो.
heavy ऐवजी tired केले की नजर robot कडे वळते, म्हणून model ठरलेल्या नियमांऐवजी context वरून अर्थ ओळखतो.
transformer अनेक layers वर अनेक heads चालवतो, आणि पुढे असा वाचक नम्र assistant कसा बनतो ते पाहाल.
7 ⭐ RLHF & LoRA
ग्रंथालय, शिष्टाचार वर्ग, सोनेरी तारे — आणि चिकट चिठ्ठ्या.
आधी model संपूर्ण library वाचतो आणि कोणताही text पुढे चालवायला शिकतो. मग तो प्रश्न-उत्तरांची उदाहरणे अभ्यासतो, म्हणजे फाफटपसारा न करता उत्तर देतो. मग लोक दोन उत्तरांपैकी चांगले निवडतात, gold stars देण्यासारखे, आणि model ला लोकांना आवडेल त्या दिशेने ढकलले जाते. LoRA ही स्वस्त युक्ती आहे: मोठा model गोठवा आणि वर फक्त छोट्या sticky notes train करा, साधारण 0.1% dials.
फक्त सगळे वाचलेला model फक्त text पुढे चालवतो आणि भरकटतो, आणि त्याचे सगळे dials पुन्हा train करायला data centre लागते.
RLHF gold stars देऊन pretrained वाचकाला assistant बनवते; LoRA frozen model वर छोट्या trainable sticky notes जोडते.
pretraining आणि Q→A fine-tuning नंतर माणसे दोन उत्तरांपैकी चांगले निवडतात, आणि taste-judge model त्याला त्या दिशेने ढकलतो.
LoRA फक्त ~0.1% dials train करते, म्हणून laptop GPU वर 7B model जुळवता येतो आणि प्रत्येक कामासाठी notes बदलता येतात.
assistant अजूनही next-token machine च आहे, म्हणून पुढचा lesson त्याला नीट कसे विचारायचे ते शिकवतो: prompting.
8 🗣️ Prompting & context
ग्रंथपालाला कसे विचारायचे — आणि ते ज्यावर मावते ते छोटे टेबल.
model एका छोट्या desk वर काम करतो, आणि त्याला वापरता येणारे सगळे त्याच desk वर असावे लागते: तुमच्या सूचना, आतापर्यंतचे chat, चिकटवलेले documents, आणि तो लिहित असलेले उत्तरसुद्धा. कालचे chat किंवा तुमच्या files कोणी तिथे ठेवल्याशिवाय तिथे नसतात. चांगले विचारणे म्हणजे librarian ला विचारण्यासारखे: कोण बनायचे, नेमके काय हवे ते सांगा, एक उदाहरण दाखवा, आणि मर्यादा व परत हवा तो format ठरवा.
लोकांना वाटते model ला कालचा chat आठवतो किंवा त्यांच्या files दिसतात, आणि मग त्यांना अस्पष्ट किंवा चुकीची उत्तरे मिळतात.
context window म्हणजे desk, उदा. 200,000 tokens, आणि model कडे फक्त तेवढेच असते; prompt म्हणजे librarian ला विचारण्याची पद्धत.
भूमिका, नेमका प्रश्न, दोन सोडवलेली उदाहरणे, 100 words पेक्षा कमी सारख्या अटी, आणि JSON सारखा output format द्या.
जे desk वर नाही ते अस्तित्वात नाही, म्हणून स्पष्ट आणि पूर्ण prompt ला खूप चांगले उत्तर मिळते.
चांगला prompt सुद्धा रचलेले facts थांबवू शकत नाही; हे पुढचा hallucinations चा lesson समजावतो.
9 🙋 Hallucinations
कधीच 'मला माहीत नाही' न म्हणणारे आत्मविश्वासू मूल.
काही मुले कधीच 'मला माहीत नाही' म्हणत नाहीत; त्याऐवजी आत्मविश्वासाने रचलेले उत्तर देतात. model सुद्धा तसेच करतो, कारण त्याला तथ्ये तपासायला नव्हे, तर सर्वात शक्य पुढचे शब्द लिहायला train केले आहे. Mongolian pirates वरची पुस्तके विचारा, आणि तो खरे वाटणारे नाव, लेखक आणि पानांची संख्या रचू शकतो. उपाय: खरी तथ्ये त्याच्या desk वर ठेवा, नेमकी ओळ quote करायला सांगा, आणि 'माहीत नाही' म्हणायची परवानगी द्या.
लोक सफाईदार उत्तरांवर विश्वास ठेवतात, म्हणून खऱ्या वाटणाऱ्या लेखक आणि पानसंख्येचे रचलेले पुस्तक न तपासता पुढे जाते.
hallucination म्हणजे आत्मविश्वासू मुलाचे उत्तर: सर्वात शक्य पुढचा text, सफाईदार आणि रचलेला, सत्य नव्हे.
सत्य कधीच loss मध्ये नव्हते, आणि मला माहीत नाही हे क्वचितच सर्वात शक्य शब्द असतात, म्हणून पातळ शेल्फमधून रचलेले शीर्षक येते.
तीन उपाय हे कमी करतात: facts desk वर ठेवा, source quote करायला सांगा, आणि माहीत नाही म्हणण्याची परवानगी द्या.
facts आपोआप desk वर ठेवणे हेच RAG करते, पुढच्या lesson मध्ये.
10 📖 RAG
पुस्तक उघडून परीक्षा, बैठक-तक्त्याने स्वयंचलित.
पाठांतराच्या परीक्षेपेक्षा open-book exam सोपी असते. RAG model साठी हेच करते. आधी 400 पानांच्या handbook चे छोटे chunks करा आणि प्रत्येकाला अर्थांच्या सभागृहात जागा द्या. प्रश्न आला की सर्वात जवळचे 3 chunks शोधा, ते desk वर ठेवा, आणि सांगा 'फक्त यांवरूनच उत्तर दे, आणि संदर्भ दे'. बदलणाऱ्या तथ्यांसाठी RAG वापरा; शैली बदलायची असेल तर fine-tuning.
RAG शिवाय तुम्ही 400 पानांचे handbook हाताने paste करता, किंवा model training मध्ये कधीच न पाहिलेल्या facts चा अंदाज लावतो.
RAG म्हणजे स्वयंचलित open-book exam: सर्वात संबंधित chunks शोधा आणि उत्तर देण्याआधी ते desk वर ठेवा.
handbook चे ~300 शब्दांचे chunks करून प्रत्येक embed करा; प्रत्येक प्रश्न embed करा, जवळचे 3 घ्या, आणि त्यांचा हवाला देत उत्तर द्या.
उत्तरांसोबत [p12] सारखे हवाले येतात, आणि बदलणारे facts model पुन्हा train न करता ताजे राहतात.
बदलणाऱ्या किंवा बाहेरच्या facts साठी RAG आणि style साठी fine-tuning वापरा; पुढे models agents म्हणून tools वापरतात.
11 📋 एजंट्स & साधने
to-do यादी आणि हॉल पास असलेला विद्यार्थी.
एका विद्यार्थ्याला to-do list द्या, 'वर्गाची सहल आयोजित कर', आणि office मध्ये जाण्यासाठी hall pass. तो पुढच्या पायरीचा विचार करतो, ती करतो, जसे office ला किती मुले येणार ते विचारणे, उत्तर पाहतो (23), आणि काम पूर्ण होईपर्यंत हेच पुन्हा करतो. AI agent tools वापरून असेच काम करतो. guardrails त्याला सुरक्षित ठेवतात: सुरुवातीला फक्त वाचण्याची परवानगी, खर्चाची मर्यादा, शिक्षकांची सही, आणि प्रत्येक पायरीची नोंद.
साधा chat model फक्त बोलू शकतो, म्हणून प्रत्येक lookup आणि action तुम्हाला स्वतः करून results परत paste करावे लागतात.
agent म्हणजे to-do list आणि hall pass असलेला विद्यार्थी: तो loop मध्ये tools वापरून ध्येय गाठतो.
तो शब्दांत विचार करतो, roster.count() सारखा tool call लिहून action करतो, result पाहतो, 23 मुले, आणि पुन्हा करतो.
agents अनेक steps ची कामे पूर्ण करतात, आणि read-only tools, spending caps व human sign-off सारखे guardrails त्यांना सुरक्षित ठेवतात.
loop ध्येय, max steps किंवा timeout वर थांबतो, आणि bonus lesson मधील MCP tools कसे जोडायचे ते standard करतो.
12 📺 Diffusion & multimodal
TV चा static टप्प्याटप्प्याने साफ करत तुमच्या शब्दांकडे.
static ने भरलेला जुना TV आठवा. training साठी खरे फोटो घ्या आणि फक्त static उरेपर्यंत टप्प्याटप्प्याने noise टाका; model टाकलेला noise ओळखायला शिकतो. नवे चित्र बनवायला पूर्ण static पासून सुरू करा आणि साधारण 20 ते 50 वेळा noise काढा; प्रत्येक पायरी तुमच्या शब्दांनी दिशा घेते, उदा. 'मुकुट घातलेली मांजर'. multimodal म्हणजे चित्रे आणि आवाज सुद्धा tokens बनतात.
next-token text model चित्र काढू शकत नाही, म्हणून a cat with a crown सारखे शब्द चित्रात बदलायला नवी कल्पना लागते.
diffusion म्हणजे TV static टप्प्याटप्प्याने तुमच्या शब्दांकडे स्वच्छ करणे; multimodal म्हणजे images आणि audio सुद्धा tokens बनतात.
training 1000 steps मध्ये noise घालते आणि तो ओळखायला शिकते; generating ~20–50 वेळा noise काढते, prompt च्या दिशेने.
prompt ची अर्थ-जागा प्रत्येक step ला दिशा देते, आणि तीच desk व तेच attention आता चित्रे आणि आवाज हाताळतात.
इथे मुख्य कोर्स संपतो; MCP वरचा bonus lesson AI apps खऱ्या tools आणि data ला कसे जोडतात ते दाखवतो.
13 🔌 बोनस: MCP
युनिव्हर्सल प्लग — खोल कोर्स: learn-mcp-school 🔌
एकेकाळी प्रत्येक phone ला स्वतःचा charger लागायचा, मग एका universal plug ने ते सोडवले. MCP हा AI apps आणि tools मधील universal plug आहे: files, GitHub किंवा तुमचा database सारखा tool एकदाच MCP server म्हणून लिहिला जातो, आणि MCP बोलणारा प्रत्येक AI app तो वापरू शकतो. app server ला विचारतो की त्याच्याकडे कोणते tools आहेत, एक tool बोलावतो, आणि निकाल model च्या desk वर येतो.
standard शिवाय प्रत्येक AI app ला प्रत्येक tool साठी वेगळा adapter लागतो, म्हणून N apps आणि M tools म्हणजे N×M adapters.
MCP म्हणजे AI apps आणि tools मधील universal plug; प्रत्येक server त्याचे tools, resources आणि prompts जाहीर करतो.
host tools/list ने शोधतो, tools/call ने बोलावतो, आणि result desk वर येतो; L11 चा agent loop, standard केलेला.
N×M adapters चे N+M plugs होतात: tool एकदा लिहा आणि Claude Desktop, IDE किंवा तुमच्या स्वतःच्या agent मधून वापरा.
MCP school (learn-mcp-school) अधिक खोलात जाते, server आणि host सुरुवातीपासून, message by message बनवते.